
1 첫 차수의 접촉 대상에 미치는 영향을 기준으로 보고서 항목 선정
자금 모집팀은 긴 명단의 후보 전원과 동시에 접촉할 수 없다. 경영진의 가용 시간으로는 첫 차수에 수십 명에게 연락할 수 있고, 분석팀은 그보다 조금 큰 후보 명단을 확인할 수 있다. 투자자 선별 보고서는 각 후보에 대해 알려진 정보를 기록하며 수십 개 항목을 담을 수 있다. 이 연구는 어떤 항목을 확인하면 우선 접촉 대상이 바뀌며, 어떤 항목을 확인하면 애초에 출자 약정을 할 수 없는 후보가 제외되는지 묻는다. 두 결정에 영향을 주지 않는 항목은 비용만 발생시킨다.
이 질문을 모의실험으로 분석한다. 명시된 입력값으로 투자자 1,500명의 명단을 만들고 각 투자자에게 일부 오류를 포함한 공급업체 형태의 기록을 부여한다. 기록을 바탕으로 후보 300명을 추린 뒤 75명을 접촉 대상으로 선정한다. 8개 항목은 각각 정해진 비용으로 확인할 수 있다. 실험은 각 항목의 확인이 한 차수에서 서명된 출자 약정의 기대 건수에 얼마나 기여하는지 측정한다. 실제 접촉 기록은 사용하지 않았으며, 모든 수치는 명시한 가정에 따른 모형 결과다.
먼저 공개된 규정과 연구를 토대로 분석의 틀을 세운다 [1, 2, 3, 4, 6, 8, 10, 11, 12]. 이어 평가 지표를 정의하고 모의실험과 스트레스 테스트를 수행하며, 실제 팀에서 연구를 반복하는 데 필요한 데이터 규모를 산정한다. 마지막으로 현장 연구 설계, 보고 양식, 의사결정 기준을 제안한다. 항목 순위는 가정한 가중치에 따라 달라진다. 실험은 전제가 성립할 때 방법이 어떻게 작동하는지 보여 주며, 전제의 타당성은 별도로 검증해야 한다.
2 접촉 규모를 고정하고 항목을 탈락과 순위 변경 효과로 구분
의사결정의 대상은 명단에서 뽑은 75명의 접촉 대상이다. 최종 결과는 투자자가 서명한 출자 약정의 건수이며, 서명 시점에 기록한다. 사전에 정한 요건을 충족하는 미팅은 중간 결과로 집계한다. 항목의 실제 값을 알게 되어 후보 구성이 달라지고 약정 기대 건수 증가의 가치가 확인 비용을 넘으면 그 항목은 유용하다. 후보 구성을 바꾸지 못하는 항목은 설명에 유용하더라도 의사결정에는 기여하지 않는다.
핵심 항목은 두 가지 방식으로 작동한다. 통과 조건을 충족하지 못하면 해당 제안에 출자 약정을 할 수 없다. 투자자가 법적으로 제안을 받을 수 없거나, 위임 범위에 맞지 않거나, 투자 금액이 허용 범위를 벗어나거나, 자문사를 통한 접촉을 받지 않는 경우가 이에 해당한다. 이를 확인하면 제외할 후보를 알 수 있다. 순위 변수는 기준을 충족한 후보의 출자 약정 확률에 영향을 주므로, 확인 결과에 따라 접촉 순서가 바뀐다. 대리 지표는 통과 조건의 충족 여부나 순위 변수를 예측하지만 관련 항목이 확인되면 추가 정보가 없다. 마지막으로 일부 설명 항목은 예측력이 없다.
표 1은 모의실험에 포함된 12개 항목을 제시한다. 8개 항목은 비용을 들여 출처를 확인할 수 있고, 나머지 4개는 공급업체가 통상 별도 확인 없이 제공하는 설명 항목이다. 표에 기재된 항목별 역할은 모의 데이터 생성에 사용한 가정이다. 실제 보고서는 이 역할을 데이터로 검증해야 한다. 뒤에서 연구 설계를 제시한다.
가로로 스크롤하면 모든 열을 볼 수 있습니다.
| 항목 | 확인 출처 | 실험에서의 역할 | 영향을 받는 결정 |
|---|---|---|---|
| 제안을 받을 자격 | 분류 증빙 또는 규제상 지위 | 통과 조건 | 제외 |
| 투자 위임 범위가 전략과 지역을 허용함 | 공개 투자 정책 또는 투자 위임 문서 | 통과 조건 | 제외 |
| 투자 금액 범위 및 집중도 한도 | 공개 한도, 펀드 규모, 배정 범위 | 통과 조건 | 제외 |
| 자문사를 통한 접촉 허용 | 공개 조달 또는 모집 정책 | 통과 조건 | 제외 |
| 의사결정자 파악 | 별도 출처에서 해당 인물의 직책 확인 | 순위 변수 | 순서 변경 |
| 전략 및 투자 단계 적합도 | 최근 약정 검토 | 순위 변수 | 순서 변경 |
| 최근 유사 출자 약정 | 펀드 모집 완료 공시 및 투자자 명단 | 순위 변수 | 순서 변경 |
| 관계의 깊이 | 내부 접촉 기록 및 거래 이력 | 순위 변수 | 순서 변경 |
| 투자자 유형 | 공급업체 기록 | 기준 충족 확률의 대리 지표 | 예비 선별 |
| 규모(운용자산) | 공급업체 기록 | 금액 기준과 투자 활동의 대리 지표 | 예비 선별 |
| 직원 수 | 공급업체 기록 | 규모와 상관되나 독립적인 예측력이 없는 설명 항목 | 없음 |
| 대외 인지도 | 공급업체 기록 | 규모와 상관되나 독립적인 예측력이 없는 설명 항목 | 없음 |
항목의 역할은 모의실험의 입력값이다. 확인 출처는 팀이 참고할 수 있는 문서의 예다.
3 투자자가 공개한 규정으로 일부 통과 조건 확인 가능
2026년 7월 1일부터 시행된 캘리포니아 공무원 퇴직연금(CalPERS) 투자 정책은 검증 가능한 투자 금액 한도의 예다. 부록 4는 단일 펀드의 출자 약정 한도를 해당 펀드 규모의 35%로 정한다. 한 운용사(GP)에 대한 순약정자본 합계는 사모주식 프로그램 전체 순약정자본의 15%로 제한되며 예외에는 위원회의 별도 승인이 필요하다 [11, 14]. 두 비율의 산정 기준은 다르다. 펀드별 한도만 적용해도 미화 4,000만 달러를 약정하려면 펀드 규모가 최소 약 1억 1,430만 달러여야 한다. 이 계산만으로 남은 투자 한도나 투자 의향을 알 수는 없다.
미국 규칙 506(c)는 매수자가 적격 투자자여야 하며 발행자가 그 지위를 확인하기 위해 합리적인 조치를 취하도록 요구한다. 이 규정은 해당 면제에 따른 매수에 적용되며 접촉 경로는 각각 평가해야 한다 [8]. 규칙 501(a)(1)의 적격 투자자 범주 중 하나에는 주 또는 규정에서 정한 산하기관, 당국이나 기구가 설립하고 유지하며 총자산이 미화 500만 달러를 넘는 공무원 급여 제도가 포함된다 [9]. 두바이 금융서비스청(DFSA)의 영업행위 규정은 소매 고객을 기본 분류로 하고 전문 고객으로 간주하는 범주를 정한다. 대기업 여부는 최신 재무제표를 기준으로 판단하며, 총자산 미화 2,000만 달러, 연간 순매출 미화 4,000만 달러, 자기자금 또는 납입을 청구한 자본금 미화 200만 달러 중 두 가지 이상의 기준을 충족해야 한다 [10].
이 자료는 투자자의 자격과 금액 적합성을 문서화된 기준과 투자자에 관한 증빙에 따라 확인할 수 있음을 보여 준다. 의무는 접촉 경로와 관할권에 따라 다르므로 특정 자문사나 발행자가 접촉 명단에 해당 규정을 적용해야 하는지는 이 자료만으로 결정할 수 없다. 기준 충족의 기초 확률도 제시되지 않는다. 따라서 실험은 충족 확률을 입력값으로 사용한다. 표 2는 각 규정이 보고서에 요구하는 정보를 정리한다.
가로로 스크롤하면 모든 열을 볼 수 있습니다.
| 출처 | 규정 또는 한도 | 보고서에 담을 정보 | 문서 상태 |
|---|---|---|---|
| CalPERS PERF 사모주식 투자 정책 [11, 14] | 단일 펀드 한도 35%; 프로그램 내 단일 GP 한도 15%, 예외는 위원회 승인 필요 | 펀드 규모, 예정 투자액, 해당 GP에 대한 기존 익스포저 | 2026년 7월 1일 시행 |
| 미국 규칙 506(c) [8] | 모든 매수자가 적격 투자자여야 하며 합리적인 확인 절차 필요 | 자격 증빙 및 날짜 | 2026년 10월에 열람한 eCFR 현행 조문 |
| 미국 규칙 501(a) [9] | 자산이 미화 500만 달러를 넘는 적격 공무원 급여 제도를 포함 | 자격 범주 및 자산 증빙 | 2026년 10월에 열람한 eCFR 현행 조문 |
| DFSA 영업행위 규정 [10] | 소매 고객이 기본 분류이며 전문 고객 간주 범주와 대기업 판정 기준을 제시 | 고객 분류 및 최신 재무제표 | 2026년 7월 제51판, 열람 시점 현행 |
인용 문서에 관한 Matchpoint의 요약이다. 문서의 상태는 본문에 설명했다. 특정 투자 제안에 대한 법적 결론을 제시하지 않는다.
4 사용하는 항목만 보관하고 각 항목의 출처와 날짜 기록
선별 보고서 항목은 접촉 시점에 정확해야 쓸모가 있다. Kaplan과 Lerner는 비상장 자본시장 상업용 데이터베이스를 검토한 결과, 범위와 정의가 서로 다르고 자발적 보고에 의존하며 사후 자료 추가나 표본 선택에 따른 편향이 있다고 밝혔다. 플랫폼마다 펀드를 설정 연도별로 묶는 방식이 세 가지로 나뉘고, 여러 자산군에 투자하는 동일한 투자자를 다르게 분류할 수 있다. 저자들은 방법의 차이 때문에 특히 거래 단위 데이터에서 불일치가 자주 발생한다고 지적한다 [6]. 이 연구는 2016년의 벤처캐피털 데이터를 다룬다. 동일 투자자의 기록 두 건이 다를 수 있다는 점은 보여 주지만 그 빈도는 측정하지 않는다.
보고서에는 무엇을 근거로 확인했는지가 명시돼야 한다. 각 항목에 출처, 열람 날짜, 확인자를 기록할 것을 제안한다. 지난 90일 안에 공개 투자 정책과 대조한 위임 범위와 공급업체의 분류를 그대로 옮긴 기록에는 서로 다른 근거가 있다. 모의실험에서는 공급업체의 기록이 오차를 포함하며 확인된 값은 정확하다고 가정한다. 스트레스 테스트에서는 두 번째 가정을 완화한다.
개인정보에는 별도의 제약이 있다. 영국 일반개인정보보호규정 제5조 제1항은 개인정보가 적절하고 관련성이 있으며 처리 목적에 필요한 범위로 제한돼야 한다고 규정한다. 또한 정확해야 하며 필요한 경우 최신 상태를 유지해야 한다 [12]. 따라서 이름이 명시된 의사결정자에 관한 항목에는 정해진 목적이 있어야 한다. 두바이 국제금융센터(DIFC)의 2020년 개인정보보호법 제9조 제1항도 관련성, 최소화, 정확성 및 필요한 경우 최신 상태 유지에 대해 상응하는 요건을 둔다 [15]. 아부다비 글로벌마켓의 규정은 검토하지 않았으며, 이 원칙들을 적용하기 전에 현지 자문이 필요하다. 실무에서는 표 1의 의사결정 가치가 없는 개인정보 항목을 보관하지 않는다.
유한책임사원(LP)은 운용사에 묻는 질문을 표준화해 왔다. 2021년 11월 갱신된 ILPA 실사 설문 2.0판은 20개 주제를 다루는 자발적 도구다. 개별 설문을 작성하는 부담을 줄이기 위해 만들어졌다 [13]. 이번 검토에서는 자금 모집팀이 투자자의 어떤 정보를 확인해야 하는지에 관한 상응하는 기준을 찾지 못했다. 이 보고서는 제안이며, 항목 선정의 근거는 모의실험이다.
5 가장 유사한 현장실험은 제안에 대한 관심을 설명하며, 투자자 속성의 출자약정 예측력은 검증하지 않았다
연구 질문에 가장 가까운 실증 연구는 스타트업과 엔젤투자자를 연결하는 플랫폼에서 실시한 무작위 현장실험이다. 연구진은 약 4,500명의 투자자에게 약 17,000통의 이메일을 보내고, 각 이메일에 포함하는 정보를 무작위로 배정했다. 투자자들은 창업팀 정보에 강하게 반응했고, 사업 진척이나 기존 주도 투자자 정보에는 뚜렷한 반응을 보이지 않았다. 검토한 2014년 3월 초안에서 이 효과는 주로 경험이 가장 많은 투자자에게서 나타났으며, 경험이 가장 적은 투자자들은 모든 정보 범주에 반응했다. 이 초안에서는 팀 정보를 공개하자 약 16.5%였던 클릭률이 2.6%포인트 상승했고, 클릭한 투자자 중 2.98%가 이후 실제로 투자했다. [1]
이 실험의 무작위 배정 대상은 제안의 속성이었다. 제안에 대한 반응을 비교하는 실험 설계에서 조작할 수 있는 요인이기 때문이다. 본고가 살펴보는 투자자 속성은 자금 모집 주체가 무작위로 배정할 수 없다. 연구가 기록한 결과는 클릭, 소개 요청, 보고된 투자였으며, 펀드 출자약정의 서명 여부는 측정하지 않았다. 연구진은 기존 데이터베이스에 성사된 거래만 있고 투자자가 검토했던 전체 스타트업 집단은 포함되지 않아 투자 대상 선정 과정을 평가할 수 없다고 지적한다. [1] 2017년 Journal of Finance 게재본의 초록에도 창업팀에 관한 동일한 결과가 실려 있다. 게재본 전문은 확인하지 않았으므로 위 수치는 초안에 따른 것이며, 최종 게재 수치와 다를 수 있다.
설문조사는 응답자가 밝힌 선호를 보여 준다. 681개사의 벤처캐피털 투자자 885명을 대상으로 한 설문에서 응답 기업의 95%가 경영진을 중요한 선정 요인으로 꼽았으며, 해당 펀드와의 적합성은 상대적으로 중요도가 낮았다. [2] 이는 투자자가 투자 대상 기업을 평가할 때 중요하다고 밝힌 기준이다. 유한책임출자자가 운용사를 상대로 실제로 어떤 행동을 하는지는 보여 주지 않는다. 유한책임출자자의 유형별 수익률을 비교한 한 연구에서는 유형 간 차이가 컸으며, 기금 투자자의 수익률이 평균보다 약 14% 높았다. 이 연구의 대상은 투자 성과이며, 접촉에 대한 반응은 별도로 다루지 않았다. [7]
이들 연구가 보여 주는 것은 제안 정보에 따라 투자자의 관심이 달라지고, 경험 수준이 그 반응에 영향을 주며, 투자자 유형이 다른 종류의 결과와 관련된다는 점이다. 어느 투자자 속성이 펀드 출자약정을 예측하는지는 이들 연구로 확인할 수 없다. 본고의 문헌 검색에서는 그 질문을 직접 검증한 현장실험을 찾지 못했다. 검색 결과만으로 관련 실험이 없다고 단정할 수는 없다. 아래에서는 가상 사례로 이 공백을 다루고, 후반부에서는 실제 자료로 검증하기 위한 연구 설계를 제시한다.
6 정보가치 분석으로 측정하고 변수선택 이론으로 중복을 점검한다
정보가치 분석은 정보를 구매하기 전에 그 경제적 가치를 평가하는 방법이다. 보건경제학에서 일부 모수에 대한 완전정보의 기대가치는 해당 모수의 정확한 값을 알 때 얻는 이익을 측정한다. 이는 한정된 자료에 근거해 해당 모수를 연구할 때 얻을 수 있는 가치의 상한이다. Heath와 Baio는 표본정보의 기대가치를 제안된 연구에서 얻는 평균 이익으로 설명한다. 두 저자는 해당 모수에 관한 완전정보의 상한을 먼저 산정하도록 권고한다. 상한이 낮을 경우 해당 모수를 연구할 가치가 없다는 판단을 내릴 수 있기 때문이다. [4] 이 연구는 보건의료기술 평가를 다루며, 본고에서는 판단 논리만 적용한다.
동일한 의사결정 모형에서 속성을 정확히 알 때의 기대편익은 같은 접촉 결정에 덜 정확한 정보를 사용할 때의 기대편익의 상한이다. Bindels와 공동 저자들은 네덜란드의 의료비 상환 결정에서 이해관계자들이 정보가치의 타당성을 인정하지만 실제 활용은 드물다고 보고했다. 모형의 구조적 불확실성을 무시하면 결과가 편향될 수 있다는 점도 지적했다. [5] 본고의 결과는 가정한 모형 구조 안에서만 성립하며, 구조가 달라지면 정보가치도 달라진다.
변수선택 이론은 항목별 가치를 따로 측정할 때 생기는 한계를 보여 준다. Guyon과 Elisseeff에 따르면 서로 중복되는 변수가 있을 때 각 변수의 순위를 개별적으로 매기는 방식은 예측모형을 구축하는 데 대체로 최선이 아니다. 단독으로는 도움이 되지 않는 변수도 다른 변수와 함께 사용하면 예측력이 높아질 수 있으며, 각각의 기여가 없는 두 변수도 결합하면 가치가 생길 수 있다. [3] 보고서에서 중복은 단독으로 유용해 보이는 항목이 다른 항목을 이미 알고 있으면 추가 정보를 주지 않는 경우다. 상호보완은 단독으로는 가치가 없어 보이는 항목이 다른 항목과 결합할 때 유용해지는 경우다. 이에 따라 각 항목을 단독으로 검증할 때, 마지막으로 검증할 때, 그리고 가능한 전체 검증 순서에 걸쳐 평균을 낼 때의 가치를 각각 측정한다.
이 문헌은 측정 기준의 근거를 제공한다. 특정 투자자 속성에 얼마의 가치가 있는지는 제시하지 않는다. 이하의 수치는 모두 본고에서 설정한 모형 입력값을 바탕으로 산출했다.
7 추정 대상: 각 정보 집합에서 동일한 접촉 규모로 얻을 출자약정의 기대 건수
투자자 i가 출자약정에 서명할 확률을 식 (1a)의 p_i로 둔다. 이 확률은 통과 여부를 나타내는 지표 G_i와 지수 η_i에 대한 프로빗 항의 곱이다. 식 (1b)의 지수는 표준정규분포를 따르는 순위 결정 변수 S와 하나의 이진 변수 D를 가중합한 것이다. 적격 미팅에는 동일한 지수를 쓰되 더 낮은 임계값을 적용한다. 순위 산정 모형이 이 구조와 입력 가중치를 알고 있다고 가정한다. 따라서 산출 결과는 실무팀이 얻을 수 있는 성과에 대한 낙관적인 기준이다. 실제로는 팀이 가중치를 추정해야 하며, 그 과정에서 오차가 생긴다.
식 (1)의 Φ는 표준정규 누적분포함수이며, τ_c는 출자약정의 임계값 2.90이다. 미팅의 임계값은 1.20이다. g_ig는 투자자 i가 자격 E, 투자 위임 범위 M, 투자 금액 T, 접촉 경로 R 가운데 조건 g를 충족하면 1이다. S_ik는 전략 적합성, 최근 출자약정, 관계의 깊이를 나타내는 k번째 순위 결정 변수다. D_i는 의사결정권자가 확인된 경우 1이다. b_k와 b_D에 적용하는 가중치는 위 변수 순서대로 0.70, 0.40, 0.50, 0.50이다. 통과 조건 중 하나라도 충족하지 못하면 순위 결정 항목의 점수와 관계없이 투자자의 확률은 0이다.
순위 산정 모형은 여덟 가지 항목 중 검증을 마친 항목을 사용하고, 나머지는 정보업체의 기록으로 대체해 후보 투자자별 점수를 계산한다. 점수가 가장 높은 75명을 접촉 대상으로 선정한다. V(A)는 이들에게 해당하는 모형상의 실제 출자약정 확률을 합산한 값이다. 정보업체 기록만 사용해 선정한 접촉 대상의 기대 건수와 비교해, 정보 집합별 개선 폭을 측정한다.
8 통과율, 가중치, 검증 비용을 설정한 가상의 투자자 1,500명 명단
명단에는 여섯 유형에 속하는 투자자 1,500명이 있다. 표 3과 같이 각 유형의 조건별 통과 확률은 서로 다르다. 규모가 큰 투자자일수록 투자 금액 조건을 충족할 가능성이 높다. 순위를 결정하는 변수는 표준정규분포를 따르며, 최근 출자약정과 투자자 규모 간 상관계수는 0.6이다. 의사결정권자가 확인되는 비율은 투자자 유형에 따라 35%에서 70% 사이다. 각 통과 확률을 곱하는 구조를 적용하면, 이 입력값에서는 전체 명단의 약 26%만 출자약정을 할 수 있다. 입력값은 모형 실험에서 비교할 수 있도록 설정했으며, 실제 투자자 집단을 추정한 값이 아니다.
가로로 스크롤하면 모든 열을 볼 수 있습니다.
| 투자자 유형 | 비중 | 적격성 | 투자 위임 범위 | 투자 금액 | 접촉 경로 | 의사결정권자 확인 |
|---|---|---|---|---|---|---|
| 공적연기금 | 15% | 0.95 | 0.45 | 0.65 | 0.70 | 0.50 |
| 국부펀드 또는 국가기관 | 10% | 0.97 | 0.55 | 0.60 | 0.75 | 0.35 |
| 패밀리오피스 | 35% | 0.80 | 0.70 | 0.75 | 0.95 | 0.70 |
| 재간접펀드 | 15% | 0.90 | 0.50 | 0.70 | 0.85 | 0.60 |
| 재단 | 10% | 0.92 | 0.40 | 0.55 | 0.60 | 0.50 |
| 보험사 | 15% | 0.93 | 0.30 | 0.60 | 0.70 | 0.45 |
가상 실험에 설정한 입력값이며, 투자자 규모가 평균일 때의 확률이다. 규모가 커질수록 투자 금액 조건의 통과 확률이 높아진다. 시장 관측치는 아니다.
모든 투자자에 대해 정보업체의 기록이 있지만 여기에는 오차가 있다. 각 통과 조건에 대한 기록이 맞을 확률과 순위 결정 변수의 오차 수준은 표 4와 같다. 관계의 깊이는 정보업체가 제공하는 자료가 아니라 자금 모집 주체의 자체 기록에 속하므로, 기록상 오차가 가장 크다. 검증하면 오차가 있는 기록을 정확한 값으로 대체한다. 검증에는 표에 제시한 분석 담당자의 시간이 들며, 시간당 미화 60달러를 적용하면 여덟 항목 모두를 검증하는 비용은 후보 투자자당 미화 135달러다.
가로로 스크롤하면 모든 열을 볼 수 있습니다.
| 항목 | 지수에서의 역할 | 기록 정확도 또는 오차 | 검증 소요 시간(분) | 지수 가중치 |
|---|---|---|---|---|
| 제안 수신 자격 | 통과 조건 | 0.90 | 20 | 통과 조건 |
| 위임 범위에 전략과 지역이 포함됨 | 통과 조건 | 0.75 | 30 | 통과 조건 |
| 투자 금액 범위 및 집중 한도 | 통과 조건 | 0.80 | 15 | 통과 조건 |
| 자문사를 통한 접촉 허용 | 통과 조건 | 0.70 | 10 | 통과 조건 |
| 의사결정권자 확인 | 이진 변수 | 0.65 | 15 | 0.50 |
| 전략 및 투자 단계 적합성 | 표준정규 변수 | 표준편차 1.0 | 25 | 0.70 |
| 최근 유사 출자약정 | 표준정규 변수 | 표준편차 0.8 | 15 | 0.40 |
| 관계의 깊이 | 표준정규 변수 | 표준편차 1.2 | 5 | 0.50 |
모형에 설정한 입력값이다. 검증 소요 시간은 후보 투자자 1인당 분석 담당자가 투입하는 시간(분)이며, 시간당 미화 60달러를 적용했다. 실제 관측된 비용은 아니다.
9 베이즈 규칙으로 정보업체 기록에 투자자 유형과 규모를 반영하고, 검증값이 있으면 기록을 대체한다
순위 산정 모형은 정보업체 기록과 투자자를 설명하는 항목을 함께 활용한다. 각 조건에 대한 사전 통과 확률은 투자자 유형과 규모에 따라 정하고, 식 (2a)의 오즈 갱신 규칙으로 정보업체의 기록을 반영한다. 순위 결정 변수 가운데 최근 출자약정은 투자자 규모에 따라 사전 평균을 정하며, 식 (2b)의 정규분포 갱신 규칙으로 오차가 있는 기록을 반영한다. 검증된 항목은 오차가 없는 값으로 취급한다. 이 설계는 정보업체 기록만을 활용한 비교 기준이 주어진 정보 안에서 최대한 높은 성과를 내도록 한다. 비교 기준이 약해 검증 효과가 부풀려지는 문제를 줄이기 위해서다.
π_ig는 투자자 i가 조건 g를 통과할 사전 확률이며, 기호 위에 모자 표시를 붙인 값은 사후 확률이다. a_g는 정보업체 기록의 정확도다. 기록이 통과로 표시되면 지수는 양의 1, 탈락으로 표시되면 음의 1이다. μ_0과 v_0은 순위 결정 변수의 사전 평균과 분산이다. r은 오차가 포함된 관측값이고, σ는 오차의 표준편차다. 모자 표시가 붙은 평균과 분산은 사후 평균과 사후 분산이다. 최종 점수는 식 (3a)와 같이 조건별 통과 확률과 프로빗 항의 기대값을 곱해 계산한다.
식 (3)에서 모자 표시가 붙은 g는 조건의 사후 통과 확률이며, 검증된 경우에는 1 또는 0이다. 같은 표시가 붙은 q는 의사결정권자가 확인될 사후 확률이다. μ와 σ의 제곱에 각각 적용한 모자 표시는 순위 결정 변수에 대한 지수의 평균과 분산을 나타낸다. W(A)는 점수가 가장 높은 K명의 집합이다. 제곱근이 포함된 식은 정규 확률변수에 표준정규 누적분포함수를 적용한 값의 기대값이, 해당 확률변수의 평균을 분산에 1을 더한 값의 제곱근으로 나눈 지점에서의 표준정규 누적확률과 같다는 항등식에 따른다. 모형은 이 관계를 수치 적분으로 확인한다.
10 무작위 선정과 출자 확률 상위 집단을 모형의 비교 기준으로 삼는다
가상 명단 전체에서 무작위로 75명을 뽑아 접촉하면 출자약정의 기대 건수는 0.66건이다. 전체 명단에서 실제 모형 확률이 가장 높은 75명의 확률을 합하면 10.76건이다. 이 비교 기준은 완전정보를 전제로 한다. 정보업체 기록만으로 순위를 정하면 출자약정 5.14건(접촉 건수의 6.9%)과 적격 미팅 24.3건이 기대된다. 후보 명단의 항목을 모두 검증하면 출자약정 9.31건(12.4%)과 적격 미팅 47.2건이 기대된다. 표 5는 이 결과를 비교한다.
가로로 스크롤하면 모든 열을 볼 수 있습니다.
| 비교 기준 | 출자약정 기대 건수 | 접촉 대비 비율(%) | 적격 미팅 기대 건수 |
|---|---|---|---|
| 전체 명단에서 무작위 선정 | 0.66 | 0.9 | 해당 없음 |
| 정보업체 기록만을 최대한 활용해 선정 | 5.14 | 6.9 | 24.3 |
| 후보 명단의 여덟 항목 모두 검증 | 9.31 | 12.4 | 47.2 |
| 후보 명단에서 출자 확률이 가장 높은 집단 | 9.31 | 12.4 | 해당 없음 |
| 전체 명단에서 출자 확률이 가장 높은 집단 | 10.76 | 14.3 | 해당 없음 |
가상 명단에 대한 MatchPoint 분석이다. 제시된 입력값에 따른 모형 결과이며, 관측된 실적은 아니다. 200회 반복 실행 결과의 기대값이다.
기본 시뮬레이션에서 검증이 정확하고 통과 조건이 그대로라면, 모든 항목을 검증했을 때 후보 명단 내에서 출자 확률이 가장 높은 집단과 동일하게 출자약정 9.31건이 기대된다. 전체 명단을 기준으로 한 기대 건수는 10.76건이다. 이 차이는 모형에서 검증 범위를 후보 명단으로 한정한 효과를 나타낸다. 전체 항목을 검증하면 정보업체 기록만으로 순위를 매길 때보다 기대 건수가 4.17건, 즉 81% 늘어난다. 반복 실행에서 이 증가분의 표준편차는 0.81이며, 평균의 95% 구간에서 반폭은 0.11이다. 무작위 선정은 비교 기준이 되며, 일부 접촉 집단의 점수는 무작위 선정 기준보다 낮을 수 있다.
이 결과는 순위 산정 모형이 가중치와 정보업체 기록의 정확도를 알고 있다는 전제에 따른다. 두 값을 모르는 실무팀은 동일한 기록에서 얻는 효과가 더 작고, 검증에서 얻는 효과는 더 클 수 있다. 스트레스 시나리오에서는 이 변화의 방향과 크기를 수치로 제시한다.
11 기록만으로 선정한 접촉 대상 10명 중 약 4명은 통과 조건을 충족하지 못해 출자약정을 할 수 없다
정보업체 기록만으로 선정한 접촉 대상은 겉보기에 적절하다. 그러나 75명의 후보 가운데 42%가 적어도 하나의 조건을 충족하지 못해 이 제안에 출자약정할 수 없다. 가장 큰 요인은 투자 위임 범위로, 전체의 24%가 이 조건을 충족하지 못한다. 이어 투자 금액 11%, 접촉 경로 9%, 적격성 5% 순이다. 그림 1에 조건별 비율을 표시했다. 캠페인 기록만으로는 이들이 응답하기 전까지 탈락 여부를 알기 어렵고, 그때는 이미 접촉 기회를 쓴 뒤다.
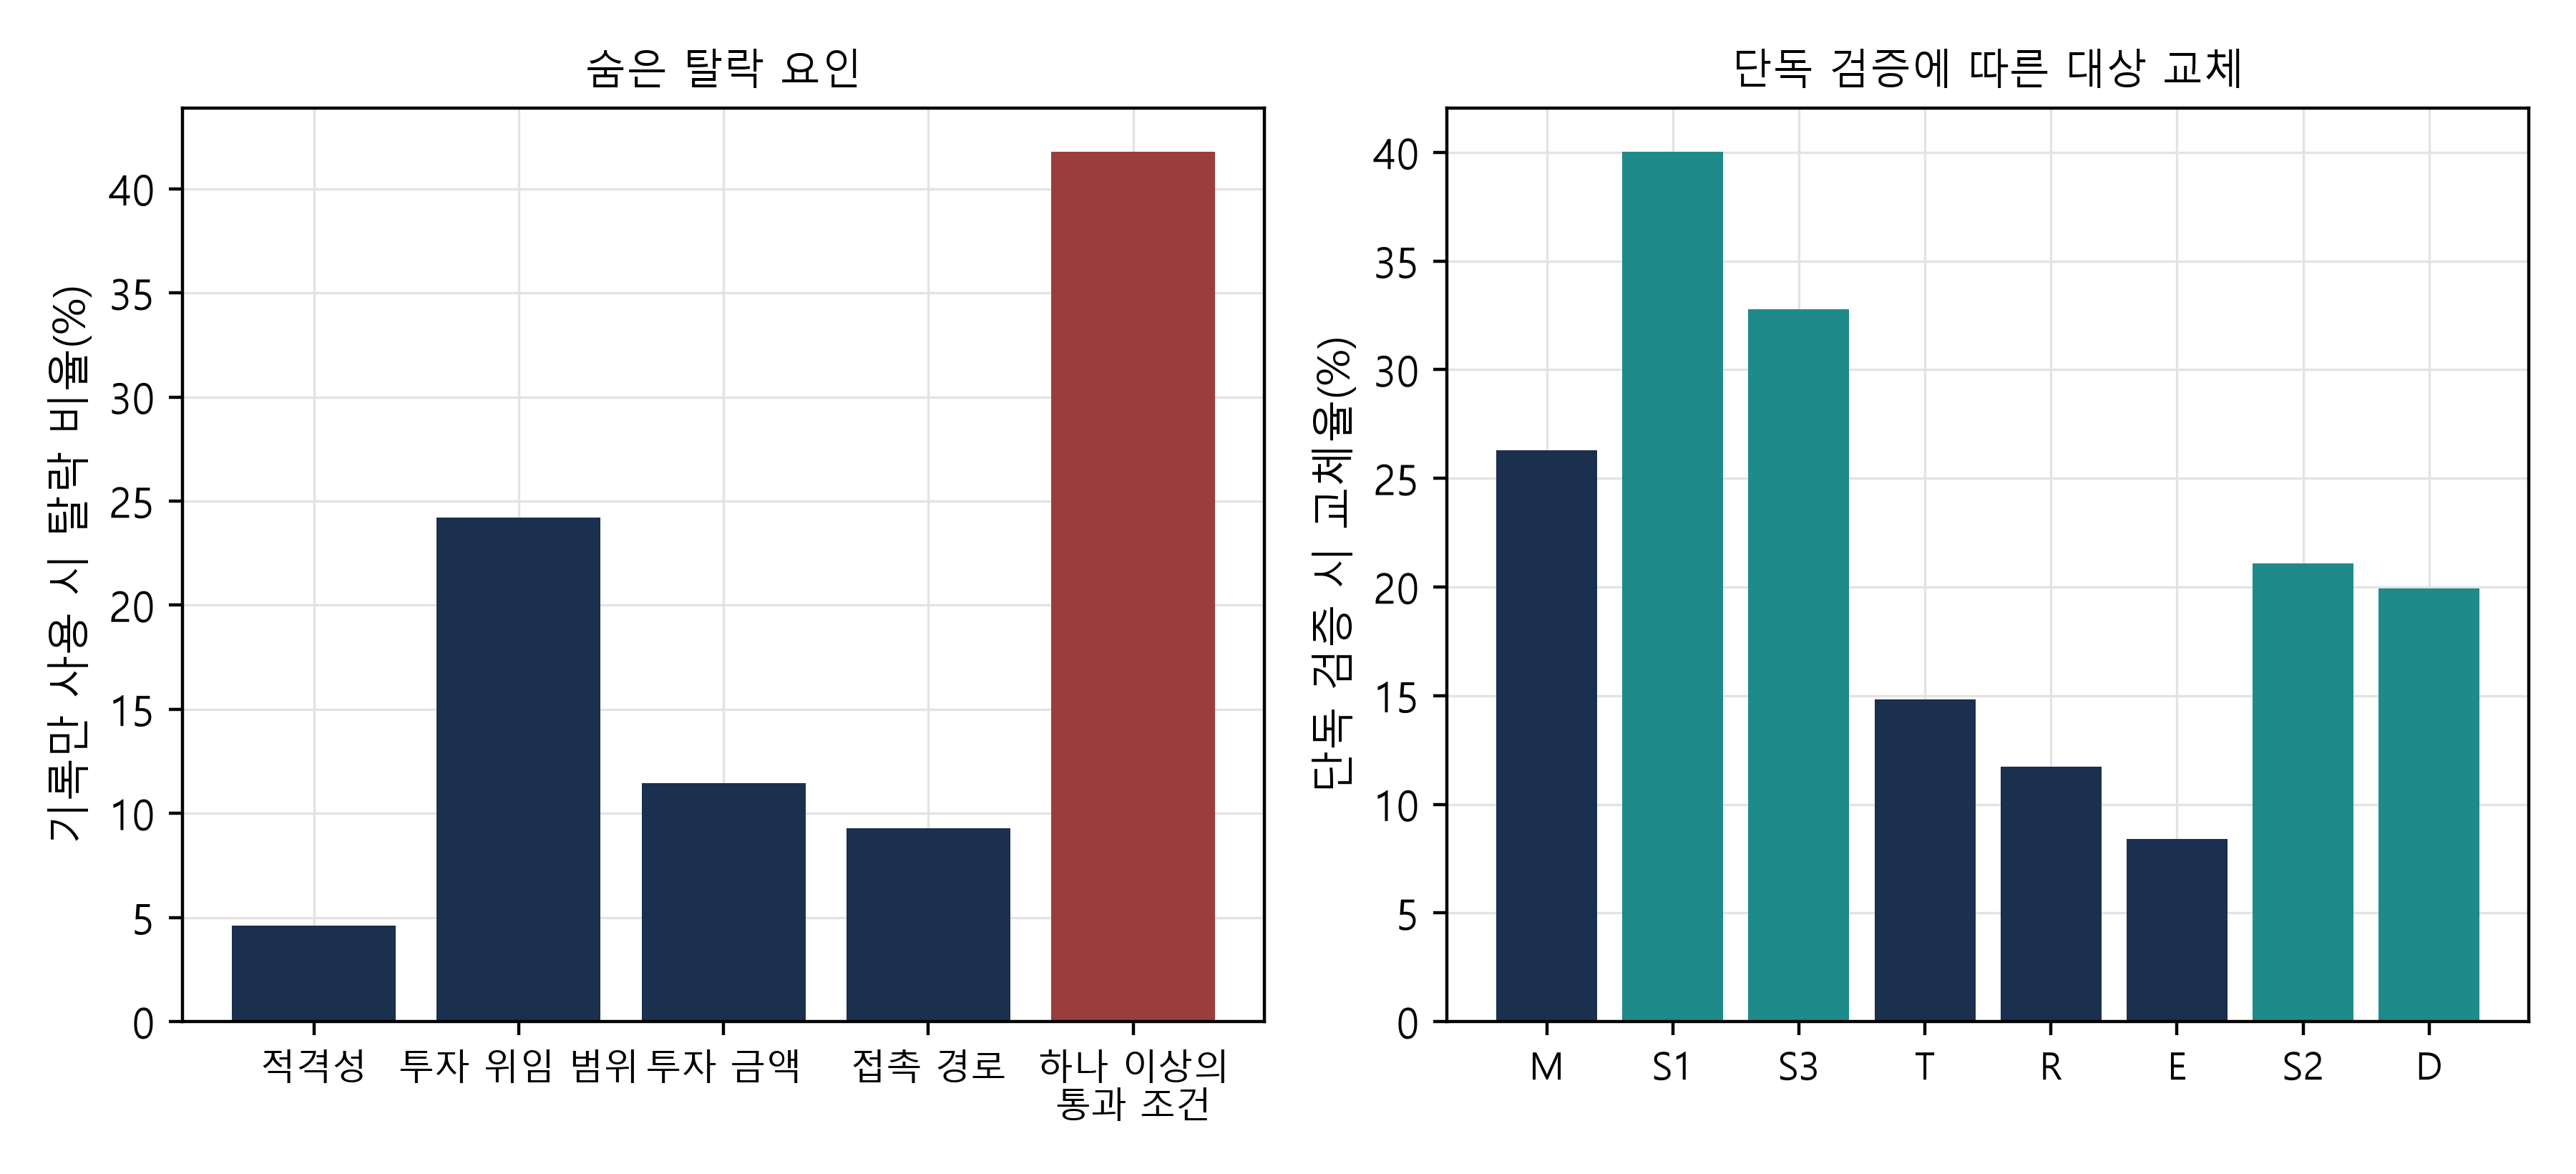
가상 명단에 대한 MatchPoint 분석이다. 제시된 입력값에 따른 모형 결과이며, 관측된 실적은 아니다. 왼쪽: 기록만으로 선정한 집단에서 각 조건을 충족하지 못한 비율. 오른쪽: 각 항목만 따로 검증할 때 접촉 대상이 교체되는 비율.
두 번째 효과는 순위가 바뀐다는 점이다. 전략 적합성만 검증하면 접촉 대상의 40%가 바뀌고, 관계의 깊이만 검증하면 33%, 투자 위임 범위만 검증하면 26%가 바뀐다. 통과 조건 네 가지를 모두 검증하면 43%, 여덟 항목을 모두 검증하면 58%가 교체된다. 기본 입력값에서는 네 가지 통과 조건을 검증한 뒤 접촉 대상 중 어느 누구도 조건을 위반하지 않는다. 반면 세 가지 순위 결정 변수만 검증하면 접촉 대상의 47%는 여전히 출자약정을 할 수 없다. 이 경우 순위 산정 모형은 점수가 높아도 통과 조건을 충족하지 못하는 후보를 집중적으로 선정하기 때문에 해당 비율이 42%에서 오른다. 항목별 결과는 표 6에 제시했다.
가로로 스크롤하면 모든 열을 볼 수 있습니다.
| 검증 항목 | 기록만으로 선정한 집단의 조건별 탈락 비율 | 접촉 대상 교체 비율 | 검증 후에도 출자약정을 할 수 없는 접촉 대상 비율 |
|---|---|---|---|
| 위임 범위에 전략과 지역이 포함됨 | 24% | 26% | 25% |
| 전략 및 투자 단계 적합성 | 해당 없음 | 40% | 45% |
| 관계의 깊이 | 해당 없음 | 33% | 44% |
| 투자 금액 범위 및 집중 한도 | 11% | 15% | 35% |
| 자문사를 통한 접촉 허용 | 9% | 12% | 37% |
| 제안 수신 자격 | 5% | 8% | 39% |
| 최근 유사 출자약정 | 해당 없음 | 21% | 43% |
| 의사결정권자 확인 | 해당 없음 | 20% | 42% |
| 통과 조건 네 가지 모두 검증 | 어느 한 조건 이상 탈락: 42% | 43% | 0% |
| 여덟 항목 모두 검증 | 어느 한 조건 이상 탈락: 42% | 58% | 0% |
가상 명단에 대한 MatchPoint 분석이다. 제시된 입력값에 따른 모형 결과이며, 관측된 실적은 아니다. 탈락 비율은 검증 시점에 기록만으로 선정한 집단을 기준으로 측정했다. 교체 비율도 기록만으로 선정한 집단을 기준으로 산정했다.
모형에 따르면 자금 모집 주체가 통과 조건을 검증하지 않으면 접촉 대상 10명 중 약 4명은 출자약정을 할 수 없다. 75건의 접촉 가운데 적격성 조건을 충족하지 못한 3.5건은 규제상 위험을 수반한다. 모형에서 집계하는 출자약정 건수에는 이 위험의 비용이 포함되지 않는다. 따라서 적격성을 확인하는 가치는 출자약정 수만으로 계산한 값보다 크며, 뒤에서 제시하는 손익분기 수치는 그 가치를 충분히 반영하지 못한다.
12 설정한 가중치에서는 투자 위임 범위와 전략 적합성이 전체 가치의 약 절반을 차지하며, 단독 검증값을 합하면 전체 이익이 과대평가된다
표 7은 각 항목의 가치를 세 가지 방식으로 제시한다. 단독 검증값은 해당 항목만 확인할 때 얻는 이익이다. 마지막 검증값은 모든 항목이 검증된 보고서에서 해당 항목을 제외할 때 잃는 가치다. 식 (4a)의 섀플리 값은 가능한 모든 검증 순서에서 한계 이익을 평균한 값이며, 식 (4b)와 같이 항목별 값을 합하면 전체 이익이 된다.
J는 여덟 가지 항목의 집합, A는 그 부분집합, V는 식 (3b)에 정의한 접촉 집단의 기대 출자약정 건수다. 투자 위임 범위의 섀플리 값은 출자약정 1.098건(전체 이익의 26%)이며, 전략 적합성은 1.001건(24%)이다. 두 항목을 합하면 전체 이익의 약 절반이다. 두 값은 서로 가깝고 각각에 대한 구간은 계산하지 않았으므로, 어느 한 항목이 우위에 있다고 판단할 수 없다. 다음은 관계의 깊이 0.599건, 투자 금액 0.481건, 접촉 경로 0.342건, 적격성 0.252건, 최근 출자약정 0.213건, 의사결정권자 확인 0.184건 순이다. 그림 2는 각 항목의 세 가지 검증값을 보여 준다.
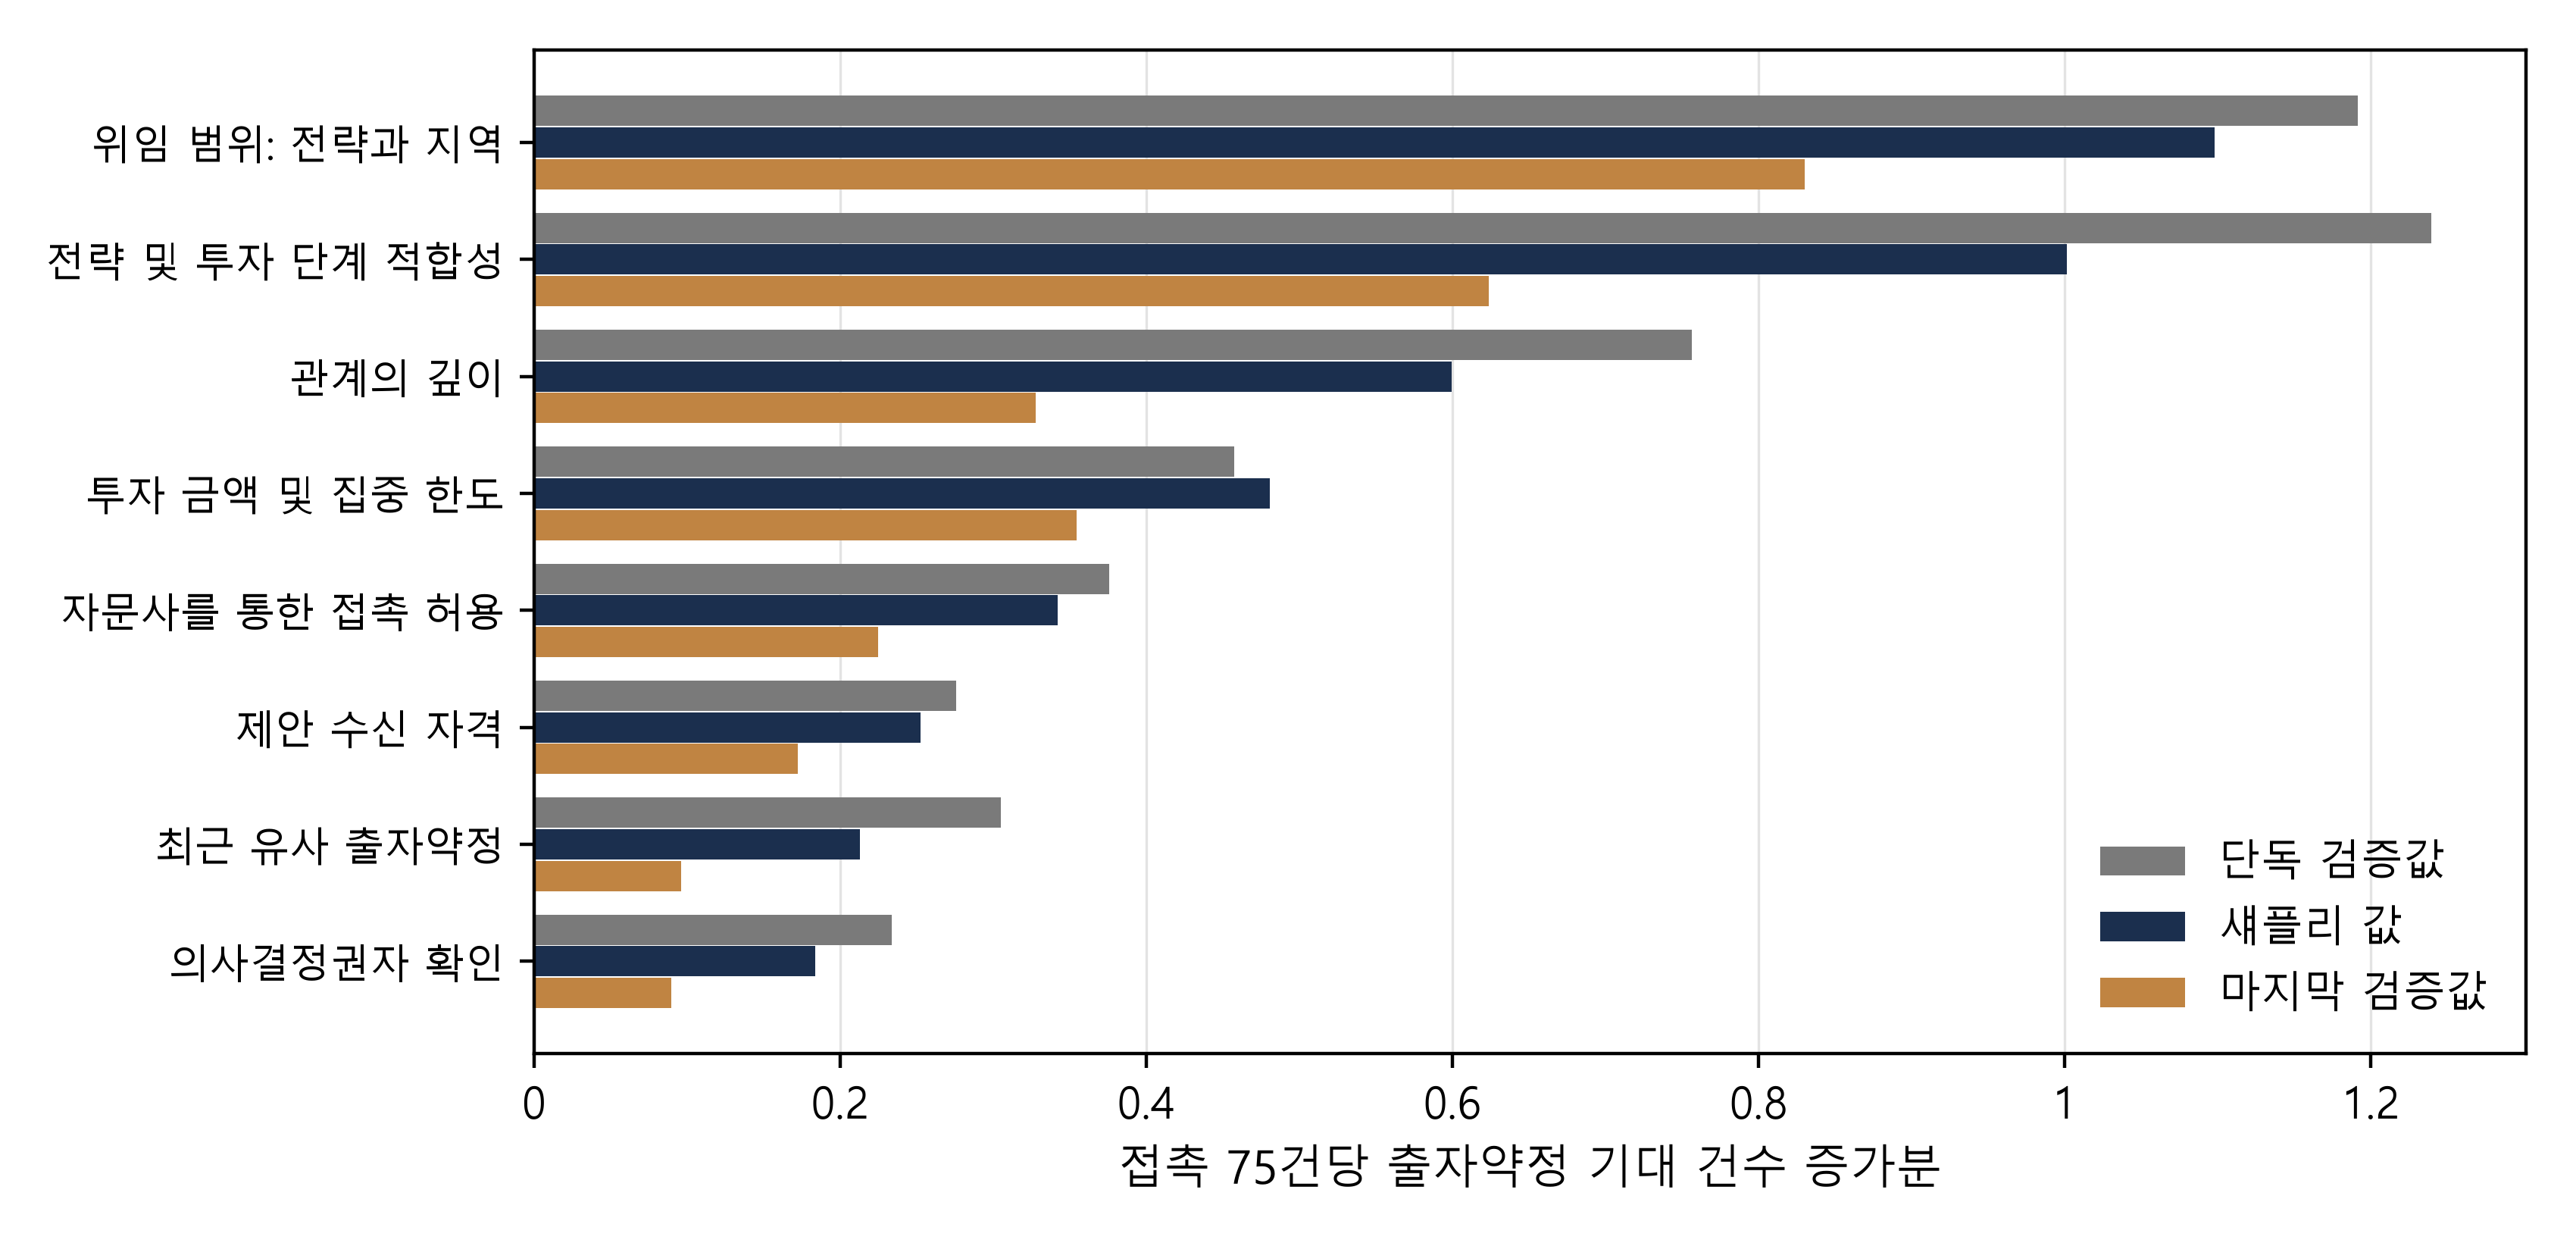
가상 명단에 대한 MatchPoint 분석이다. 제시된 입력값에 따른 모형 결과이며, 관측된 실적은 아니다. 75건을 접촉할 때 출자약정 기대 건수의 증가분이다.
가로로 스크롤하면 모든 열을 볼 수 있습니다.
| 항목 | 단독 검증값 | 마지막 검증값 | 섀플리 값 | 전체 이익 중 비중 | 출자약정당 손익분기 가치(미화 달러) |
|---|---|---|---|---|---|
| 위임 범위에 전략과 지역이 포함됨 | 1.191 | 0.830 | 1.098 | 26% | 8,197 |
| 전략 및 투자 단계 적합성 | 1.239 | 0.624 | 1.001 | 24% | 7,491 |
| 관계의 깊이 | 0.757 | 0.328 | 0.599 | 14% | 2,502 |
| 투자 금액 범위 및 집중 한도 | 0.457 | 0.354 | 0.481 | 12% | 9,363 |
| 자문사를 통한 접촉 허용 | 0.376 | 0.225 | 0.342 | 8% | 8,767 |
| 제안 수신 자격 | 0.276 | 0.172 | 0.252 | 6% | 23,775 |
| 최근 유사 출자약정 | 0.305 | 0.096 | 0.213 | 5% | 21,159 |
| 의사결정권자 확인 | 0.234 | 0.090 | 0.184 | 4% | 24,512 |
가상 명단에 대한 MatchPoint 분석이다. 제시된 입력값에 따른 모형 결과이며, 관측된 실적은 아니다. 손익분기점은 후보 명단을 검증하는 비용을 섀플리 값으로 나눈 값이다. 이는 출자약정 한 건의 가치가 그 금액을 넘어야 검증비를 회수할 수 있다는 뜻이다.
세 측정값의 차이는 이론이 예상하는 방향과 일치한다. 전체 이익은 4.17건인데, 단독 검증값을 합하면 4.83건, 마지막 검증값을 합하면 2.72건이다. 한 항목이 다른 항목을 부분적으로 대체하므로 단독 검증값의 합은 이익을 과대평가한다. 예를 들어 투자 위임 범위를 이미 확인했다면 투자 금액을 확인하는 가치가 줄어든다. 같은 이유로 마지막 검증값의 합은 이익을 과소평가한다. 가능한 검증 순서 전체의 평균을 사용해야 항목별 가치의 합이 전체 이익과 일치한다. 손익분기 열에서 출자약정 한 건의 가치가 자금 모집 주체에게 약 미화 24,512달러를 넘으면 모든 항목이 각자의 검증 비용을 회수한다. 검증 비용이 낮은 항목의 손익분기점은 약 미화 2,502달러부터다. 이 기준은 표 4의 검증 시간과 시간당 미화 60달러라는 가정에 따르며 출자약정만 집계한다. 실제 사업에서 이 기준을 충족하는지는 별도로 판단해야 한다.
13 다섯 항목으로 구성한 최소 보고서는 전체 비용의 3분의 2 미만으로 전체 이익의 90%를 확보한다
보고서의 여덟 항목을 모두 검증할 필요는 없다. 이미 검증한 항목을 고려해 비용 대비 한계 이익이 가장 큰 항목부터 하나씩 추가하는 탐욕적 방식을 적용했다. 이와 별도로 가능한 부분집합 256개를 모두 비교해 목표에 도달하는 최저 비용 조합을 찾았다. 항목을 하나씩 추가하는 순서는 S3, S1, R 등이며, 표 8과 그림 3에 제시했다. 관계의 깊이는 검증에 5분만 들어 가장 먼저 추가된다. 투자 위임 범위는 30분이 소요돼 뒤에 추가된다.
식 (5)에서 L은 후보 명단의 크기, c_j는 후보 1인당 항목 j의 검증 비용, φ_j는 해당 항목의 섀플리 값, B_j는 출자약정 1건당 손익분기 가치, ρ_j(A)는 집합 A를 이미 검증한 상태에서 해당 항목을 추가할 때 비용 1달러당 이익이다. 전체 이익의 90%에 도달하는 최저 비용 조합은 M, T, R, S1, S3이다. 검증 비용은 미화 25,500달러로, 여덟 항목 모두를 확인하는 데 드는 미화 40,500달러의 63%다. 이익의 95%에 도달하려면 E, M, T, R, S1, S3가 필요하며, 비용은 전체의 78%다.
가로로 스크롤하면 모든 열을 볼 수 있습니다.
| 단계 | 추가 검증 항목 | 누적 비용(미화 달러) | 출자약정 기대 건수 | 전체 이익 대비 비율 |
|---|---|---|---|---|
| 1 | 관계의 깊이 | 1,500 | 5.90 | 18% |
| 2 | 전략 및 투자 단계 적합성 | 9,000 | 7.04 | 45% |
| 3 | 자문사를 통한 접촉 허용 | 12,000 | 7.40 | 54% |
| 4 | 위임 범위에 전략과 지역이 포함됨 | 21,000 | 8.46 | 79% |
| 5 | 투자 금액 범위 및 집중 한도 | 25,500 | 8.90 | 90% |
| 6 | 제안 수신 자격 | 31,500 | 9.11 | 95% |
| 7 | 최근 유사 출자약정 | 36,000 | 9.22 | 98% |
| 8 | 의사결정권자 확인 | 40,500 | 9.31 | 100% |
가상 명단에 대한 MatchPoint 분석이다. 제시된 입력값에 따른 모형 결과이며, 관측된 실적은 아니다. 비용은 후보 인원수에 1인당 분석 소요 시간(분)을 곱한 뒤 시간당 미화 60달러를 적용해 산정했다.
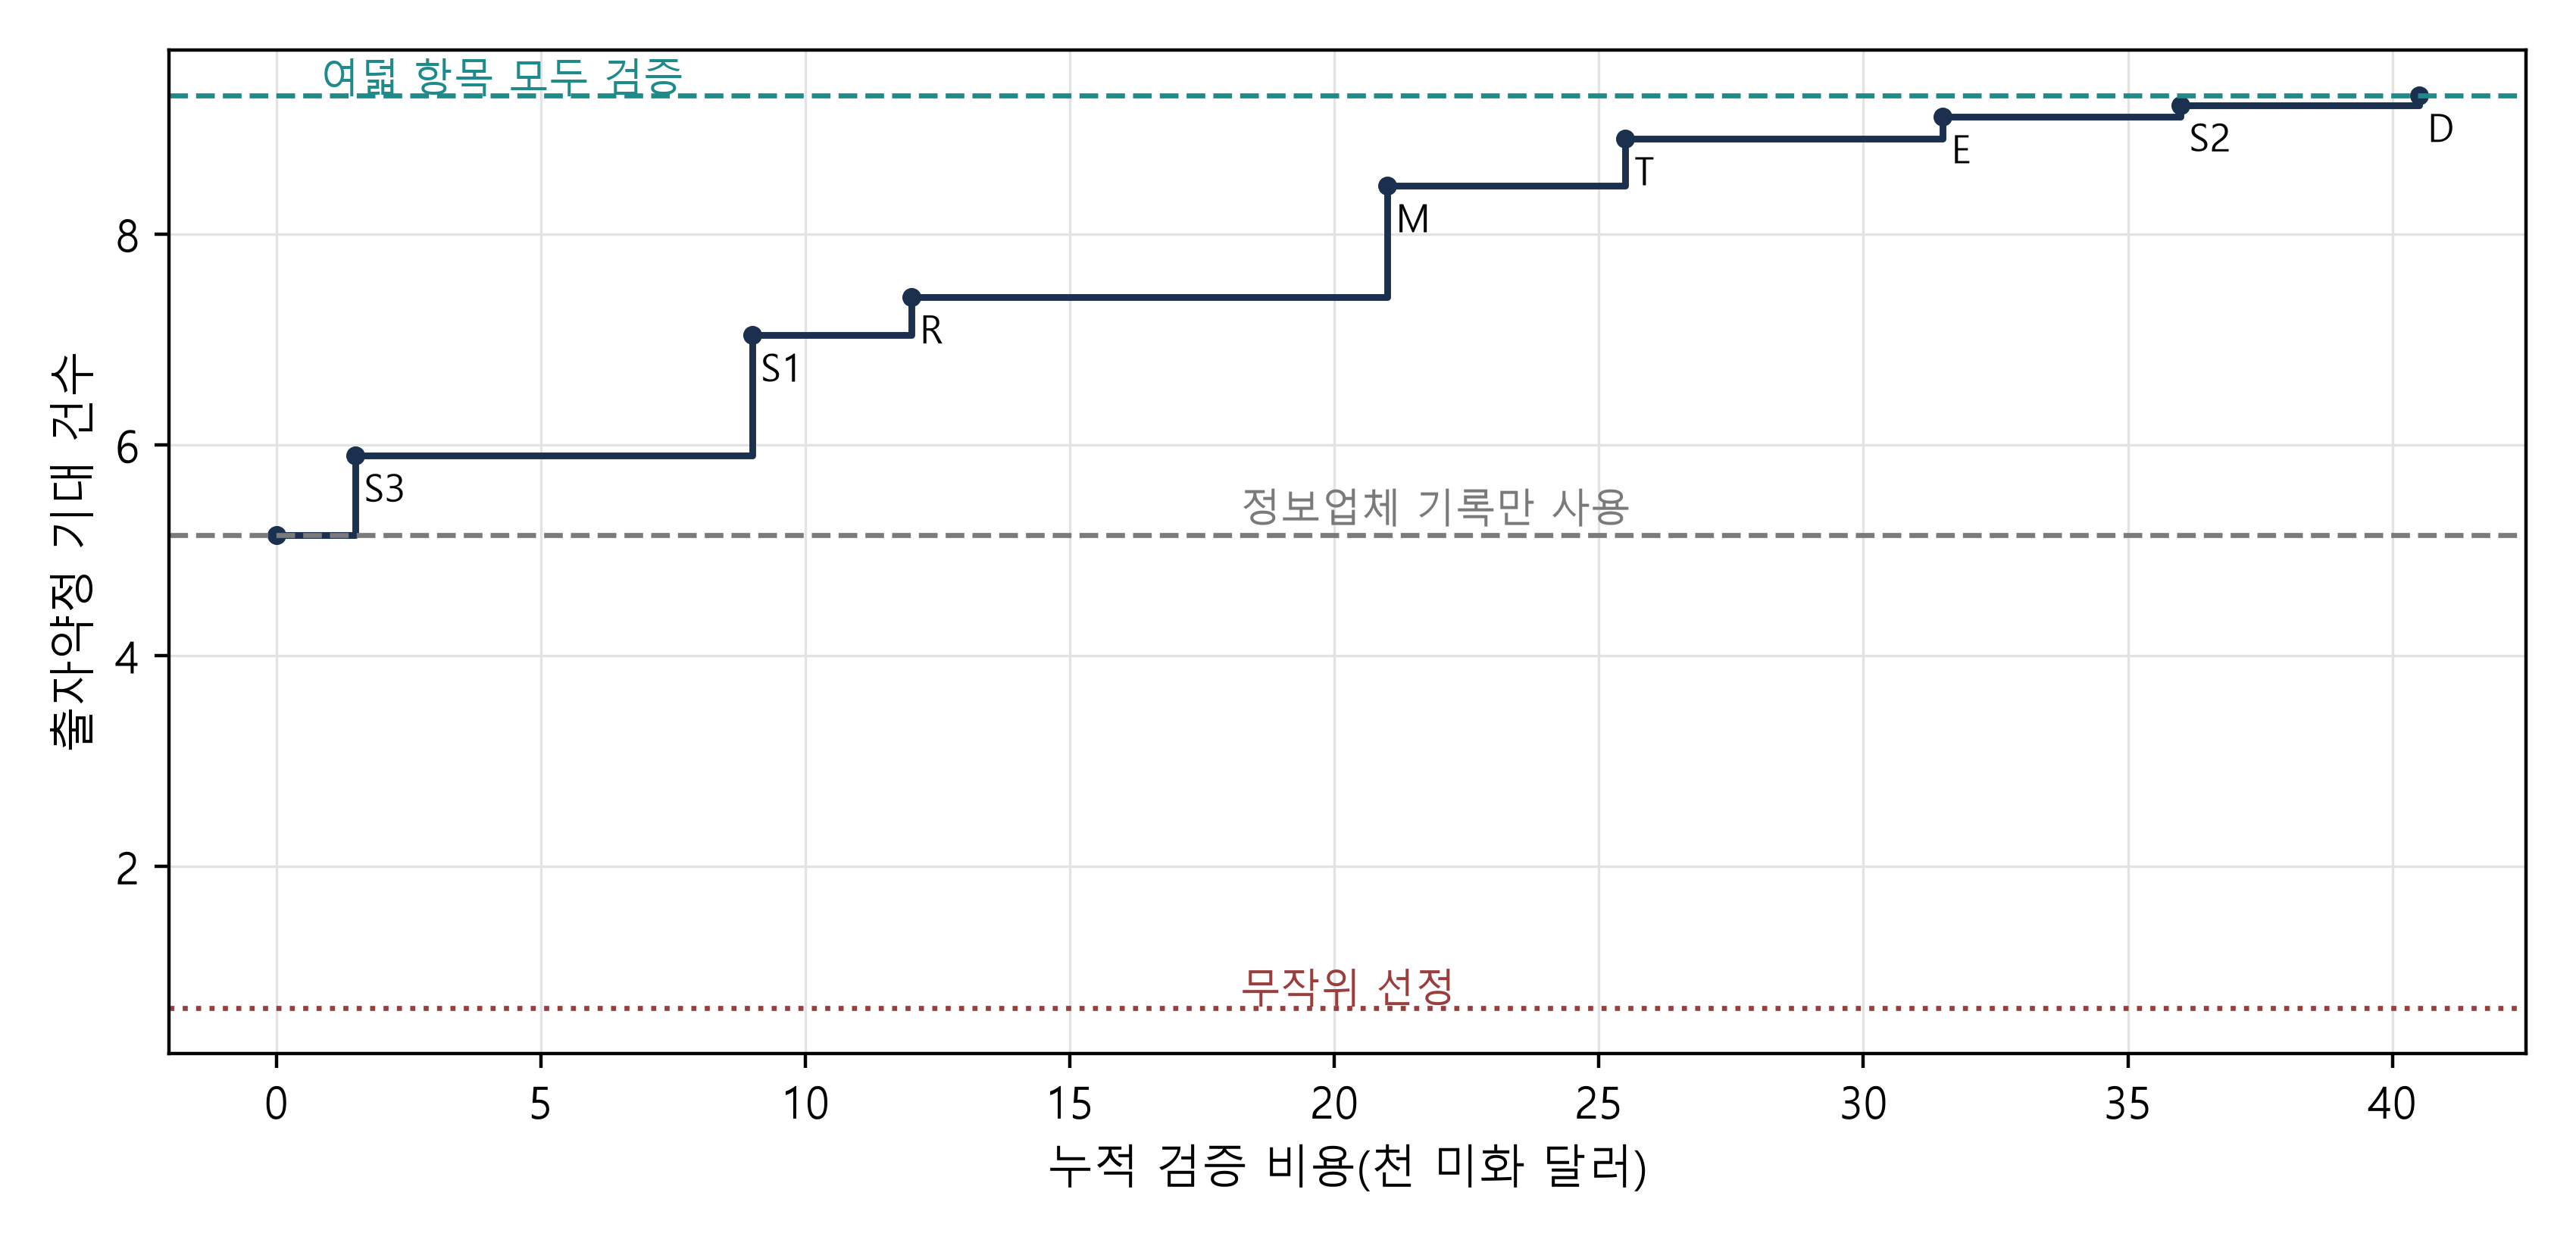
가상 명단에 대한 MatchPoint 분석이다. 제시된 입력값에 따른 모형 결과이며, 관측된 실적은 아니다. 비용 대비 한계 이익이 큰 순서로 항목을 추가했다. 파선은 기록만 사용한 경우와 전체 검증을 나타내고, 점선은 무작위 선정을 나타낸다.
항목을 추가할수록 이익이 서서히 줄어들며, 급격한 변화는 없다. 마지막 세 항목이 더하는 이익은 전체의 약 10분의 1이며 비용은 예산의 3분의 1을 넘는다. 이 최소 조합은 여기서 설정한 입력값에 따른 결과다. 실무적으로는 이미 확인한 정보를 고려해 비용 대비 추가 이익을 기준으로 다음 검증 항목을 선택할 수 있다. 고정된 보고서 양식대로 항목을 확인하면 이런 선택을 하기 어렵다.
14 가상 사례에서 설명용 항목은 검증 대상을 고르는 데 유용하며, 최종 순위에는 추가 정보가 되지 않는다
정보업체 기록에는 투자자 유형, 규모, 직원 수, 대외 인지도처럼 수집하기 쉬운 항목이 있다. 실험에서 유형에 따라 조건별 기본 통과율이 달라지고, 규모는 투자 금액 조건과 최근 출자 활동에 영향을 준다. 직원 수와 대외 인지도는 규모를 오차와 함께 반영하는 변수이며 독립적인 효과는 없다. 표 9와 그림 4는 각 항목을 단독으로 사용할 때, 정보업체 기록만 사용하면서 다른 세 항목에 마지막으로 추가할 때, 여덟 항목을 모두 검증하는 경우에 마지막으로 추가할 때의 가치를 각각 측정한다.
가로로 스크롤하면 모든 열을 볼 수 있습니다.
| 설명용 항목 | 기록만 활용, 단독 사용 | 기록만 활용, 마지막에 추가 | 전체 검증, 마지막에 추가(검증 대상 선별만) |
|---|---|---|---|
| 투자자 유형 | 0.390 | 0.348 | 0.275 |
| 규모(운용자산의 로그값) | 0.172 | 0.055 | 0.085 |
| 직원 수 | 0.119 | 0.000 | 0.000 |
| 대외 인지도 | 0.068 | 0.000 | 0.000 |
가상 명단에 대한 MatchPoint 분석이다. 제시된 입력값에 따른 모형 결과이며, 관측된 실적은 아니다. 75명에게 접촉할 때의 출자약정 기대 건수 증가분이다. 80회 반복했다. 세 번째 결과 열은 검증 후보 명단을 구성하는 과정에서만 생기는 가치를 측정한다.
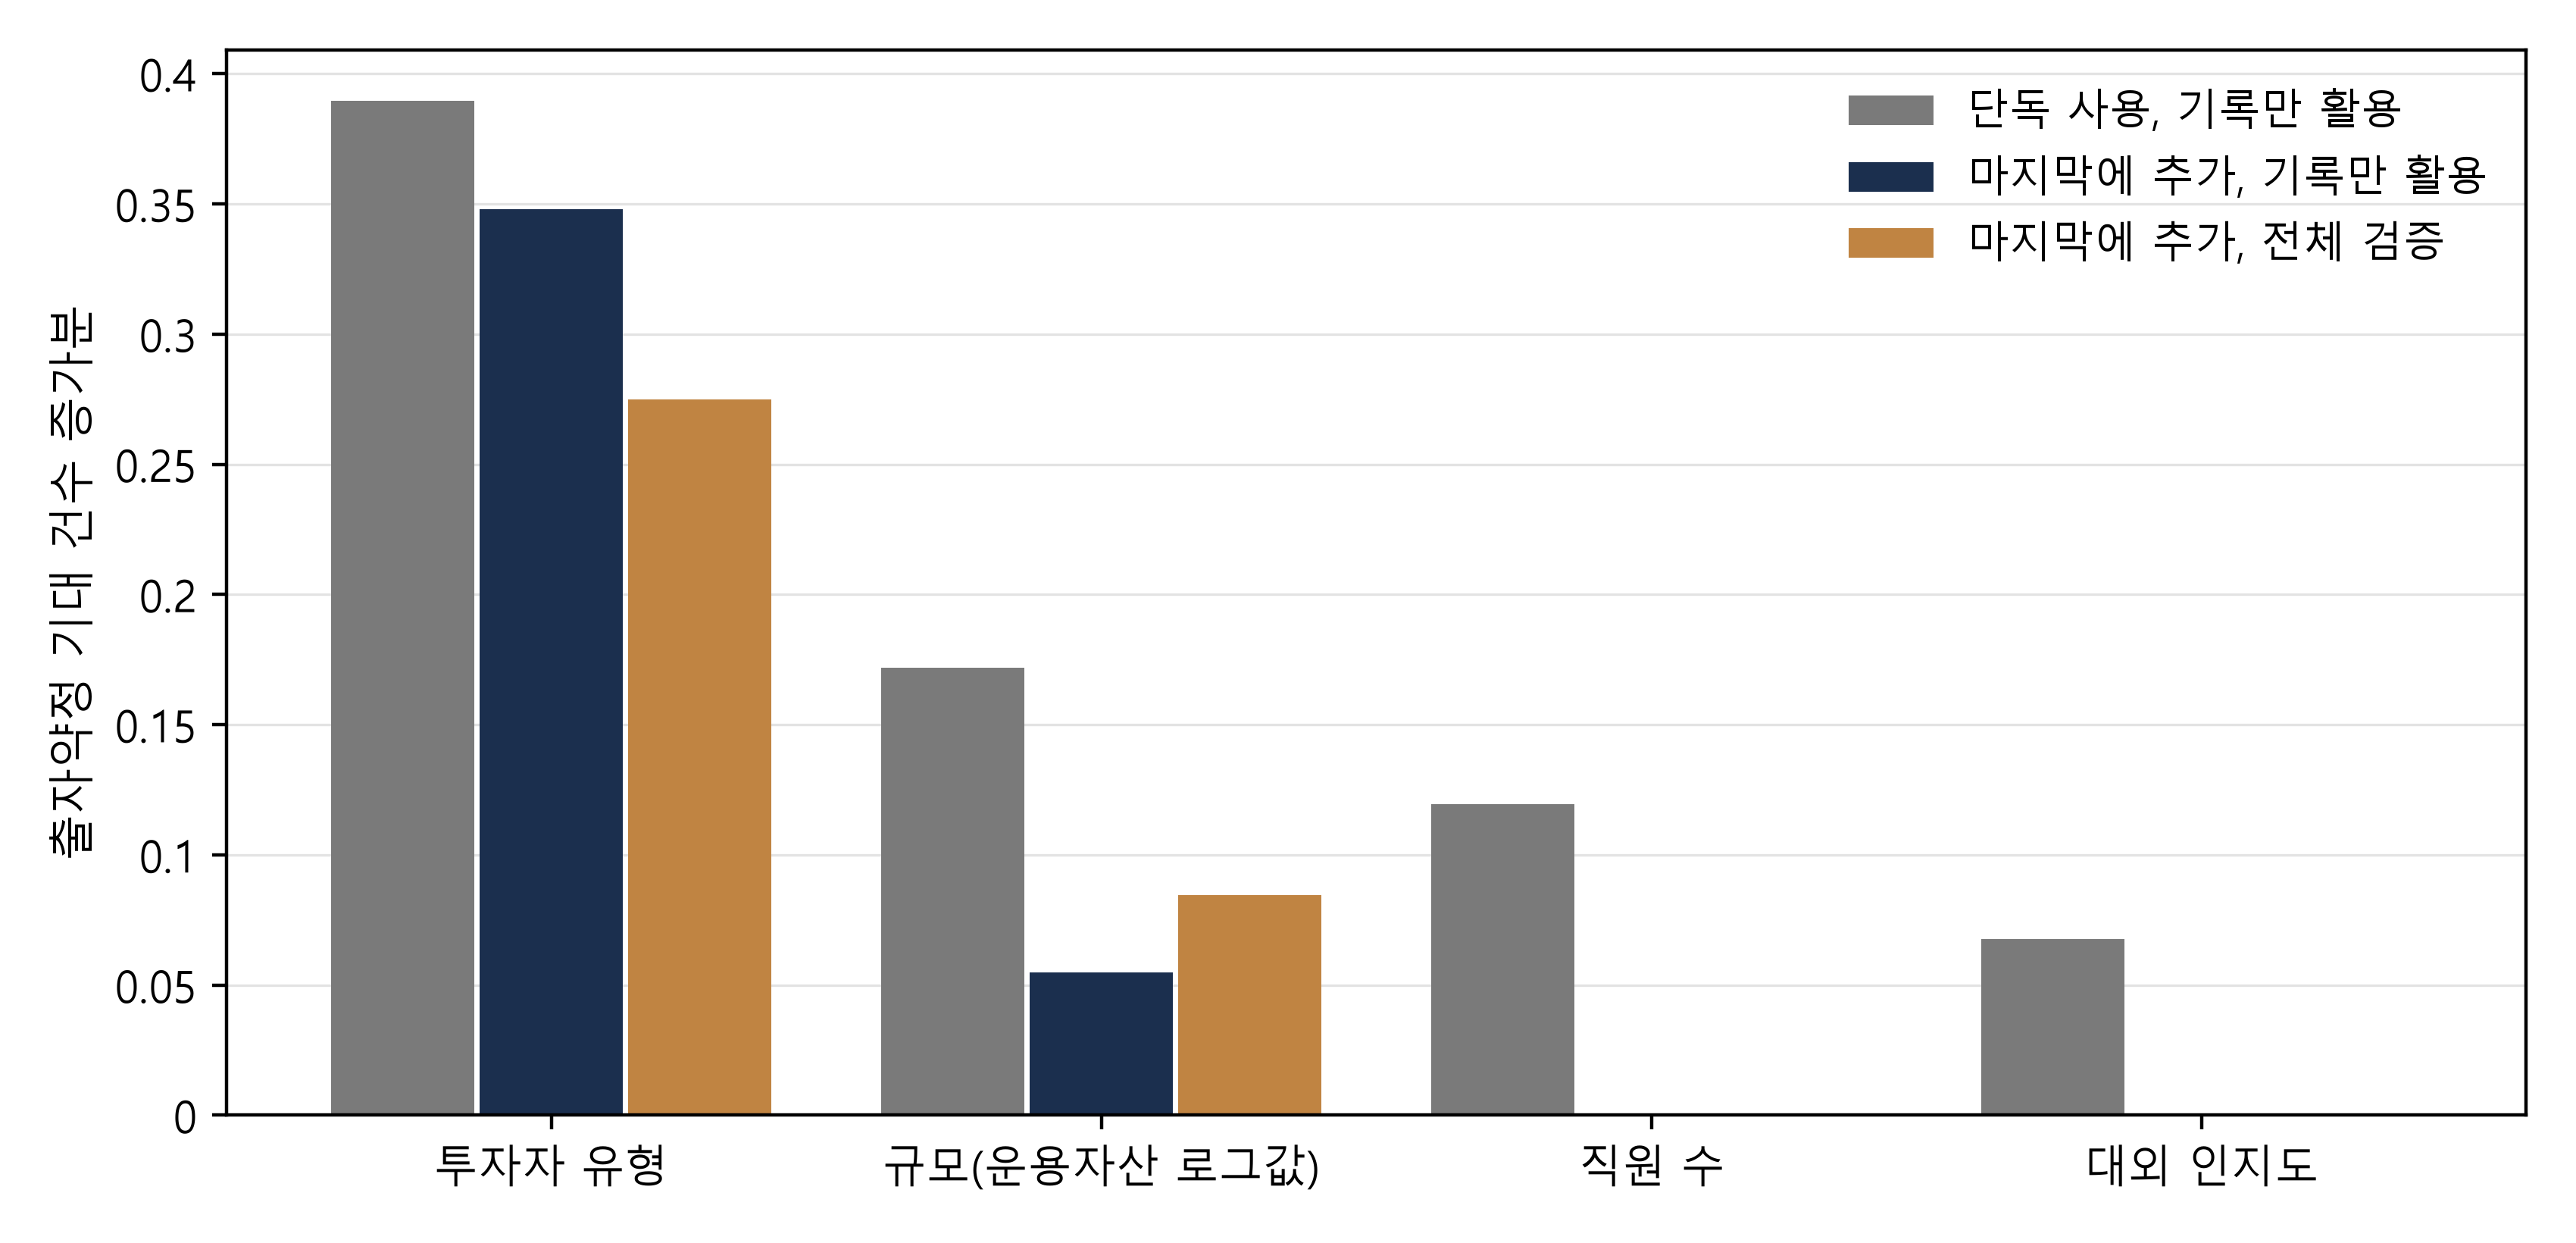
가상 명단에 대한 MatchPoint 분석이다. 제시된 입력값에 따른 모형 결과이며, 관측된 실적은 아니다. 설명용 항목과 정보 상태에 따른 출자약정 기대 건수 증가분이다.
각 항목을 단독으로 사용하면 출자약정 기대 건수는 유형으로 0.390건, 규모로 0.172건, 직원 수로 0.119건, 대외 인지도로 0.068건 증가한다. 직원 수와 인지도는 각각 규모의 대리변수이므로 단독으로는 유용해 보인다. 규모를 이미 파악한 뒤 두 항목을 각각 마지막으로 추가하면 효과는 0.000건과 0.000건이다. 유형을 마지막으로 추가하는 가치는 기록만 사용하는 경우 0.348건, 여덟 항목 모두를 검증하는 경우 0.275건이다. 후자의 효과는 검증 전에 후보 명단을 정하기 때문에 생긴다. 사전 정보가 좋아지면 검증할 대상을 더 잘 고를 수 있다. 이는 검증 대상 선별의 가치다. 규모도 같은 경로로 0.085건을 더한다.
결과는 두 가지 결정을 구분해 보여 준다. 투자자 유형과 규모는 분석 담당자가 시간을 투입할 후보를 고르는 데 도움이 된다. 통과 조건과 순위 결정 변수를 검증한 뒤에는 최종 접촉 대상을 정렬하는 데 추가로 기여하지 않는다. 보고서에서 직원 수와 인지도를 검증된 항목과 나란히 제시하면 독자가 이 사례에서 입증되지 않은 중요성을 부여할 수 있다. 실제 자료에서 이들 항목이 어떤 가치가 있는지는 아래의 연구 설계를 통해 검증할 문제다.
15 접촉 인원과 검증 후보 명단의 규모에 따라 중요한 항목이 달라진다
각 항목의 가치는 전체 후보 중 몇 명에게 접촉하는지에 따라 달라진다. 그림 5에서는 검증 후보 명단을 300명으로 고정하고 접촉 인원을 바꿨다. 25명에게 접촉할 때 순위 결정 변수 세 가지는 기대 출자약정을 1.51건, 통과 조건 네 가지는 1.42건 늘린다. 이 경우 순위 조정과 부적격 후보 제외의 효과가 비슷하다. 150명에게 접촉할 때 통과 조건의 효과는 2.50건, 순위 결정 변수의 효과는 1.72건이다. 접촉 인원이 적으면 명단 상위에서 대상을 충원할 수 있어 순위 조정의 중요성이 부적격 후보 제외와 비슷하다. 접촉 인원이 많으면 통과 조건을 충족하지 못할 후보까지 포함되므로 이들을 걸러내는 효과가 더 크다.
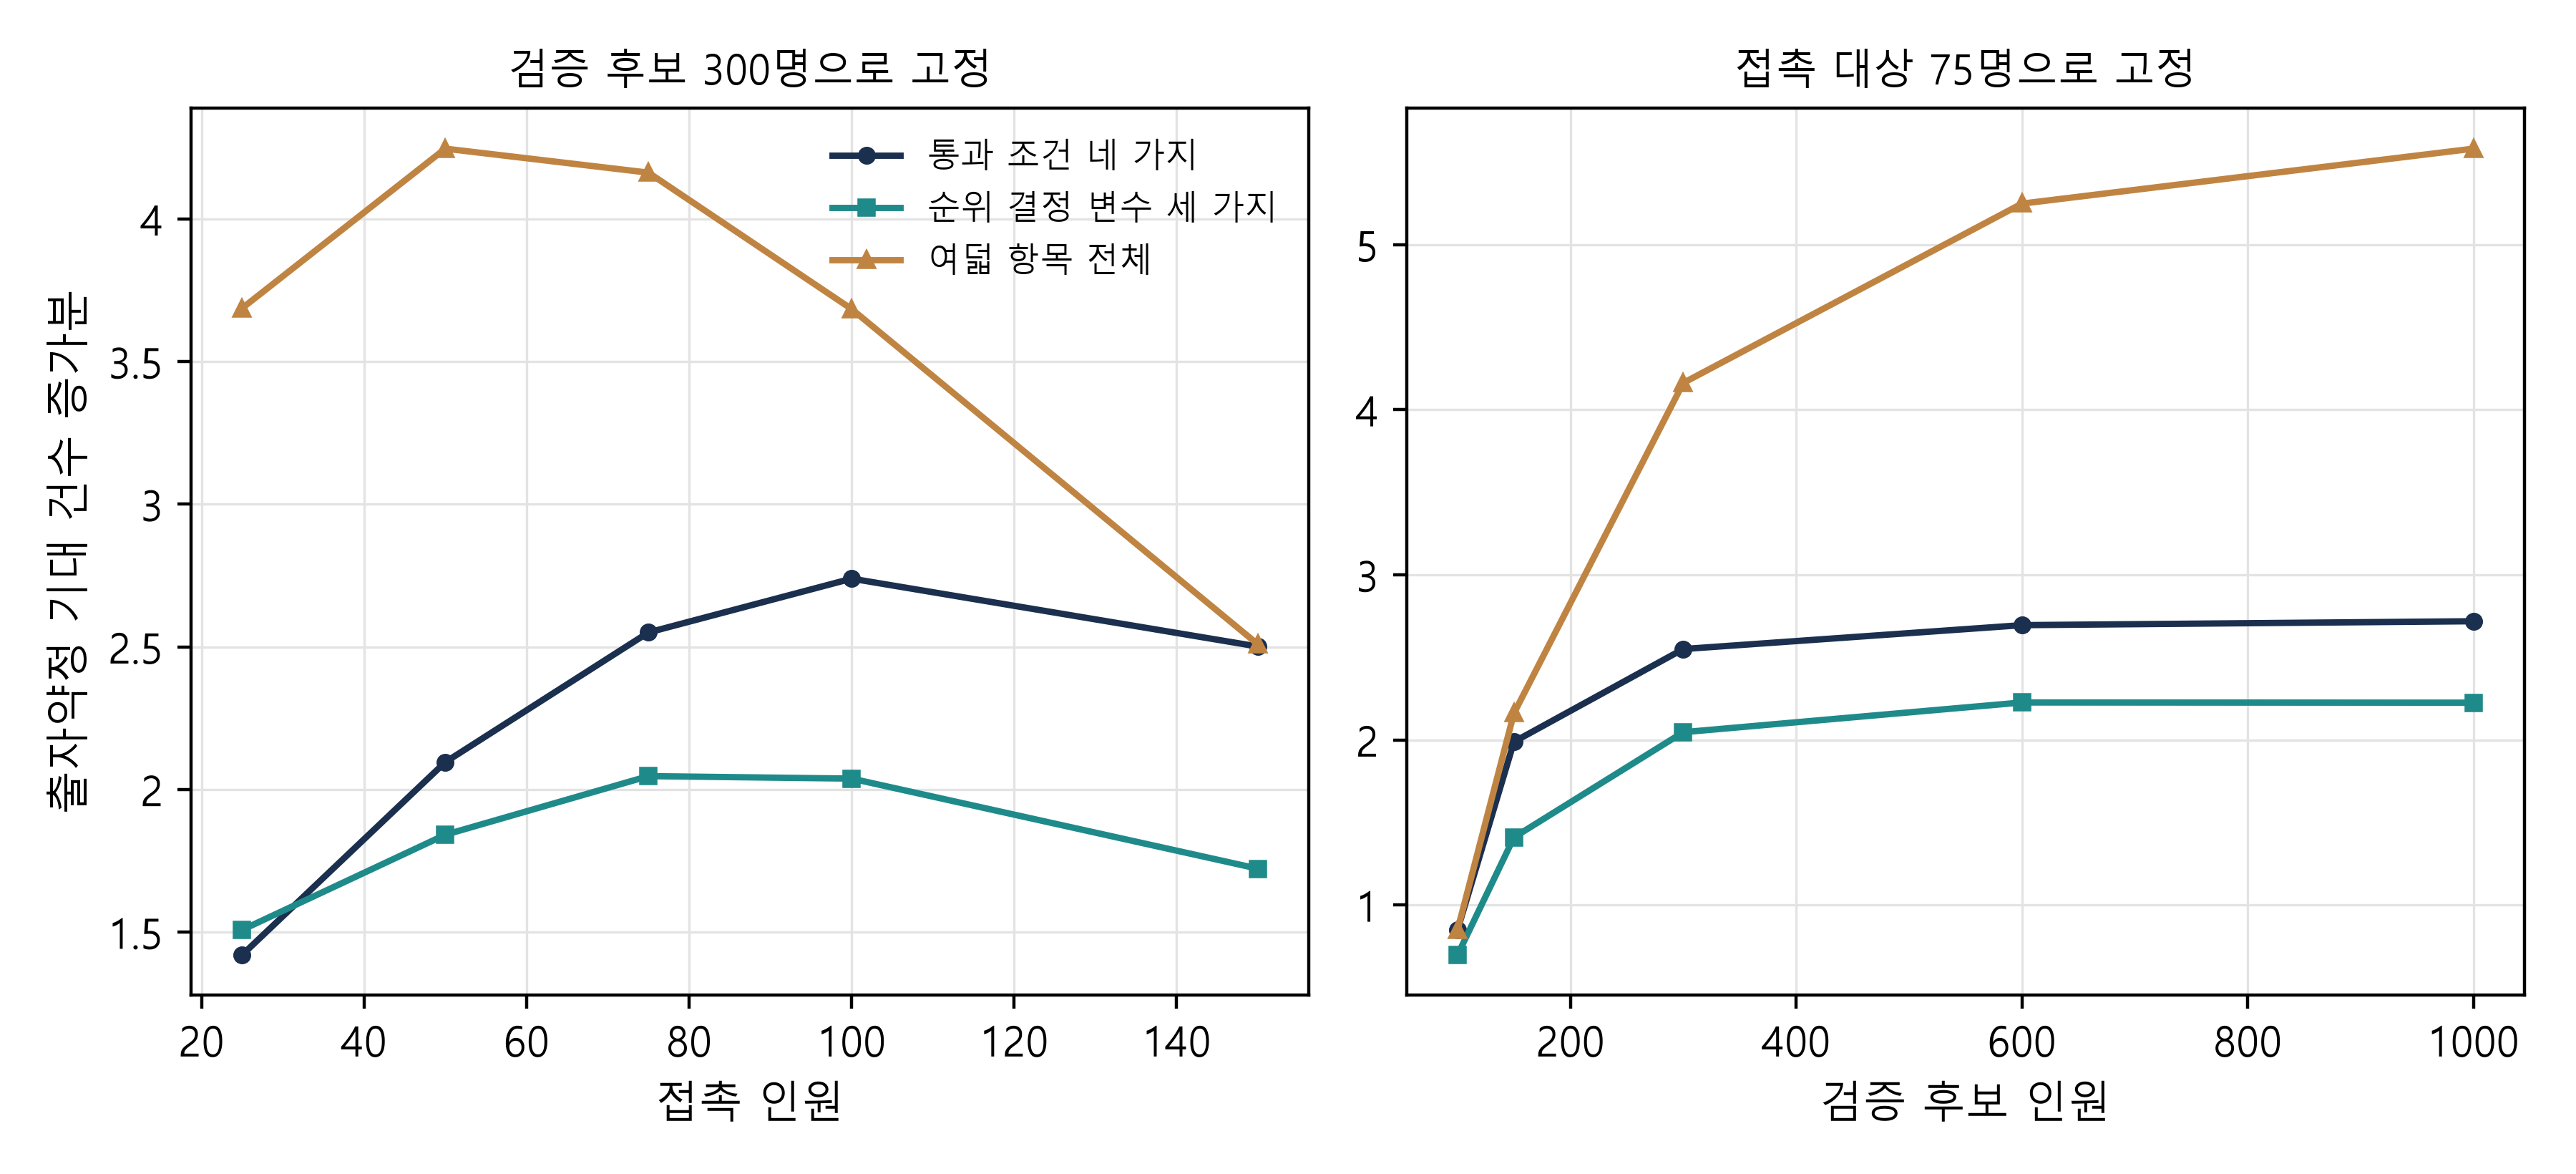
가상 명단에 대한 MatchPoint 분석이다. 제시된 입력값에 따른 모형 결과이며, 관측된 실적은 아니다. 통과 조건, 순위 결정 변수, 여덟 항목 전체를 각각 검증할 때 기록만 쓰는 경우보다 늘어나는 기대 건수다. 각 지점을 60회 반복했다.
오른쪽 그래프는 접촉 인원을 75명으로 고정하고 후보 명단의 규모를 바꾼 결과다. 후보 100명을 검증하면 기대 출자약정이 0.85건, 1,000명을 검증하면 5.58건 늘어난다. 미화 10,000달러당 증가분은 후보 100명에서 0.63건, 150명에서 1.07건, 300명에서 1.03건, 600명에서 0.65건, 1,000명에서 0.41건이다. 검증 후보가 접촉 인원의 두 배에서 네 배일 때 효율이 가장 높고, 그 규모를 넘으면 떨어진다. 후보 수가 접촉 인원과 같으면 대상을 선별할 여지가 없다. 후보가 지나치게 많으면 실제로는 접촉하지 않을 대상까지 비용을 들여 검증한다.
이 원칙은 본 모형의 입력값을 전제로 한다. 접촉 규모를 고려해 판단에 가장 큰 영향을 주는 항목부터 검증한다. 검증 비용이 여기서 가정한 수준보다 훨씬 낮은 경우를 제외하면, 검증 후보는 접촉 인원의 두 배에서 네 배로 잡는다. 접촉 규모를 바꾸면 검증할 항목도 다시 계산해야 한다.
16 스트레스 시나리오는 문제 유형별 점검 항목을 제시한다
표 10은 한 번에 하나의 입력을 바꾼 결과다. 검증 정보가 오래된 경우를 모형화할 때는 접촉일에 각 통과 조건의 상태를 0.25의 확률로 다시 추출한다. 검증 오류의 경우 확인한 조건별 판정 결과를 0.05의 확률로 뒤집고 순위 결정 변수의 관측값에 오차를 추가한다. 시장 위축은 두 임계값을 각각 0.5 높인다. 가중치를 잘못 적용한 모형은 세 가지 순위 결정 변수에 0.70, 0.40, 0.50 대신 0.20, 0.80, 0.20을 적용한다. 정보업체 기록의 품질을 낮추거나 높이는 경우에는 기록의 정확도를 바꾼다.
가로로 스크롤하면 모든 열을 볼 수 있습니다.
| 시나리오 | 기록만 사용 | 전체 검증 | 증가분 | 기록만 사용 시 출자약정 불가 대상 비율 | 전체 검증 시 출자약정 불가 대상 비율 | 실제로 출자약정이 가능한 후보의 오제외 비율 | 진단 징후 |
|---|---|---|---|---|---|---|---|
| 기본 입력값 | 5.15 | 9.32 | 4.17 | 42% | 0.0% | 0% | 기준 |
| 검증 정보의 시의성 저하 | 4.68 | 7.33 | 2.65 | 47% | 21.0% | 0% | 개선 효과가 줄고 검증한 접촉 대상이 접촉 시점에 탈락함 |
| 검증 오류 | 5.15 | 7.49 | 2.34 | 42% | 4.7% | 18% | 개선 효과가 줄고 잘못 제외한 후보는 접촉 집단에서 드러나지 않음 |
| 시장 위축 | 2.55 | 4.35 | 1.80 | 44% | 0.0% | 0% | 개선 효과에서 통과 조건의 비중이 유지되고 성과가 낮아짐 |
| 순위 산정 가중치 오류 | 3.88 | 7.30 | 3.42 | 42% | 0.0% | 0% | 통과 조건의 개선 효과는 거의 유지되며 순위 조정의 개선 효과는 줄어듦 |
| 낮은 품질의 정보업체 기록 | 3.62 | 7.87 | 4.25 | 55% | 0.0% | 0% | 상대 개선율이 높아지며 통과 조건의 효과가 가장 큼 |
| 높은 품질의 정보업체 기록 | 8.08 | 10.49 | 2.41 | 19% | 0.0% | 0% | 개선 효과가 줄고 추가로 검증할 내용이 적음 |
가상 명단에 대한 MatchPoint 분석이다. 제시된 입력값에 따른 모형 결과이며, 관측된 실적은 아니다. 75건을 접촉할 때의 출자약정 기대 건수다. 시나리오별로 100회 반복했다.
검증 정보가 오래되면 기대 건수 증가분은 4.17건에서 2.65건으로 줄고, 검증 후 선정된 접촉 대상의 21.0%가 접촉 시점에 출자약정을 할 수 없다. 실무팀에는 이미 조건을 충족한다고 판단한 후보가 뒤늦게 탈락하는 형태로 나타난다. 검증 오류는 증가분을 2.34건으로 낮춘다. 출자약정이 가능한 후보의 18%가 잘못 제외되는 손실은 접촉 결과에서 드러나지 않는다. 관측되는 징후는 뒤늦게 탈락하는 4.7%뿐이다. 제외된 후보 중 일부를 점검해 적격 후보가 잘못 제외되지 않았는지 확인한다.
시장이 위축되면 검증에 따른 증가분은 1.80건으로 감소한다. 전체 증가분에서 통과 조건이 차지하는 비중은 61%에서 62%로 거의 변하지 않는다. 통과 조건과 순위 결정 변수의 기여 비율은 비슷한 수준을 유지하며, 접촉 성과는 약 절반으로 낮아진다. 가중치를 잘못 적용하면 통과 조건의 효과는 2.17건으로 거의 유지되지만, 순위 결정 변수의 효과는 45% 감소한다. 조건을 통한 제외에는 이 가중치가 쓰이지 않으므로 잘못된 가중치에 비교적 영향을 받지 않는다. 순위 조정은 영향을 받는다. 정보업체 기록의 품질이 낮으면 증가분은 4.25건으로 큰 차이가 없으나, 기록만 쓴 경우의 성과가 더 낮아 그 대비 증가율은 118%다. 기록의 품질이 높으면 증가분은 2.41건으로 낮아진다. 기록의 품질이 낮을수록 검증의 가치가 높아진다.
이러한 양상을 다음 점검 항목을 고르는 단서로 삼는다. 접촉 뒤에야 통과 조건을 충족하지 못한 사실이 드러나면 최초 검증 날짜와 이후 변경 사항을 다시 확인한다. 개선 폭이 크고 대부분 통과 조건에서 비롯되면 정보업체 기록을 독립적인 근거와 대조한다. 제외 판단은 타당하지만 순위 조정의 효과가 작으면 가중치를 점검한다. 각 양상에는 여러 원인이 있을 수 있다. 출자약정 건수만으로는 원인을 진단할 수 없다.
17 적격 미팅과 출자약정 검증에 필요한 통계적 검정력
실무팀은 검증 정보를 반영한 순위가 기록만 사용한 순위보다 나은 성과를 내는지 확인할 필요가 있다. 표 11은 필요한 표본 크기를 제시한다. 모형에서 접촉 대비 적격 미팅 비율은 기록만 사용한 순위에서 32.4%, 검증 정보를 반영한 순위에서 63.0%다. 검정력 80%, 양측 유의수준 5%로 이 차이를 검출하려면 실험군별 접촉이 42건 필요하다. 실험군별로 75건을 접촉할 경우 검정력은 97%다. 출자약정 비율은 각각 6.9%와 12.4%이며 필요한 표본은 실험군별 443건이다. 75건씩 접촉할 때의 검정력은 21%다.
가로로 스크롤하면 모든 열을 볼 수 있습니다.
| 결과 | 기록만 사용한 경우의 비율(%) | 검증 정보를 사용한 경우의 비율(%) | 검정력 80%에 필요한 실험군별 접촉 건수 | 실험군별 한 차례 접촉 시 검정력(%) |
|---|---|---|---|---|
| 적격 미팅 | 32.4 | 63.0 | 42 | 97 |
| 서명된 출자약정 | 6.9 | 12.4 | 443 | 21 |
가상 명단에 대한 MatchPoint 분석이다. 제시된 입력값에 따른 모형 결과이며, 관측된 실적은 아니다. 두 표본의 비율을 비교하는 검정이다. 모의실험을 20,000회 반복해 검정력을 산출했다.
이 계산은 접촉이 서로 독립적이라는 전제와 가정한 결과 발생률에 기초한다. 실제 캠페인에서는 공통 여건, 같은 투자자와의 반복 접촉, 집단 간 파급 효과가 추정의 정밀도에 영향을 줄 수 있다. 사전 설계한 현장 연구에서는 배정 단위와 군집 구조를 고려한 다음, 적격 모집단에 맞는 발생률로 필요한 표본 크기를 추정해야 한다. 이 계획 수치만으로 검증 정보가 성과를 개선한다고 판단할 수 없다.
18 선택 편향과 무작위 탐색의 비용
실제 데이터의 비교를 어렵게 하는 요인은 결과가 관측되는 대상의 선택 편향이다. 이전 순위에 따라 실제로 접촉한 후보의 결과만 관측된다. 그 기록으로 새 순위를 평가하면 두 순위가 공통으로 선택한 후보의 결과만 확인할 수 있다. 이전 순위의 하위권에서 새로 포함된 후보에게는 관측된 결과가 없다. 단순 추정 방식은 두 집단이 겹치는 후보의 평균 성과를 구해 전체 접촉 인원에 적용한다.
식 (6)에서 W_B는 새 순위가 선택할 접촉 대상 집합이다. A_i는 이전 캠페인에서 투자자 i에게 접촉했으면 1이며, y_i는 관측된 미팅 결과, π_i는 투자자 i가 접촉 대상으로 선택될 확률이다. 이전 순위가 선택한 집단에서는 π가 1이다. 나머지 후보에게는 확률 ε로 무작위로 접촉하므로 π가 ε다. 식 (6b)는 역확률 가중 추정량이다. 추정 대상은 새 순위로 선정한 접촉 집단의 기대 미팅 건수이며, 모형에서는 47.09건이다. 표 12와 그림 6은 두 추정량의 오차를 제시한다.
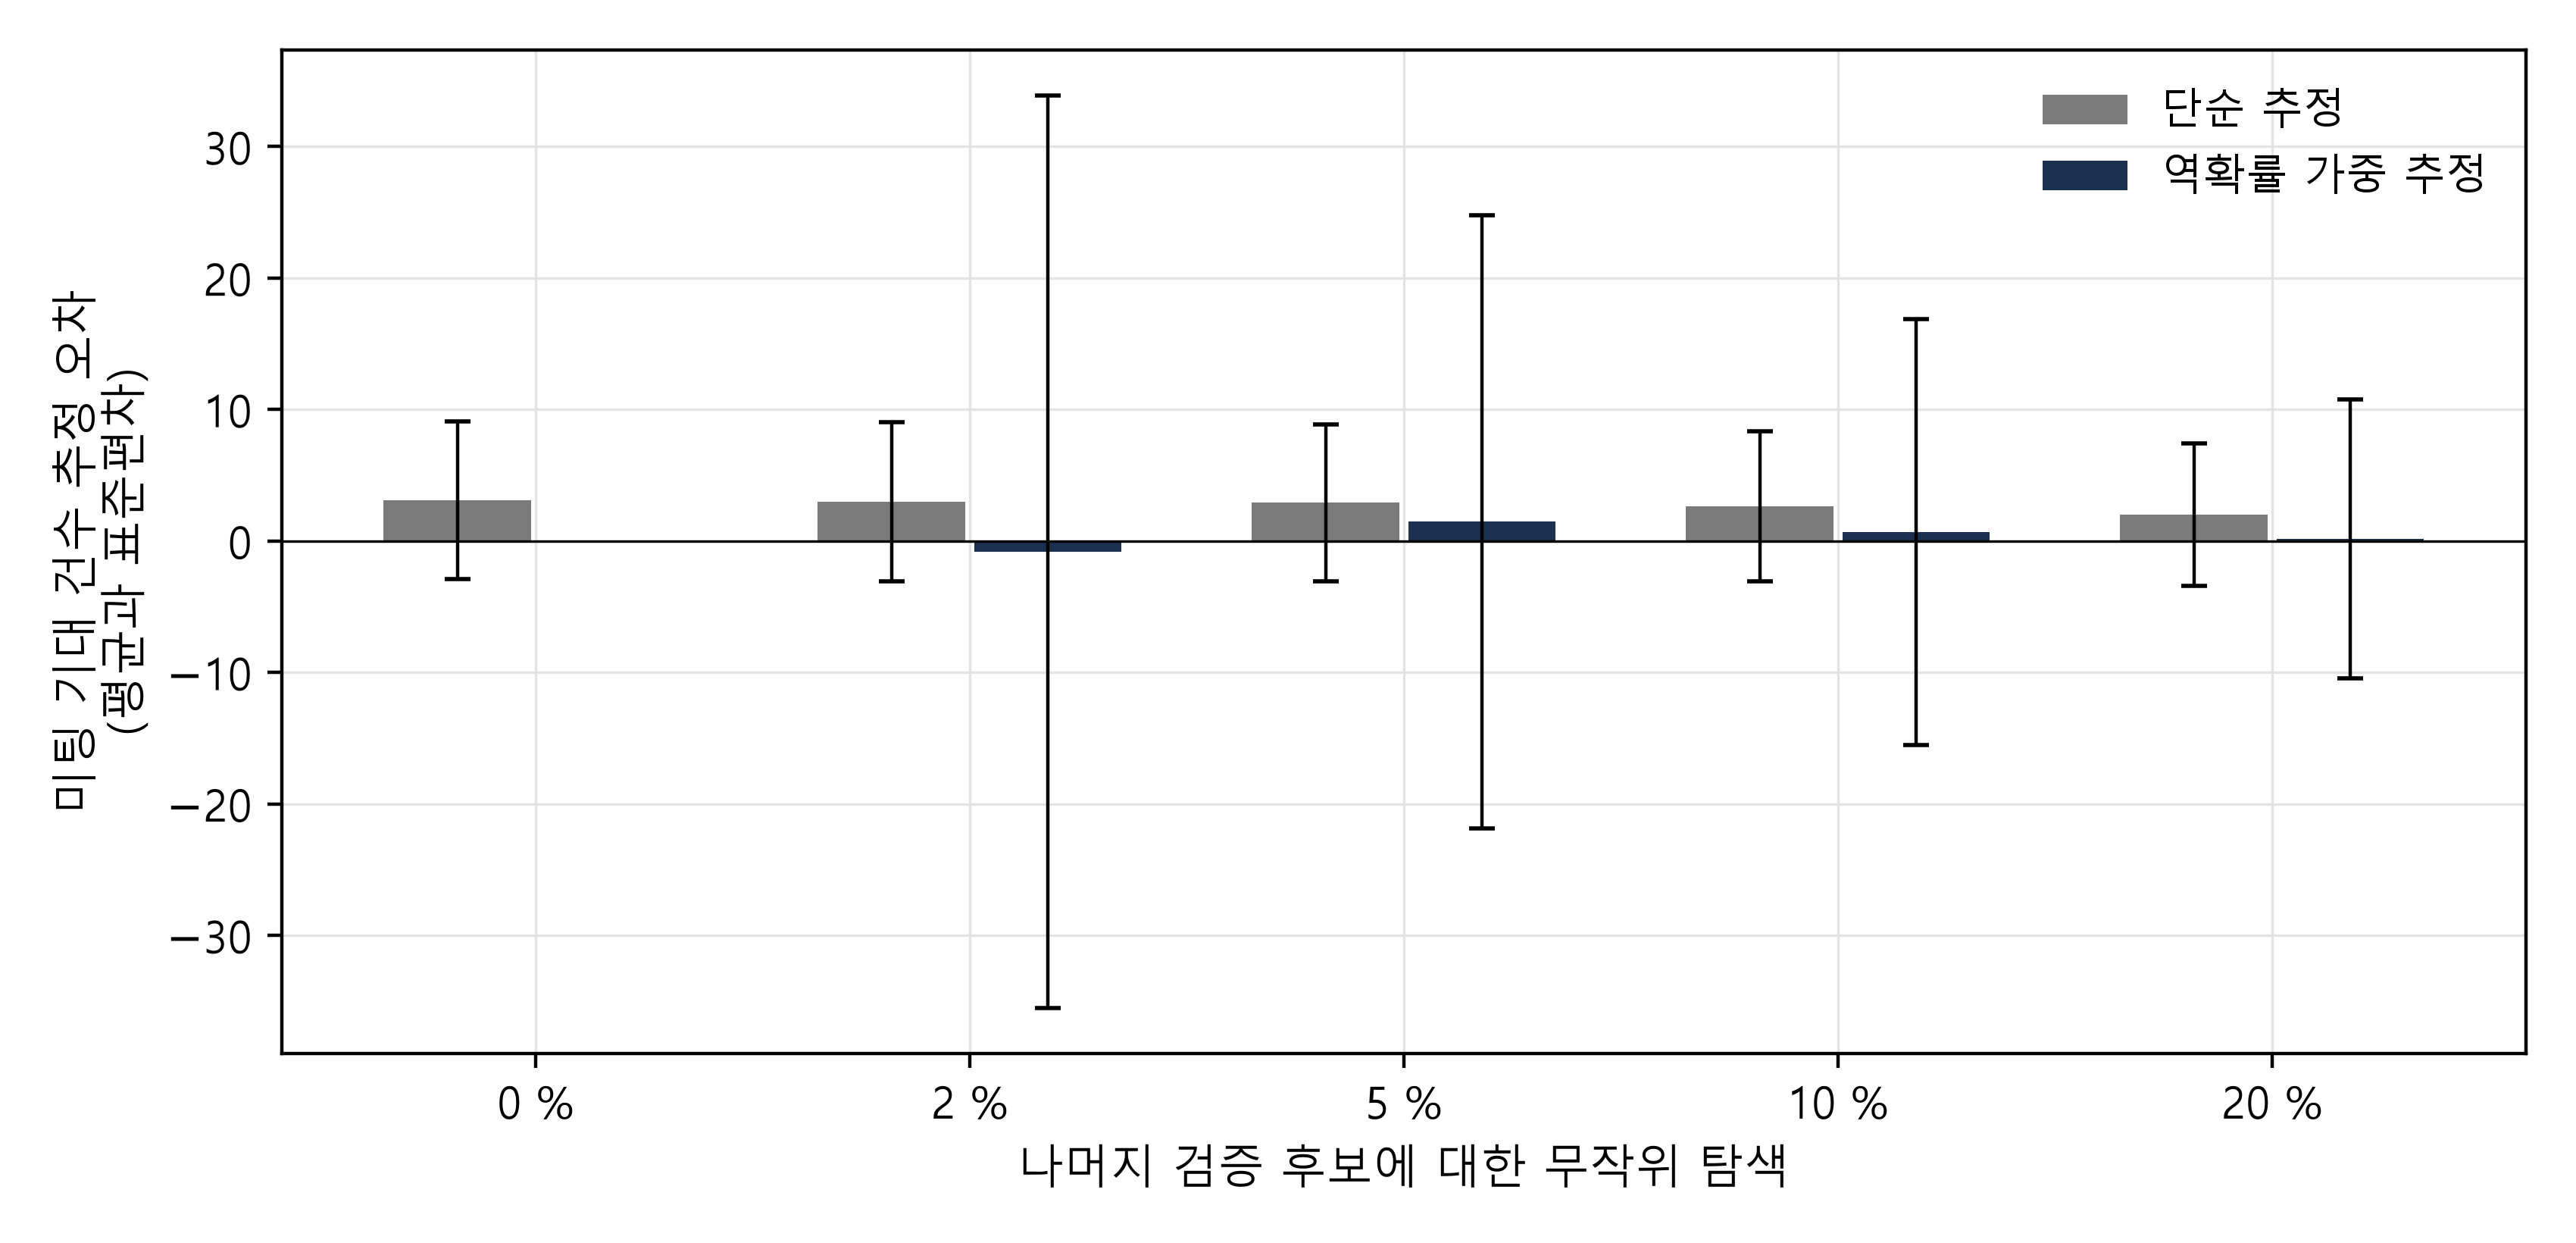
가상 명단에 대한 MatchPoint 분석이다. 제시된 입력값에 따른 모형 결과이며, 관측된 실적은 아니다. 기대 미팅 건수 추정 오차의 평균과 표준편차를 나타낸다. 무작위 탐색 비율별로 400회 반복했다.
가로로 스크롤하면 모든 열을 볼 수 있습니다.
| 후보 명단의 나머지 인원에 대한 무작위 탐색 비율 | 추가 접촉 건수 | 단순 추정 오차(평균) | 단순 추정 오차(표준편차) | 역확률 가중 추정 오차(평균) | 역확률 가중 추정 오차(표준편차) |
|---|---|---|---|---|---|
| 0% | 0.0 | 3.11 | 6.01 | 정의되지 않음 | 해당 없음 |
| 2% | 4.3 | 2.98 | 6.05 | -0.83 | 34.71 |
| 5% | 11.2 | 2.90 | 5.95 | 1.47 | 23.33 |
| 10% | 22.3 | 2.63 | 5.72 | 0.67 | 16.20 |
| 20% | 45.0 | 1.99 | 5.43 | 0.14 | 10.60 |
가상 명단에 대한 MatchPoint 분석이다. 제시된 입력값에 따른 모형 결과이며, 관측된 실적은 아니다. 오차는 추정값에서 새 순위로 선정한 접촉 집단의 실제 모형상 기대 미팅 건수를 뺀 값이다.
무작위 탐색이 없을 때 단순 추정량은 목표치의 약 7%에 해당하는 3.11건을 과대 추정한다. 탐색 비율을 높여도 편향은 서서히 줄어든다. 탐색 비율이 20%일 때 역확률 가중 추정량의 편향은 표본 오차 범위에서 0과 구별되지 않지만, 변동은 크다. 오차의 표준편차는 가중 추정량이 10.60건, 단순 추정량이 5.43건이다. 같은 20% 탐색 비율에서 평균제곱근오차는 각각 10.59건과 5.78건이다. 탐색이 없으면 가중 추정량을 계산할 수 없다. 관측 결과를 가중치 없이 합산하면 오차는 -25.58건이다. 단일 캠페인 규모에서는 보정으로 줄인 편향보다 보정으로 커진 변동이 더 크다.
이 모의실험에서 20% 무작위 탐색은 45.0건의 추가 접촉을 수반한다. 이는 기본 접촉 75건의 절반을 넘는다. 표본은 가상 모집단에서 후보 명단의 나머지 인원을 대상으로 추출한다. 실제 연구에서는 무작위 배정 전에 제안, 수신자, 발신자, 접촉 채널을 각각 검토해 접촉이 허용된 후보와 경로의 조합만 대상으로 삼아야 한다. 모의실험의 오차와 소요 접촉 건수를 이처럼 사전 심사한 모집단에 그대로 적용할 수 없다.
19 재현성 검증으로 모형 결과를 대조하고 전제의 순환성을 명시한다
표 13은 44개의 검증 항목을 기록한다. 검증이 정확하고 통과 조건이 일정할 때, 모든 항목을 검증해 선정한 집단은 후보 명단에서 모형상 실제 확률이 가장 높은 집단과 일치한다. 기본 모형의 각 반복 실행에서 전체 검증은 모든 부분 검증 조합과 성과가 같거나 더 높다. 개별 반복에서는 일부 항목만 검증했을 때 기대 출자약정 건수가 기록만 사용한 경우보다 낮을 수도 있다. 검증 항목에는 섀플리 값의 효율성, 평균 예측값의 보정 상태, 프로빗 공식과 수치 적분의 일치 여부도 포함된다.
가로로 스크롤하면 모든 열을 볼 수 있습니다.
| 검증 항목 | 결과 |
|---|---|
| 모형 코드에서 확인하는 검증 조건 | 44개 통과 |
| 기본 사례에서 전체 검증 결과와 비교 기준 | 후보 명단에서 확률이 가장 높은 집단과 일치하며, 각 부분 검증 조합과 같거나 더 높은 성과 |
| 섀플리 값의 합이 전체 증가분과 일치 | 합계가 전체 증가분과 일치(허용 오차 1e-9) |
| 기록만 사용한 점수의 보정 상태 | 평균 예측값이 모형상 실제 평균 확률에서 3% 이내 |
| 프로빗 기대값 항등식 | 닫힌 형태의 계산값과 수치 적분이 일치(허용 오차 1e-9) |
| 역확률 가중 추정량 | 탐색 비율 20%에서 편향이 표준오차 네 배 범위 내에서 0과 구별되지 않음 |
| 반복 횟수 | 주 분석 200회, 스트레스 분석 100회, 설명용 항목 80회, 민감도 격자 60회, 선택적 결과 관측 400회 |
| 난수 시드 | 20261014에 반복 실행 인덱스를 더한 값 |
MatchPoint 분석이다. 각 검증 항목은 모형 코드의 단언문으로 구현해 실행할 때마다 검사한다. 하나라도 실패하면 실행을 중단한다.
이 모형에는 전제와 결과 사이에 순환성이 있다. 결과를 생성하는 항목이 순위 산정에 사용하는 항목과 같으며, 순위 산정 모형은 그 가중치를 알고 있다. 따라서 이 실험은 가정한 대로 해당 항목들이 출자약정에 영향을 줄 때 방법이 어떻게 작동하는지 보여 준다. 실제 자금 모집에서 투자 위임 범위, 전략 적합성 또는 다른 항목이 출자약정에 영향을 준다는 증거는 아니다. 직원 수와 대외 인지도가 추가 정보를 주지 않는다는 결과도 이들에 독립적인 효과를 부여하지 않은 설계에서 나온다. 실제 보고서에서는 이와 같은 항목에 유용한 정보가 있을 수 있으며, 이는 데이터로 검증해야 한다.
실험에서는 실제 캠페인의 몇 가지 특성도 제외했다. 통과 조건 간 상관관계, 반복 접촉에 따른 학습, 자문사의 평판에 대한 투자자의 반응, 접촉 시점의 효과, 규제 위험의 비용을 반영한 손실함수다. 업무 처리 용량, 시점, 실행 순서는 본고의 범위 밖이며, 이를 포괄하려면 한 모형에서 함께 다뤄야 한다.
20 현장 연구에는 일시를 기록한 동의 기반 자료, 무작위 표본, 사전 분석 계획이 필요하다
모형에 설정한 입력값을 실제 자료로 대체하려면 관측 단위, 관측 기간, 결과를 먼저 정의해야 한다. 관측 단위는 캠페인별 개별 후보다. 관측 기간은 항목의 검증 시점부터 출자약정에 서명하거나 캠페인이 종료될 때까지다. 결과는 적격 미팅, 공식 실사 착수, 출자약정 서명으로 구분하고 각각의 일시를 기록한다. 표 14에 연구 설계를 정리했다.
가로로 스크롤하면 모든 열을 볼 수 있습니다.
| 설계 요소 | 요건 | 이유 |
|---|---|---|
| 관측 단위와 기록 | 후보와 캠페인의 조합을 단위로 삼고, 각 항목의 출처, 확인 담당자, 확인일을 기록 | 오래된 정보와 잘못된 정보를 구분 |
| 적법한 처리 근거와 데이터 최소화 | 각 개인정보 항목에 대해 처리 목적과 보유 기한을 명시 | 개인정보 보호 원칙 [12, 15] |
| 무작위 배정 표본 | 적법한 후보와 접촉 경로의 조합을 사전에 심사하고, 승인된 표본틀 안에서 무작위로 배정하며 포함 확률을 기록 | 사전 심사를 통과한 모집단에 한해 통계적 추론을 뒷받침 |
| 검증 결과 감사 | 제외된 후보 중 무작위 표본을 추출해 독립적으로 재검증 | 겉으로 드러나지 않는 잘못된 제외를 측정 |
| 단계별 결과 | 미팅, 실사 착수, 출자약정의 일시를 각각 기록 | 출자약정은 드물게 발생 |
| 캠페인 자료 통합 | 캠페인별 군집과 적격 표본틀의 관측 발생률을 반영해 연구 설계에 맞는 표본 크기를 산정 | 가장 드문 결과를 검출할 수 있는 검정력 확보 |
| 분석 계획 | 자료를 수집하기 전에 확정: 항목별 섀플리 값, 마지막 검증값 및 각 추정값의 구간 | 결과의 선택적 보고를 방지 |
제안된 연구 설계다. 수집할 자료를 설명하며 연구 결과는 제시하지 않는다.
현장 조사를 시작하기 전에 접촉 허용 범위, 적용되는 개인정보 보호 및 마케팅 요건, 적법한 처리 근거와 연구 허가를 문서화한다. 무작위 배정 자체가 접촉 권한을 부여하지는 않는다. 적격 접촉 집단을 미리 정하고, 해당 집단의 모든 후보와 접촉 경로 조합에 대해 알려진 양의 포함 확률을 기록한다. 탐색 예산을 사전에 정하고 캠페인별 군집을 고려한다. 제외된 후보를 감사할 때는 이들에게 접촉하지 않고 문서 검토만 할 수 있다.
분석에서는 모형과 같은 수치를 추정하고 각각의 추정 구간을 제시한다. 대상은 항목별 이익, 비용 대비 이익, 무작위 표본이 추정값에 미치는 효과다. 이를 통해 설명용 항목이 독립적인 정보를 제공하는지, 통과 조건을 충족하지 못한 후보에게 접촉하는 비용이 가정한 만큼 큰지 등 모형의 전제를 직접 검증한다.
21 고객과 위원회에는 검증 항목, 비용, 감사 결과를 한 표에 제시한다
고객이나 투자위원회는 보고서를 의사결정 자료로 활용할 수 있어야 한다. 접촉 규모, 검증한 후보 명단의 범위, 검증한 항목을 명시하고 항목별 출처와 확인일을 기록할 것을 제안한다. 각 통과 조건으로 제외한 후보 수, 뒤늦게 탈락한 후보 수, 순위가 조정된 후보 수도 보고한다. 표 7처럼 분석 담당자의 투입 시간과 추가 출자약정의 기대 건수를 대비하고, 출자약정 한 건당 손익분기 가치를 제시한다.
검증하지 않은 항목과 그 이유도 표시한다. 정보업체의 판정값을 그대로 쓴 항목에는 가정한 정확도를 명시한다. 제외된 후보에 대한 감사 결과는 같은 페이지에 배치한다. 검증 오류 시나리오처럼 지나치게 많은 후보를 제외하는 기준은 겉보기에 효율적이지만 출자약정 기회를 잃게 할 수 있다. 독자는 각 수치가 관측값인지, 검증값인지, 가정값인지 구분할 수 있어야 한다.
모형 결과의 표현에도 주의가 필요하다. 본고에서 계산한 개선 효과는 자금 모집 전망치로 볼 수 없다. 보고서에서 출자약정 기대 건수는 명시된 가정에 따른 순위 결정 수단으로 제시한다. 실제 적격 미팅과 출자약정은 발생한 시점에 실적으로 기록한다. 모형과 보고서는 어떠한 성과도 약속하지 않으며, 본고는 특정 투자 제안에 관한 자문을 제공하지 않는다.
22 데이터와 AI로 정보를 갱신하되, 통과 여부는 지정된 담당자가 판단한다
투자 위임 범위와 전략 대조, 투자 금액 범위 추출, 정책 변경 표시와 같은 반복 작업에서 자동화 도구를 시험한다. 적용 범위를 정하기 전에 검토 시간과 사람의 확인 뒤에도 남는 오류를 측정한다. 모형에서 검증 비용은 입력값이다. 특정 항목의 비용이 낮아지면 검증 순서에서 앞당겨질 수 있다. 본고는 자동화 도구의 정확도를 실측하지 않았다.
모형은 자동화에 통제가 필요한 지점을 보여 준다. 오래된 정보와 잘못된 검증은 겉으로 드러나기 어렵고, 자동화 도구는 두 문제를 대규모로 일으킬 수 있다. 투자 위임 범위를 잘못 읽으면 출자약정을 할 수도 있었던 후보가 제외되지만, 접촉 결과만으로는 그 손실을 볼 수 없다. 따라서 자동 판독 결과는 출처 링크를 붙인 제안으로 기록하고, 후보를 제외하는 판단은 지정된 담당자가 맡을 것을 제안한다. 매 주기마다 자동 판독 결과에 따라 제외한 후보의 무작위 표본을 사람이 점검한다.
자동 판독 도구를 평가할 때는 일반적인 정확도 점수보다 모형이 보여 주는 손실을 측정한다. 잘못 제외하면 해당 후보의 기대 출자약정을 잃는다. 잘못 통과시키면 접촉 기회 한 건을 쓰며, 적격성 판정의 오류라면 규제상 위험도 생길 수 있다. 평가에는 조정에 쓰지 않은 후보를 사용하고 원문 자료가 바뀔 때 다시 실시한다. 한 해의 정책 문구에 맞춘 도구가 이듬해 문구에서는 오류를 낼 수 있기 때문이다.
23 실제 자금 모집의 판단 기준: 후보의 통과 조건을 검증하고 비용 대비 이익으로 순서를 정하며 제외 결정을 감사한다
실무팀은 자체 기록을 바탕으로 다음 절차를 검증해 볼 수 있다. 첫째, 고위 담당자가 투입할 수 있는 시간 내에서 접촉 인원을 정하고 검증 후보 명단은 그 두 배에서 네 배로 구성한다. 둘째, 순위 결정 변수에 앞서 후보 명단의 통과 조건을 검증하고 출처와 일자를 기록한다. 셋째, 비용 대비 이익이 큰 순서로 순위 결정 변수를 추가하되, 다음 항목의 기대 증가분이 그 검증 비용을 모집 주체가 부여한 출자약정 한 건의 가치로 나눈 값보다 낮아지면 멈춘다. 넷째, 제외된 후보의 무작위 표본을 감사한다.
세 조건에 따라 이 절차를 조정할 수 있다. 정보업체 기록이 정확한 시나리오에서는 검증으로 얻는 이익이 줄어 검증 후보 명단을 좁힐 수 있다. 후보 명단에 비해 접촉 규모가 작으면 순위 결정 변수와 통과 조건의 중요성이 비슷하므로 함께 검증한다. 시장이 위축되면 접촉 성과와 검증의 개선 효과가 함께 줄고 조건과 순위 변수 간 기여 비율은 유지된다. 이 경우에도 절차는 적용할 수 있지만 각 검증에 더 높은 손익분기 가치가 필요하다.
이 절차는 현장 연구로 검증할 가설이다. 가상 사례에서 도출됐으며 그 사례는 설정한 입력값에 따랐다. 실무팀은 이를 검증 작업의 우선순위를 정하는 방법으로 사용하고, 가설을 반박할 수 있는 결과도 기록한다. 예를 들어 검증된 후보의 뒤늦은 탈락, 제외된 후보의 실제 출자 의향, 후속 단계로 이어지지 않은 미팅이 있다.
24 한계와 다음 단계: 실제 무작위 표본 기록으로 설정 가중치를 대체한다
가상 실험이라는 점이 주된 한계다. 가중치, 조건별 통과율, 비용은 모형에 설정한 값이다. 순위 산정 모형은 이 구조를 알고 있다. 통과 조건은 서로 독립적이고 순위 결정 변수는 정규분포를 따르며 결과는 단일 프로빗 모형으로 표현했다. 투자자는 이전 접촉에서 학습하지 않으며 접촉에는 평판 비용이 없다. 결과는 이러한 조건에서 보고서가 작동하는 방식을 보여 주며, 실제 투자자 모집단을 추정하지 않는다. 특히 항목별 순위는 가중치에 따라 달라지므로 가중치가 바뀌면 순위도 달라질 수 있다.
일부 출처는 본고의 질문보다 범위가 좁다. 현장실험은 스타트업과 엔젤투자자에게 제시한 정보를, 데이터베이스 연구는 벤처캐피털 자료를, 정보가치 연구는 보건의료기술을 다룬다. CalPERS의 정책은 한 투자자가 공표한 한도를 보여 주는 사례다. 이 한도를 다른 투자자에게 일반화할 수 없다. 각 출처는 관련 판단의 틀을 뒷받침한다. 어느 출처도 모형 입력값의 수치를 제공하지 않는다. 규제 문서는 명시한 날짜에 열람한 내용이며, 특정 투자 제안에 적용해 검토하지 않았다.
먼저 제외 결정과 항목별 검증 비용을 문서에 근거해 감사한다. 전향적 연구에서는 접촉이 허용되는 표본틀을 독립적으로 심사한 뒤, 실무팀이 감당할 수 있고 선택한 결과를 충분히 정밀하게 추정할 수 있는 탐색 비율을 정한다. 보고서 양식을 바꾸기 전에 적격 연구 모집단의 자료로 개선 효과와 비용을 다시 추정한다.
참고문헌
- Bernstein, S., Korteweg, A. and Laws, K. Is it Just the Idea that Matters? A Randomized Field Experiment on Early Stage Investments. 2014년 3월 작업논문 초안 전문을 검토했다. 게재명: Attracting Early-Stage Investors: Evidence from a Randomized Field Experiment, Journal of Finance 72(2), 2017, doi 10.1111/jofi.12470, 게재본은 초록만 검토했다. https://www.haas.berkeley.edu/wp-content/uploads/BernsteinKorteweg_032314.pdf
- Gompers, P., Gornall, W., Kaplan, S. and Strebulaev, I. How Do Venture Capitalists Make Decisions? NBER Working Paper 22587, September 2016. https://www.nber.org/system/files/working_papers/w22587/w22587.pdf
- Guyon, I. and Elisseeff, A. An Introduction to Variable and Feature Selection. Journal of Machine Learning Research 3, 2003, pp. 1157-1182. https://www.jmlr.org/papers/volume3/guyon03a/guyon03a.pdf
- Heath, A. and Baio, G. Calculating the Expected Value of Sample Information using Efficient Nested Monte Carlo: A Tutorial. arXiv:1709.02319. 보건경제학을 다룬다. https://arxiv.org/pdf/1709.02319
- Bindels, J. et al. Use of Value of Information in Healthcare Decision Making: Exploring Multiple Perspectives. PharmacoEconomics, 2015. 네덜란드에 관한 연구다. https://repub.eur.nl/pub/79197/2015-12-07-033.pdf
- Kaplan, S. and Lerner, J. Venture Capital Data: Opportunities and Challenges. NBER Working Paper 22500, August 2016. https://www.nber.org/system/files/working_papers/w22500/w22500.pdf
- Lerner, J., Schoar, A. and Wong, W. Smart Institutions, Foolish Choices? The Limited Partner Performance Puzzle. NBER Working Paper 11136, February 2005. 초록과 서론만 검토했다. https://www.nber.org/system/files/working_papers/w11136/w11136.pdf
- United States Securities and Exchange Commission. 17 CFR 230.506, Exemption for limited offers and sales without regard to dollar amount of offering, paragraph (c). 2026년 10월 14일 eCFR 현행 문서를 열람했다. https://www.ecfr.gov/current/title-17/chapter-II/part-230/section-230.506
- United States Securities and Exchange Commission. 17 CFR 230.501, Definitions and terms used in Regulation D, paragraph (a). 2026년 10월 14일 eCFR 현행 문서를 열람했다. https://www.ecfr.gov/current/title-17/chapter-II/part-230/section-230.501
- Dubai Financial Services Authority. DFSA Rulebook, Conduct of Business Module (COB), version 51 (COB/VER51/07-26), rules 2.3.2 to 2.3.4 and guidance. 2026년 10월 14일 열람 당시 현행 통합본. https://dfsaen.thomsonreuters.com/sites/default/files/net_file_store/DFSA1547_12383_VER510726.pdf
- California Public Employees’ Retirement System. Public Employees’ Retirement Fund Investment Policy, effective 1 July 2026, Appendix 4, Private Equity: Partner Relationship Exposure. https://www.calpers.ca.gov/documents/202606-invest-agenda-item05a-10-a/download
- United Kingdom. Regulation (EU) 2016/679 as it forms part of United Kingdom law, Article 5(1)(c) and (d). legislation.gov.uk. https://www.legislation.gov.uk/eur/2016/679/article/5
- Institutional Limited Partners Association. ILPA Due Diligence Questionnaire 2.0, updated November 2021. 업계의 자율 활용 도구. https://ilpa.org/wp-content/uploads/2021/11/ILPA-DDQ-2.0.pdf
- California Public Employees’ Retirement System. Investment Committee Meeting Summary, 15 June 2026, approval of Agenda Item 5a, Total Fund Policy Review. https://www.calpers.ca.gov/documents/202606-full-agenda-item7a-invest-committee-summary/download?inline=
- Dubai International Financial Centre. Data Protection Law, DIFC Law No. 5 of 2020, consolidated version of July 2025, Article 9(1). https://edge.sitecorecloud.io/dubaiintern0078-difcexperie96c5-production-3253/media/project/difcexperiences/difc/difcwebsite/documents/laws--regulations/data-protection-law.pdf
저자 소개
Chennakeshav(CK)는 M&A, 성장자본 및 기업전략 전반의 거래 발굴·구조화·실행에서 25년 이상의 글로벌 경험을 보유한 기업금융·투자은행 임원이다. 창업자, 기업 및 펀드를 위한 가치창출 자문을 이끌며 이사회 관점과 직접 실행 및 거래 종결을 연결해 왔다.
경력은 Morgan Stanley, HSBC, Lloyds Banking Group, EWEC, ADQ 포트폴리오 기업 및 Emirates Growth Fund에 걸치며 TMT, 부동산, 핀테크, 딥테크, 클린테크, 인프라 및 에너지 부문을 포함한다. 최고경영진, 사모투자·벤처펀드, 국부펀드 및 패밀리오피스와 함께 복잡한 자금모집과 성장기업의 금융을 추진했다. 가치창출을 위한 M&A 실사, 인수 후 통합 및 사업변혁도 이끌었다.
Matchpoint Partners의 Managing Partner로 기업금융, M&A 및 자본조달 자문을 총괄한다. London Business School MBA와 VTU 공학 학위를 보유하며, UCL London의 Master of Laws(LLM) 과정을 진행 중이다.
적극적인 스타트업 멘토로 Techstars, DIFC FinTech Hive, Startup Grind, Founder Institute 및 IN5에서 활동한다. London Business School의 Entrepreneur Mentor in Residence(EMiR)를 맡고 Entrepreneurship World Cup 심사위원으로도 참여한다.
https://www.linkedin.com/in/ckadya/
https://www.matchpoint-partners.com/team/ck-adya.html
면책 고지
본 논문은 사모·대체시장의 구조를 다루는 연속 연구의 일부다. 제시한 견해는 저자 개인의 견해다. 정보 제공을 목적으로 시장 구조를 일반적으로 설명하며, 투자·법률·세무·규제 자문이나 특정 증권·투자기구·거래상대방에 대한 권고를 구성하지 않는다.
