
1 按各项信息对首轮接洽的影响选择报告字段
募资方即使掌握一份很长的潜在投资者名单,也无法同时接洽所有人。高管的时间通常只够在首轮接洽数十名候选人,分析人员则可核实一份规模稍大的初选名单。投资者筛选报告记录对各候选人已掌握的信息,字段可能多达数十项。本文聚焦两个问题:核实哪些信息会改变优先接洽对象,核实哪些信息会剔除原本就无法作出出资承诺的候选人。对这两项决策都没有影响的字段,只会增加成本。
本文以模拟实验回答上述问题。实验依据明确列出的输入生成1,500名投资者,为每人配置一份含有部分错误的供应商式记录,并据此选出300名候选人,再从中选取75名首轮接洽对象。八项信息均可按规定成本核实。实验衡量每项核实工作对该批次预期签署出资承诺数的贡献。实验未使用实际接洽记录,所有数字均为给定输入下的模型结果。
本文先依据公开规则和研究建立框架[1, 2, 3, 4, 6, 8, 10, 11, 12],再定义指标、运行模拟和压力测试,并测算实际团队复现研究所需的数据量。最后提出取证设计、报告格式和决策规则。主要局限是:各项信息的排序取决于假定权重。实验展示了前提成立时方法的表现,前提本身仍需实证检验。
2 将决策限定为固定规模的接洽批次,按剔除或排序作用划分字段
决策目标是从名单中选出一批75名拟接洽对象。最终成果以该批次签署的出资承诺数计,在投资者作出承诺时记录;符合条件的会议属于中间成果。掌握某项信息的真实取值后,若能调整批次成员、提高预期出资承诺数,并使改进的价值超过核实成本,该字段就有决策价值。仅有描述意义、无法改变批次构成的字段没有决策价值。
两种机制区分了核心字段。准入条件不满足时,候选人无法参与本次募集:例如依法不能收到要约、投资授权不允许、拟出资金额不在限额内,或不接受由顾问发起接洽。核实准入条件可以识别应剔除的候选人。排序因素会改变符合条件的候选人作出承诺的概率,核实后可以调整顺序。第三类是代理指标,可预测准入条件或排序因素;相关因素一经核实,代理指标便不再增加价值。第四类是没有预测作用的装饰性字段。
表1列出实验涵盖的十二个字段。八项可以付出成本、依据资料来源核实;另外四项是数据供应商通常直接提供的描述性字段。表中列明各字段在模拟数据生成过程中的设定作用。这些作用属于模型输入,实际报告须用数据加以验证。后文讨论相应的取证设计。
横向滚动可查看全部列。
| 字段 | 核实来源 | 实验中的作用 | 可能改变的决策 |
|---|---|---|---|
| 接收要约的资格 | 投资者分类证明或监管身份 | 准入条件 | 剔除 |
| 投资授权涵盖该策略与地区 | 公开投资政策或授权函 | 准入条件 | 剔除 |
| 出资金额区间和集中度上限 | 公开限额、基金规模和配置区间 | 准入条件 | 剔除 |
| 允许由顾问发起接洽 | 公开采购或募集代理政策 | 准入条件 | 剔除 |
| 已确认决策者 | 用另一来源确认具名人员的职务 | 排序因素 | 调整顺序 |
| 投资策略与阶段匹配度 | 审阅近期出资承诺 | 排序因素 | 调整顺序 |
| 近期同类出资承诺 | 基金募集完成公告和投资者名单 | 排序因素 | 调整顺序 |
| 关系深度 | 自有接洽记录与往来历史 | 排序因素 | 调整顺序 |
| 投资者类型 | 供应商记录 | 准入通过率的代理指标 | 初步筛选 |
| 规模(管理资产规模) | 供应商记录 | 出资限额条件和投资活动的代理指标 | 初步筛选 |
| 人员数量 | 供应商记录 | 与规模相关的装饰性字段 | 无 |
| 公众知名度 | 供应商记录 | 与规模相关的装饰性字段 | 无 |
各字段的作用为模拟实验的设定。核实来源为团队可能查阅的文件示例。
3 投资者公开披露的规则使一些准入条件可以核实
加州公共雇员退休基金(CalPERS)自2026年7月1日起生效的投资政策提供了一个可核实的出资限额示例。附录4规定,对单只基金的出资承诺不得超过该基金规模的35%。对同一普通合伙人的净承诺资本合计不得超过私募股权计划净承诺资本总额的15%;例外须获委员会专项批准[11, 14]。两个百分比的计算基数不同。仅按单只基金的上限计算,若出资承诺为4,000万美元,基金规模至少约为1.143亿美元。这一计算无法说明剩余出资额度或投资意向。
美国规则506(c)要求购买方为合格投资者,发行人须采取合理措施核实其资格。该要求适用于豁免项下的认购,具体接洽路径须分别评估[8]。规则501(a)(1)规定,合格投资者的一类包括由州或其规定的下属行政单位、机构或实体设立并维持的公共雇员计划,且总资产须超过500万美元[9]。迪拜金融服务管理局(DFSA)的《业务行为》模块以零售客户为默认类别,并规定视为专业客户的类别。大型企业认定以最近一期财务报表为准,须至少达到以下两项门槛:总资产2,000万美元、年净营业额4,000万美元,或自有资金或已催缴股本200万美元[10]。
这些资料说明,投资资格和出资金额匹配度可以依据明确的门槛和投资者证明材料来核实。各接洽路径和司法辖区的义务不同,资料本身不能确定某个顾问或发行人是否必须把这些规则用于接洽名单,也没有提供通过率。实验因此将通过概率作为输入。表2列出各项规则对报告内容的要求。
横向滚动可查看全部列。
| 来源 | 规则或限额 | 报告须记录的内容 | 文件状态 |
|---|---|---|---|
| CalPERS公共雇员退休基金私募股权政策[11, 14] | 单只基金上限为35%;另设私募股权计划单一普通合伙人上限15%,例外须获委员会批准 | 基金规模、拟出资金额及对该普通合伙人的现有敞口 | 2026年7月1日起生效 |
| 美国规则506(c)[8] | 所有购买方须为合格投资者;须采取合理措施核实 | 资格证明及其日期 | 2026年10月查阅eCFR现行条文 |
| 美国规则501(a)[9] | 包括符合条件且资产超过500万美元的公共雇员计划 | 资格类别与资产证明 | 2026年10月查阅eCFR现行条文 |
| DFSA《业务行为》模块[10] | 默认归为零售客户;视为专业客户的类别;大型企业认定标准 | 客户类别和最新财务报表 | 第51版,2026年7月,查阅时为现行版本 |
Matchpoint依据所引文本整理。文件状态见本节正文。本文不对任何募集作出法律结论。
4 报告须标明字段的来源和日期,并仅保留实际使用的信息
筛选报告中的字段只有在接洽时仍准确,才具有价值。Kaplan和Lerner对商业私募资本数据库的研究发现,数据库的覆盖范围和定义各不相同,依赖自愿报告,并存在历史补录和选择偏差。不同平台用三种不同方式按基金年份分组,同一个多资产投资者在各平台的分类也可能不同。研究指出,现有数据库的方法不同,数据经常出现差异,交易级数据尤为明显[6]。该研究讨论的是2016年的风险投资数据,说明同一投资者的两份记录可能不一致,并未测定不一致的频率。
报告应具体说明信息如何得到核实。本文建议每个字段标明来源、查阅日期和查阅人。过去九十天内依据公开政策核实的投资授权,与直接沿用供应商标签的授权记录,两者证据基础不同。后文实验把供应商记录视为有误差的读数,把核实结果视为精确值,再在压力测试中放宽后一假设。
个人数据构成另一项约束。英国《通用数据保护条例》第5(1)条要求数据充分、相关,并限于处理目的所必需的范围,同时须准确,必要时须及时更新[12]。因此,记录具名决策者的信息应说明用途。迪拜国际金融中心(DIFC)2020年《数据保护法》第9(1)条规定了相应要求:个人数据须与既定目的有关,限于为该目的所必需的范围,且须准确并在必要时更新[15]。本文未审查阿布扎比全球市场的规定;在适用上述原则前应征询当地专业意见。实务上,报告不应收集表1中没有决策价值的个人字段。
还需考察现有标准。有限合伙人已将向基金管理人提出的问题标准化。ILPA于2021年11月更新的2.0版问卷覆盖二十个主题,用于减轻定制问卷的负担,并非强制文件[13]。本次审阅未找到关于募资方应核实哪些投资者信息的同类标准。本文因此提出自己的报告方案,各字段的依据来自模拟实验。
5 最接近的实地实验揭示了什么会吸引投资者关注一项要约
与本文问题最接近的实验,是在撮合初创企业与天使投资者的平台上开展的一项随机实地研究。研究向约4,500名投资者发送约17,000封邮件,随机改变每封邮件所提供的信息。投资者对创始团队信息反应强烈,对业务进展或已有领投方的信息未表现出同样的反应。本文查阅的2014年3月草稿显示,这一效果主要来自经验最丰富的投资者;经验最少的投资者对所有类别的信息均有反应。披露团队信息使点击率在约16.5%的基础上提高2.6个百分点;点击者中有2.98%后来进行了投资。[1]
该研究随机改变的是要约信息,这是函件实验可以控制的内容。本文关注的是投资者自身的属性,募资方无法随机分配这些属性。该研究还记录了点击、引荐请求和报告的投资行为,未记录对基金签署的出资承诺。研究作者指出,现有数据库只收录已完成的交易,没有覆盖投资者曾考虑的全部初创企业,因而无法评估筛选过程。[1] 2017年《Journal of Finance》刊载版本的摘要也报告了团队信息的同一发现。本文未查阅刊载版全文;上述数字来自草稿,可能与刊载版不同。
问卷调查反映的是受访者陈述的偏好。一项覆盖681家机构、885名风险投资人的调查发现,95%的机构将管理团队列为重要筛选因素,基金匹配度的排名相对较低。[2] 这类陈述反映了投资者如何评价企业,无法说明有限合伙人在实际募集过程中如何回应基金管理人。另一项研究发现,不同类型有限合伙人的投资回报差异显著,捐赠基金高出平均水平约14%。该研究讨论的是投资表现,未涉及对募资接洽的响应。[7]
这些资料表明,要约信息会改变投资者的关注程度,经验会影响其响应,投资者类型也与其他性质的结果有关。资料无法确定哪些投资者属性可以预测出资承诺。本文检索未找到回答这一问题的实地实验;检索结果不能证明此类实验不存在。下文通过模拟案例说明如何研究这一问题,并提出实地取证方案。
6 信息价值分析提供衡量方法,变量选择理论提示信息可能冗余
信息价值分析衡量购买信息之前可预期的价值。卫生经济学中,一组参数的期望完全信息价值衡量精确了解这些参数的收益,也是对它们开展任何有限规模研究所能带来价值的上限。Heath和Baio将样本信息的期望价值定义为拟开展研究的平均收益,并建议先计算这组参数的完全信息价值上限;若上限过低,开展该研究便没有价值。[4] 原研究涉及卫生技术评估,本文仅借鉴其分析逻辑。
在同一决策模型下,精确掌握某项信息所带来的预期收益,是同一接洽决策中使用较不精确信息所获预期收益的上限。Bindels等人发现,虽然利益相关方认可信息价值分析与荷兰医疗报销决策有关,实际应用却很少;忽略结构不确定性还可能使结果产生偏差。[5] 本文结果只适用于所假定的结构;结构变动后,估计值也会变化。
变量选择理论提醒我们,逐项衡量价值存在局限。Guyon和Elisseeff指出,若变量之间存在冗余,逐项排序往往无法构建最优预测模型;单独无用的变量可能在组合中改善预测表现,两个分别无用的变量也可能在一起时发挥作用。[3] 在报告中,冗余意味着某字段单独看似有用,但已知另一字段后便不再增加价值。互补性意味着单独看似无用的字段,可能在组合中发挥作用。因此,本文从三个角度衡量各字段:单独核实、最后核实,以及取所有核实顺序下的平均值。
这些资料为衡量方法提供依据,没有为具体投资者属性提供数值。后文使用的数值完全来自设定的输入。
7 明确估计目标:不同信息条件下,固定批次的预期出资承诺数
设投资者i签署出资承诺的概率为式(1a)中的p_i。该概率等于准入指标G_i与以η_i为指标的概率单位模型(probit)项的乘积。式(1b)中的指标汇总了服从标准正态分布的排序因素S和一个二元项D。符合条件的会议使用同一指数,但门槛较低。实验假设排序模型已知结构与输入权重,因此结果是团队可从信息中获取价值的乐观基准。实际团队估计权重时会存在误差。
式(1)中,Φ是标准正态分布函数;τ_c是出资承诺门槛,设为2.90,会议门槛为1.20。若投资者i通过准入条件g,则g_ig为1;四项准入条件分别为资格E、投资授权M、出资金额T和接洽路径R。S_ik是第k项排序因素,涵盖策略匹配度、近期出资承诺和关系深度。若已识别决策者,D_i为1。b_k和b_D对应的权重依次为0.70、0.40、0.50和0.50。投资者未通过任一项准入条件时,无论排序得分多高,作出承诺的概率均为零。
排序模型使用八项字段中已核实的子集为初选名单中的投资者评分,其他字段仍使用供应商记录,并取分数最高的75名。V(A)是入选批次中各候选人的模型真实概率之和。它与仅依据供应商记录获得的数值之差,就是各信息条件下的增量。
8 构建包含1,500名投资者的模拟名单,明确通过率、权重和成本
名单包含六类共1,500名投资者。各类投资者通过每项准入条件的概率各不相同,见表3。规模越大,通过出资金额条件的概率越高。各排序因素服从标准正态分布;近期出资承诺与规模的相关系数为0.6。按投资者类别划分,能够识别决策者的比例介于35%至70%。在这些设定下,各项准入概率相乘,名单中约26%的投资者具备作出出资承诺的可能。这些输入为模拟实验而设,并非对真实投资者群体的估计。
横向滚动可查看全部列。
| 类型 | 占比 | 资格 | 投资授权 | 出资金额 | 接洽路径 | 决策者 |
|---|---|---|---|---|---|---|
| 公共养老金机构 | 15% | 0.95 | 0.45 | 0.65 | 0.70 | 0.50 |
| 主权或国有投资机构 | 10% | 0.97 | 0.55 | 0.60 | 0.75 | 0.35 |
| 家族办公室 | 35% | 0.80 | 0.70 | 0.75 | 0.95 | 0.70 |
| 母基金 | 15% | 0.90 | 0.50 | 0.70 | 0.85 | 0.60 |
| 基金会 | 10% | 0.92 | 0.40 | 0.55 | 0.60 | 0.50 |
| 保险机构 | 15% | 0.93 | 0.30 | 0.60 | 0.70 | 0.45 |
这些概率为模拟实验的设定值,以平均规模为基准。通过出资金额条件的概率随规模上升。数据并非市场观测值。
每位投资者都有一份含误差的供应商记录。表4列明各准入条件的记录准确率,以及各排序因素读数的噪声。关系深度的误差最大,因为相关信息来自募资方自己的往来记录,并非供应商数据。核实后以真实值替换含误差的读数。按表中列出的分析工时、每小时60美元计算,核实全部八项的成本为每位候选投资者135美元。
横向滚动可查看全部列。
| 属性 | 在指标中的作用 | 记录准确率或噪声 | 核实时间(分钟) | 指标权重 |
|---|---|---|---|---|
| 接收要约的资格 | 准入条件 | 0.90 | 20 | 准入条件 |
| 投资授权涵盖该策略与地区 | 准入条件 | 0.75 | 30 | 准入条件 |
| 出资金额区间和集中度上限 | 准入条件 | 0.80 | 15 | 准入条件 |
| 允许由顾问发起接洽 | 准入条件 | 0.70 | 10 | 准入条件 |
| 已确认决策者 | 二元项 | 0.65 | 15 | 0.50 |
| 投资策略与阶段匹配度 | 标准正态项 | 标准差1.0 | 25 | 0.70 |
| 近期同类出资承诺 | 标准正态项 | 标准差0.8 | 15 | 0.40 |
| 关系深度 | 标准正态项 | 标准差1.2 | 5 | 0.50 |
模型设定值。核实时间指分析人员处理每位候选投资者所需的分钟数,按每小时60美元计价。成本并非观测值。
9 用贝叶斯规则结合供应商记录、投资者类型和规模,核实后替换记录值
排序模型利用供应商记录和描述性字段提供的信息。对准入条件而言,先验通过概率取决于投资者类型和规模,再用供应商读数按式(2a)的胜算规则更新。对排序因素而言,近期出资承诺这一项的先验均值取决于规模,再用含误差的读数按式(2b)的正态更新规则调整。核实后的信息视为准确值。该设计充分利用仅有的记录信息,以免基准过弱而夸大核实带来的增量。
其中,π_ig是投资者i通过准入条件g的先验概率,带帽符号表示后验概率;a_g是供应商读数的准确率。记录显示通过时指数为正一,显示未通过时为负一。μ_0和v_0分别是排序因素的先验均值和方差,r是含误差的读数,噪声标准差为σ;带帽的均值和方差为后验值。式(3a)将准入通过概率与概率单位模型(probit)项的期望值相乘,得到评分。
式(3)中,带帽的g是准入条件的后验通过概率,核实后取1或0;带帽的q是已识别决策者的后验概率;带帽的μ和带帽σ的平方分别为排序因素形成的指标的均值和方差;W(A)为评分最高的K名候选人。平方根形式来自以下恒等关系:将标准正态分布函数作用于一个正态变量后取期望,等于将该函数作用于该变量的均值除以(1加该变量方差)的平方根所得的值。模型采用数值积分验证这一关系。
10 以随机选择和模型概率最高的批次为基准
从完整模拟名单中随机抽取75人,预期获得0.66份出资承诺。全名单中模型真实概率最高的75人的概率之和为10.76;这一基准假设掌握全部信息。仅使用供应商记录排序,预期获得5.14份出资承诺(占接洽数的6.9%),以及24.3场符合条件的会议。对初选名单核实全部八项信息后,预期获得9.31份出资承诺(12.4%)和47.2场符合条件的会议。表5比较这些结果。
横向滚动可查看全部列。
| 基准 | 单轮预期出资承诺数 | 占接洽数的比例(%) | 预期符合条件的会议数 |
|---|---|---|---|
| 从全名单随机抽取的批次 | 0.66 | 0.9 | 不适用 |
| 仅依供应商记录,并充分利用其信息 | 5.14 | 6.9 | 24.3 |
| 核实初选名单的全部八项信息 | 9.31 | 12.4 | 47.2 |
| 初选名单内的最优批次 | 9.31 | 12.4 | 不适用 |
| 全名单中概率最高的批次 | 10.76 | 14.3 | 不适用 |
Matchpoint对模拟名单的分析。结果为给定输入下的模型输出,并非观测结果。期望值取200次重复模拟的平均值。
在基础模拟中,若核实完全准确且准入条件不变,全面核实选出的批次与初选名单内概率最高的批次一致,预期出资承诺数均为9.31份。全名单基准为10.76份;两者差距反映了在该模型下将核实范围限定于初选名单的影响。相比仅按供应商记录排序,全面核实使预期出资承诺增加4.17份,增幅为81%。多次模拟中,增量的标准差为0.81,均值的95%区间半宽为0.11。随机选择提供一个参照,个别批次的表现可能低于该参照。
这一结果以排序模型已知权重和供应商记录准确率为前提。不了解这些参数的团队从同样的记录中获得的信息价值更低,核实所带来的增量可能更大。压力测试量化了这一变化方向。
11 仅按供应商记录选出的候选人约四成无法出资,原因在于未发现准入障碍
仅依据供应商记录形成的批次看似合适。75名候选人中,42%未通过至少一项准入条件,无法参加本次募集。投资授权是最大的单一障碍,涉及批次中24%的候选人;其次为出资金额(11%)、接洽路径(9%)和资格(5%)。图1列出各项比例。在活动记录中,这些障碍往往到对方答复时才显现,届时团队已花费接洽资源。
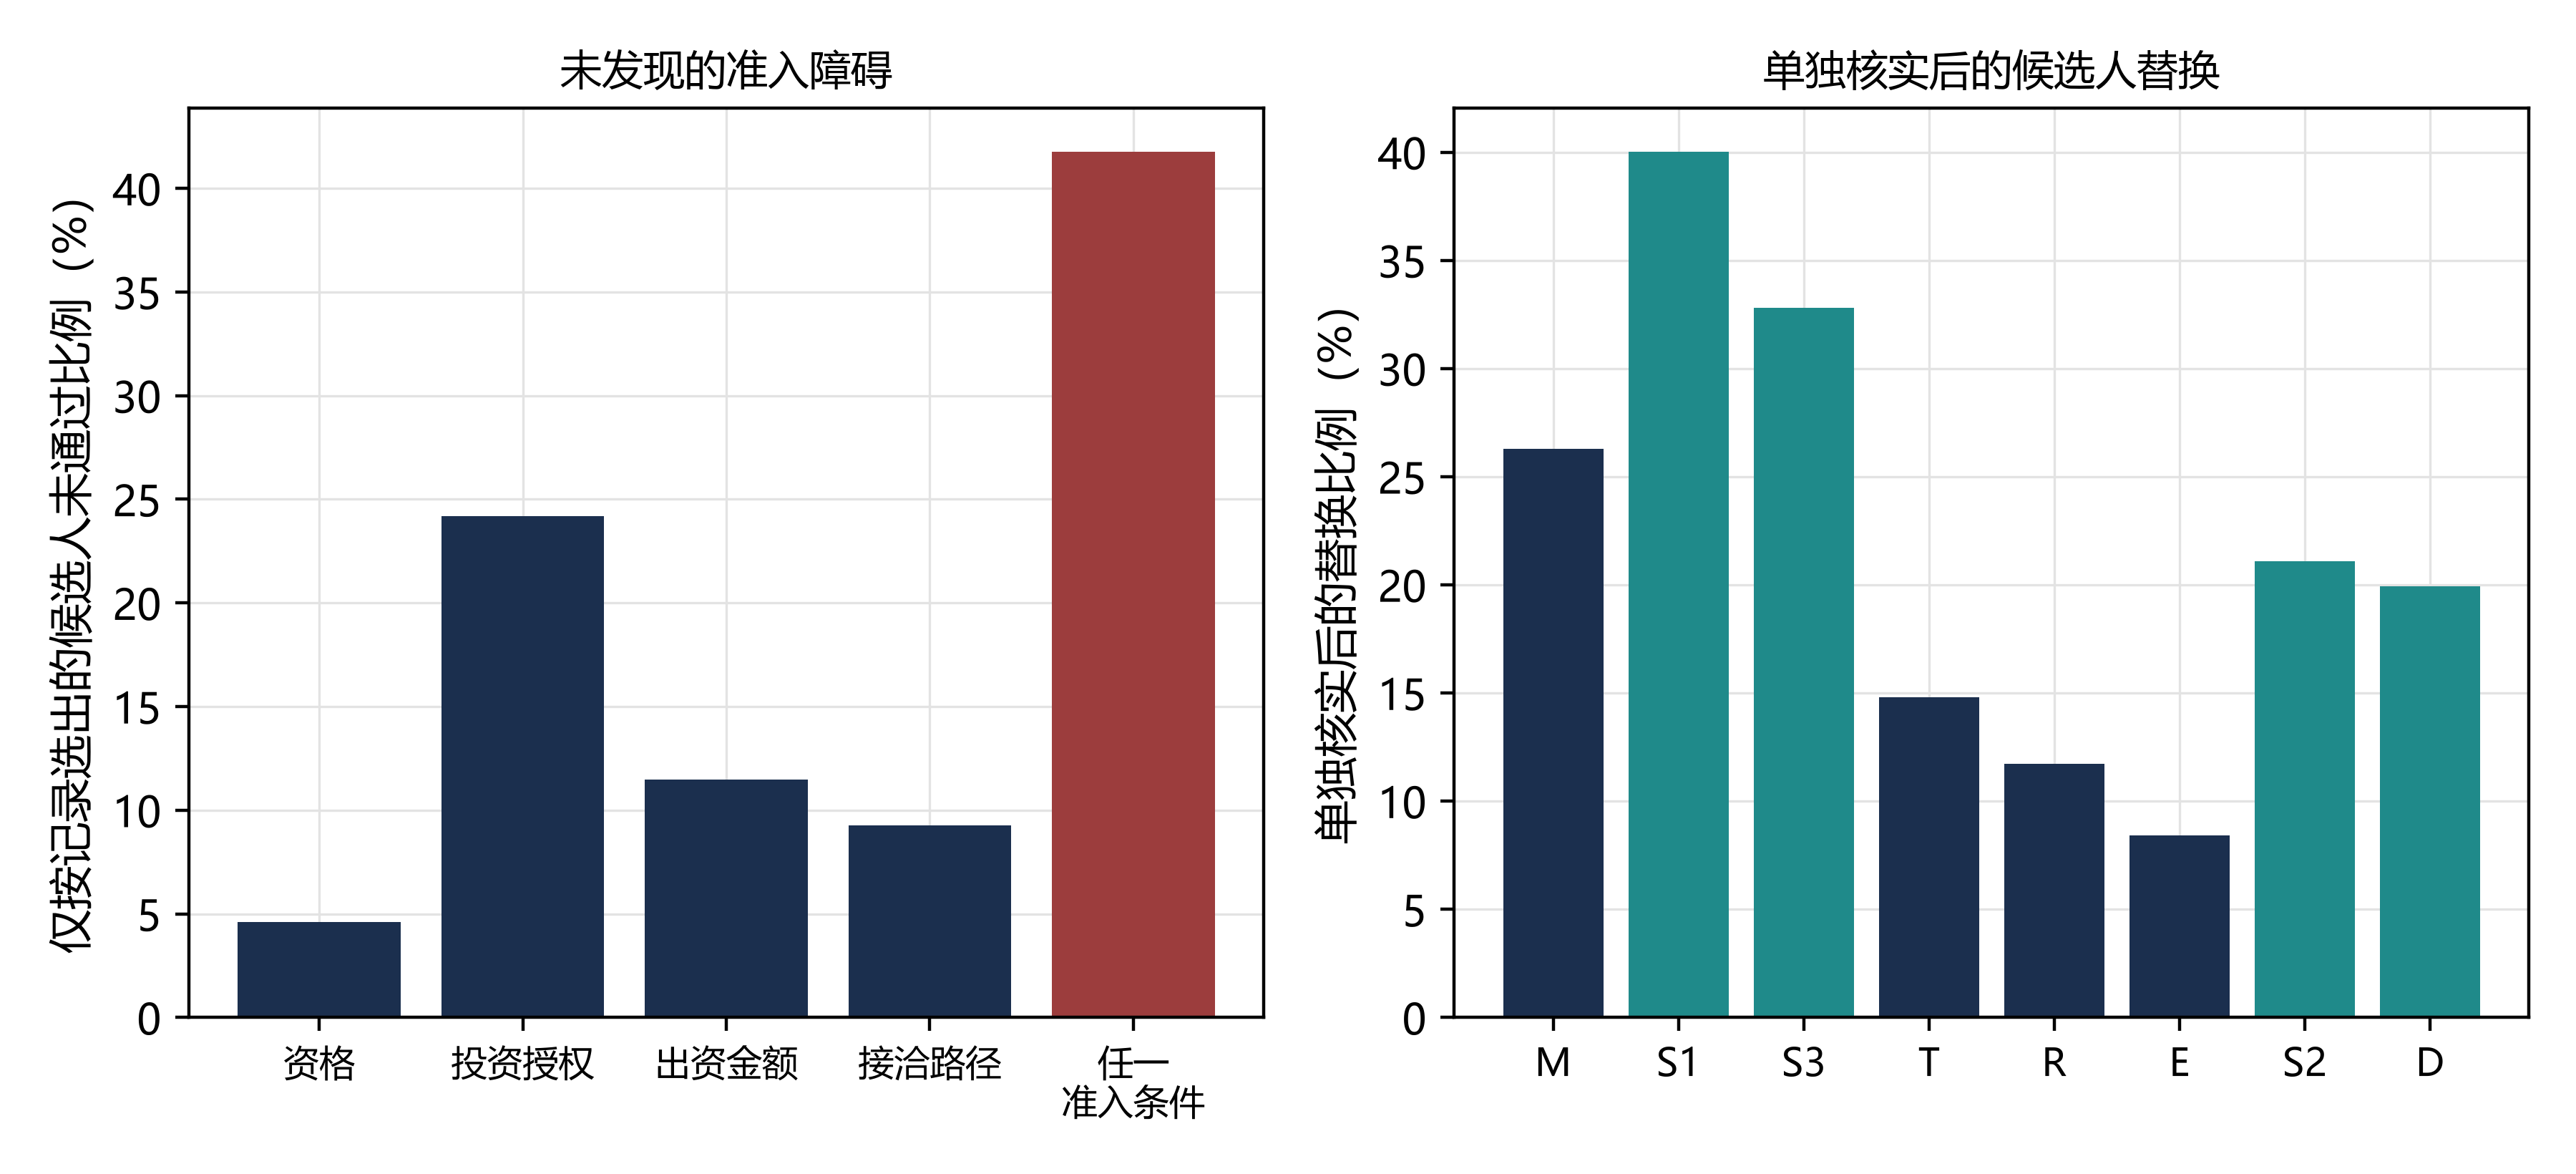
Matchpoint对模拟名单的分析。结果为给定输入下的模型输出,并非观测结果。 左:仅按供应商记录选出的候选人未通过各项准入条件的比例。右:单独核实各项信息时被替换的候选人比例。
核实还会改变批次构成。单独核实策略匹配度会替换40%的候选人;核实关系深度会替换33%;核实投资授权会替换26%。核实全部四项准入条件会替换43%,核实全部八项信息会替换58%。在基础模型的设定下,核实四项准入条件后,批次内所有候选人都通过筛选。若只核实三项排序因素,仍有47%的候选人无法作出出资承诺,高于原来的42%。这是因为新的排序把一些分数高但未通过准入条件的候选人排到了前面。详见表6。
横向滚动可查看全部列。
| 核实项 | 仅按记录选出的候选人未通过该条件的比例 | 候选人替换比例 | 批次中仍无法出资的候选人比例 |
|---|---|---|---|
| 投资授权涵盖该策略与地区 | 24% | 26% | 25% |
| 投资策略与阶段匹配度 | 不适用 | 40% | 45% |
| 关系深度 | 不适用 | 33% | 44% |
| 出资金额区间和集中度上限 | 11% | 15% | 35% |
| 允许由顾问发起接洽 | 9% | 12% | 37% |
| 接收要约的资格 | 5% | 8% | 39% |
| 近期同类出资承诺 | 不适用 | 21% | 43% |
| 已确认决策者 | 不适用 | 20% | 42% |
| 核实全部四项准入条件 | 42%未通过至少一项准入条件 | 43% | 0% |
| 核实全部八项信息 | 42%未通过至少一项准入条件 | 58% | 0% |
Matchpoint对模拟名单的分析。结果为给定输入下的模型输出,并非观测结果。 未通过率在核实日对仅按供应商记录选出的候选人计算,替换比例也以同一批次为参照。
按模拟结果,跳过准入核实会导致团队接洽的候选人中约四成无法出资。资格障碍在75人的批次中相当于3.5次接洽,并可能带来监管风险。模型只计量出资承诺数,未对该风险定价。因此,后文的盈亏平衡计算未能充分反映核实资格的价值。
12 按设定权重,投资授权和策略匹配度合计贡献约一半增量
表7列出每项信息的三种价值。单独核实衡量仅核实该项所带来的增量;最后核实衡量在其余各项均已核实的报告中,省略该项所造成的损失。式(4a)将夏普利值定义为所有可能核实顺序下的平均边际增量。根据式(4b),各项夏普利值加总等于总增量。
J为八项信息组成的集合,A为其子集,V为式(3b)定义的批次价值。投资授权的夏普利值为1.098份预期出资承诺,占增量的26%;策略匹配度为1.001份,占24%。两者合计约占总增量的一半。两个数值相近,且均未计算区间,因此不能据此判定哪一项更重要。其余依次为关系深度(0.599)、出资金额(0.481)、接洽路径(0.342)、资格(0.252)、近期出资承诺(0.213)和决策者(0.184)。图2列出各项信息的三个衡量值。
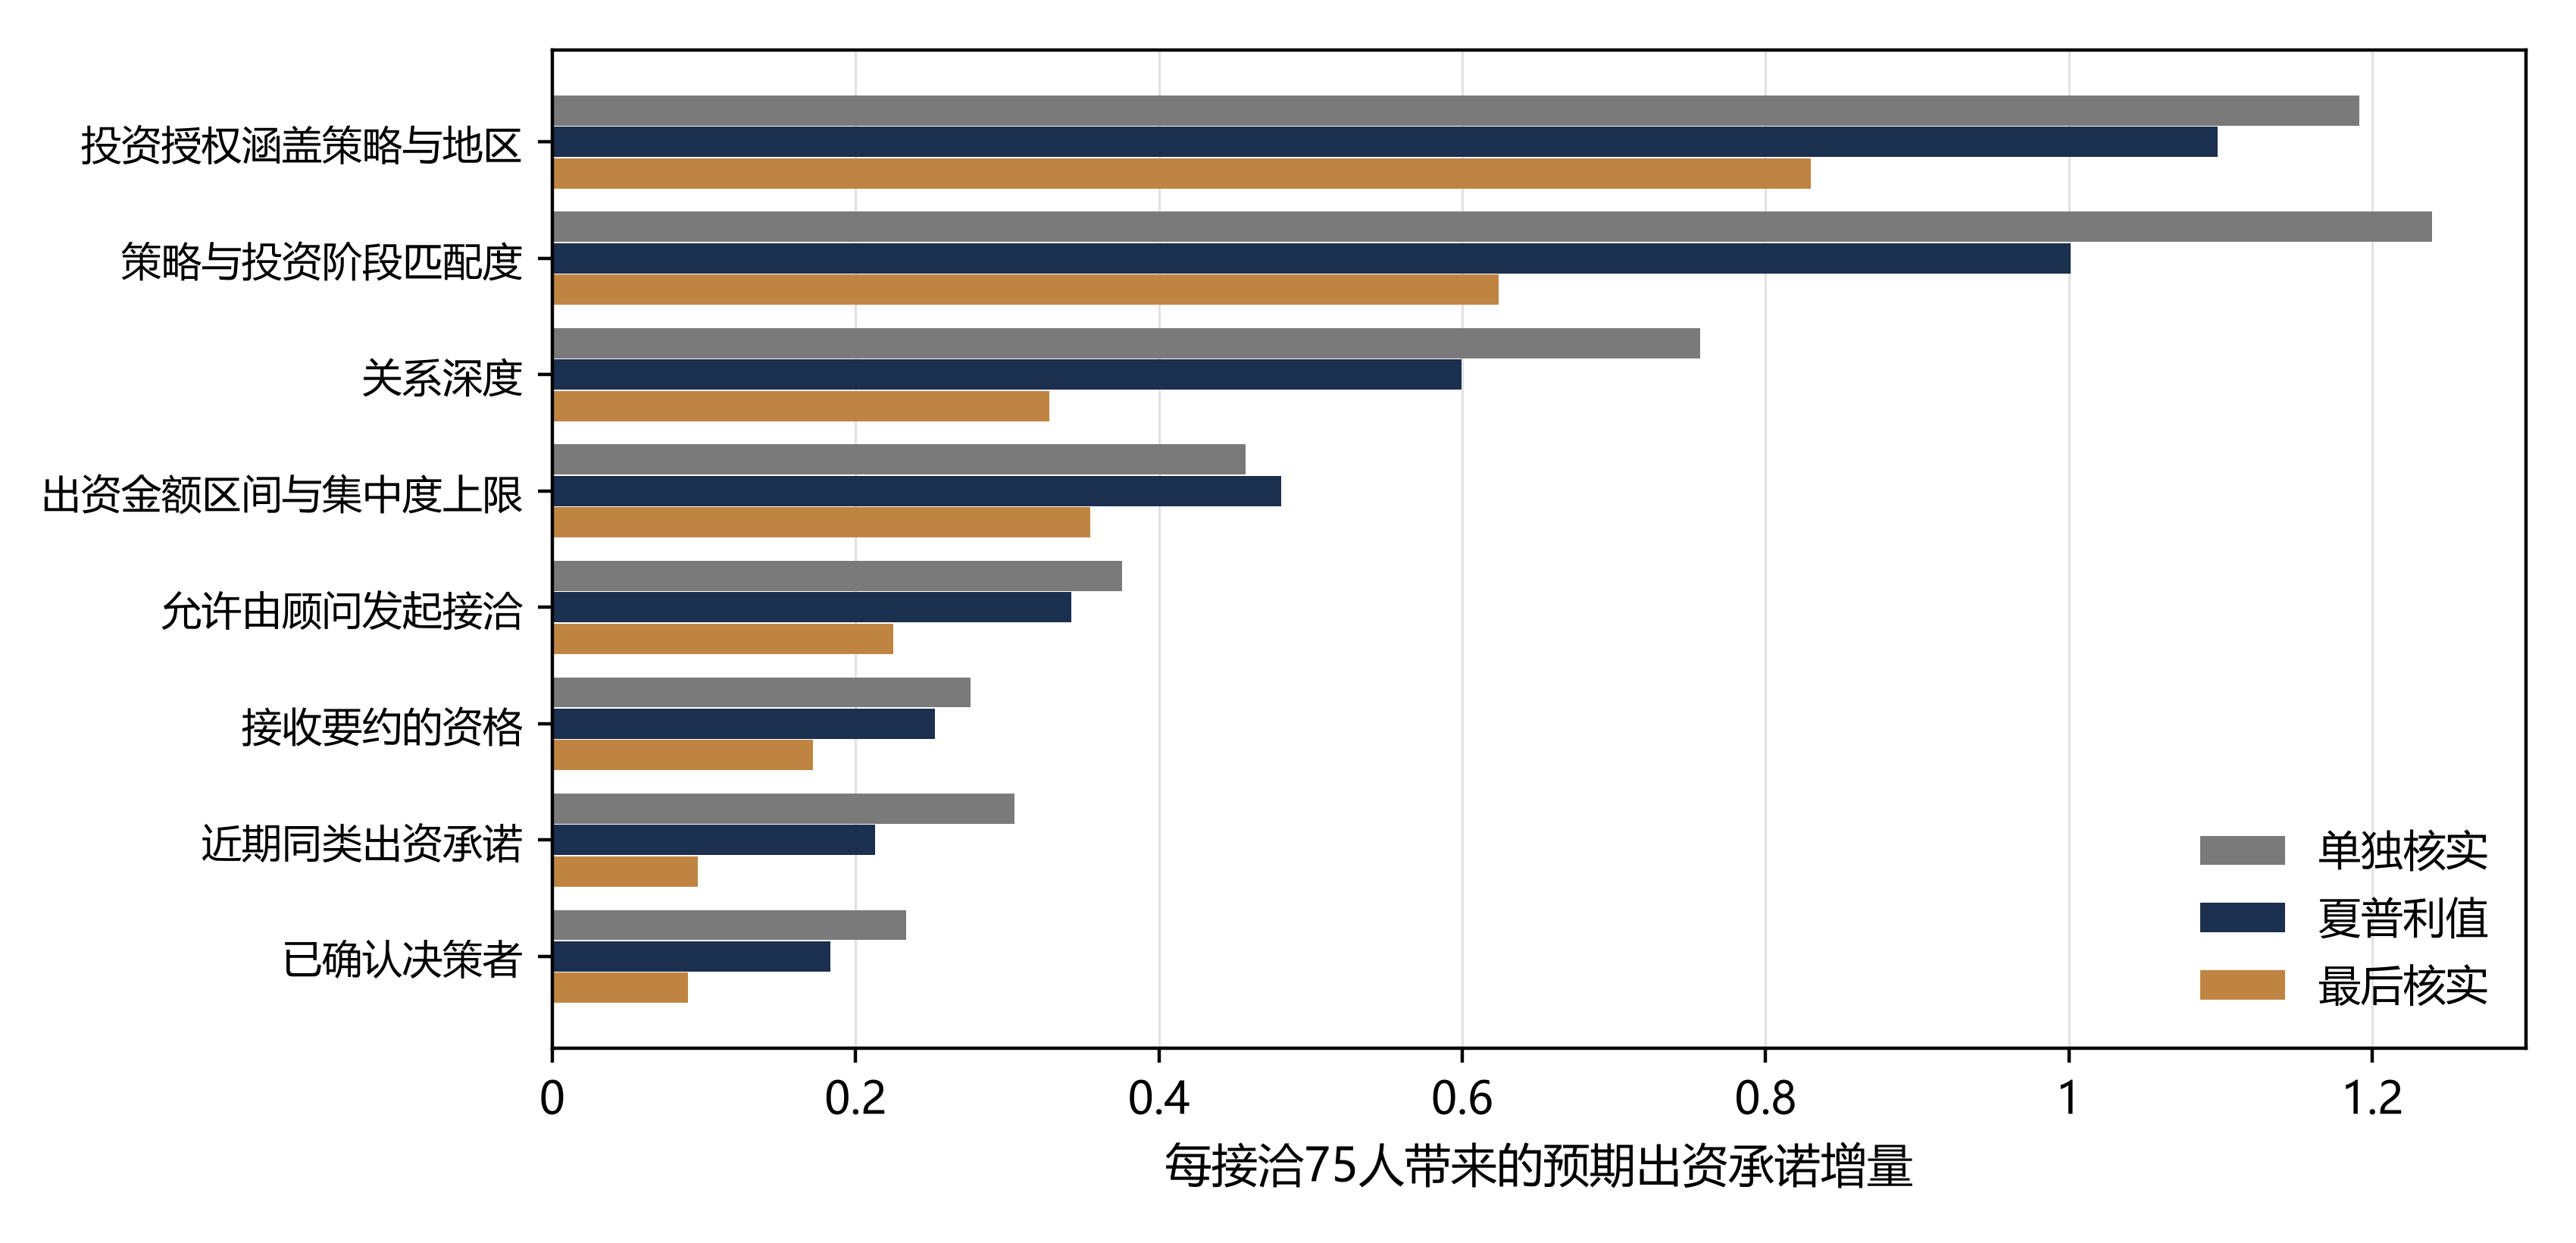
Matchpoint对模拟名单的分析。结果为给定输入下的模型输出,并非观测结果。 以接洽75人的批次中预期出资承诺数的增量衡量。
横向滚动可查看全部列。
| 属性 | 单独核实 | 最后核实 | 夏普利值 | 占增量的比例 | 每份出资承诺的盈亏平衡值(美元) |
|---|---|---|---|---|---|
| 投资授权涵盖该策略与地区 | 1.191 | 0.830 | 1.098 | 26% | 8,197 |
| 投资策略与阶段匹配度 | 1.239 | 0.624 | 1.001 | 24% | 7,491 |
| 关系深度 | 0.757 | 0.328 | 0.599 | 14% | 2,502 |
| 出资金额区间和集中度上限 | 0.457 | 0.354 | 0.481 | 12% | 9,363 |
| 允许由顾问发起接洽 | 0.376 | 0.225 | 0.342 | 8% | 8,767 |
| 接收要约的资格 | 0.276 | 0.172 | 0.252 | 6% | 23,775 |
| 近期同类出资承诺 | 0.305 | 0.096 | 0.213 | 5% | 21,159 |
| 已确认决策者 | 0.234 | 0.090 | 0.184 | 4% | 24,512 |
Matchpoint对模拟名单的分析。结果为给定输入下的模型输出,并非观测结果。 盈亏平衡值等于核实初选名单中该项信息的成本除以夏普利值。每份签署的出资承诺价值超过这一门槛时,核实投入才有回报。
三种衡量结果的差异符合理论预期。单独核实值合计4.83份,最后核实值合计2.72份,总增量为4.17份。各字段之间存在信息重叠,例如已知投资授权后,再了解出资金额的增量价值会下降。因此,单独核实值的合计高估了增量,最后核实值的合计则低估了增量。只有对所有顺序取平均,合计才与总增量一致。按盈亏平衡列计算,如果一份出资承诺对募资方的价值超过约24,512美元,每一项都值得核实;成本较低的项目在约2,502美元时即可回收成本。门槛依据表4的假定工时和每小时60美元费率计算,只计出资承诺。本文未判断实际业务能否达到这些门槛。
13 核实五项信息,用不到三分之二的成本取得九成增量
报告可省去部分字段的核实。一种方法在每一步选取单位美元成本带来额外增量最大的字段;另一种方法遍历全部256个子集,找出达到目标的最低成本组合。表8和图3给出第一种方法的顺序:先核实S3、再核实S1和R,然后再核实其余字段。关系深度最先核实,因为只需五分钟;投资授权需三十分钟,因此排在后面。
在式(5)中,L为初选名单规模,c_j为核实每名候选人第j项信息的成本,φ_j为该项的夏普利值,B_j为使核实工作达到盈亏平衡所需的每份出资承诺价值。ρ_j(A)为集合A已核实时,第j项每美元成本带来的增量。达到90%增量的最低成本组合为M、T、R、S1、S3,成本为25,500美元,相当于核实全部八项所需40,500美元的63%。达到95%增量需要核实E、M、T、R、S1、S3,成本占全部费用的78%。
横向滚动可查看全部列。
| 步骤 | 新增核实项 | 累计成本(美元) | 预期出资承诺数 | 占总增量的比例 |
|---|---|---|---|---|
| 1 | 关系深度 | 1,500 | 5.90 | 18% |
| 2 | 投资策略与阶段匹配度 | 9,000 | 7.04 | 45% |
| 3 | 允许由顾问发起接洽 | 12,000 | 7.40 | 54% |
| 4 | 投资授权涵盖该策略与地区 | 21,000 | 8.46 | 79% |
| 5 | 出资金额区间和集中度上限 | 25,500 | 8.90 | 90% |
| 6 | 接收要约的资格 | 31,500 | 9.11 | 95% |
| 7 | 近期同类出资承诺 | 36,000 | 9.22 | 98% |
| 8 | 已确认决策者 | 40,500 | 9.31 | 100% |
Matchpoint对模拟名单的分析。结果为给定输入下的模型输出,并非观测结果。 成本按初选名单规模乘以每名候选人所需的核实时间计算,费率为每小时60美元。
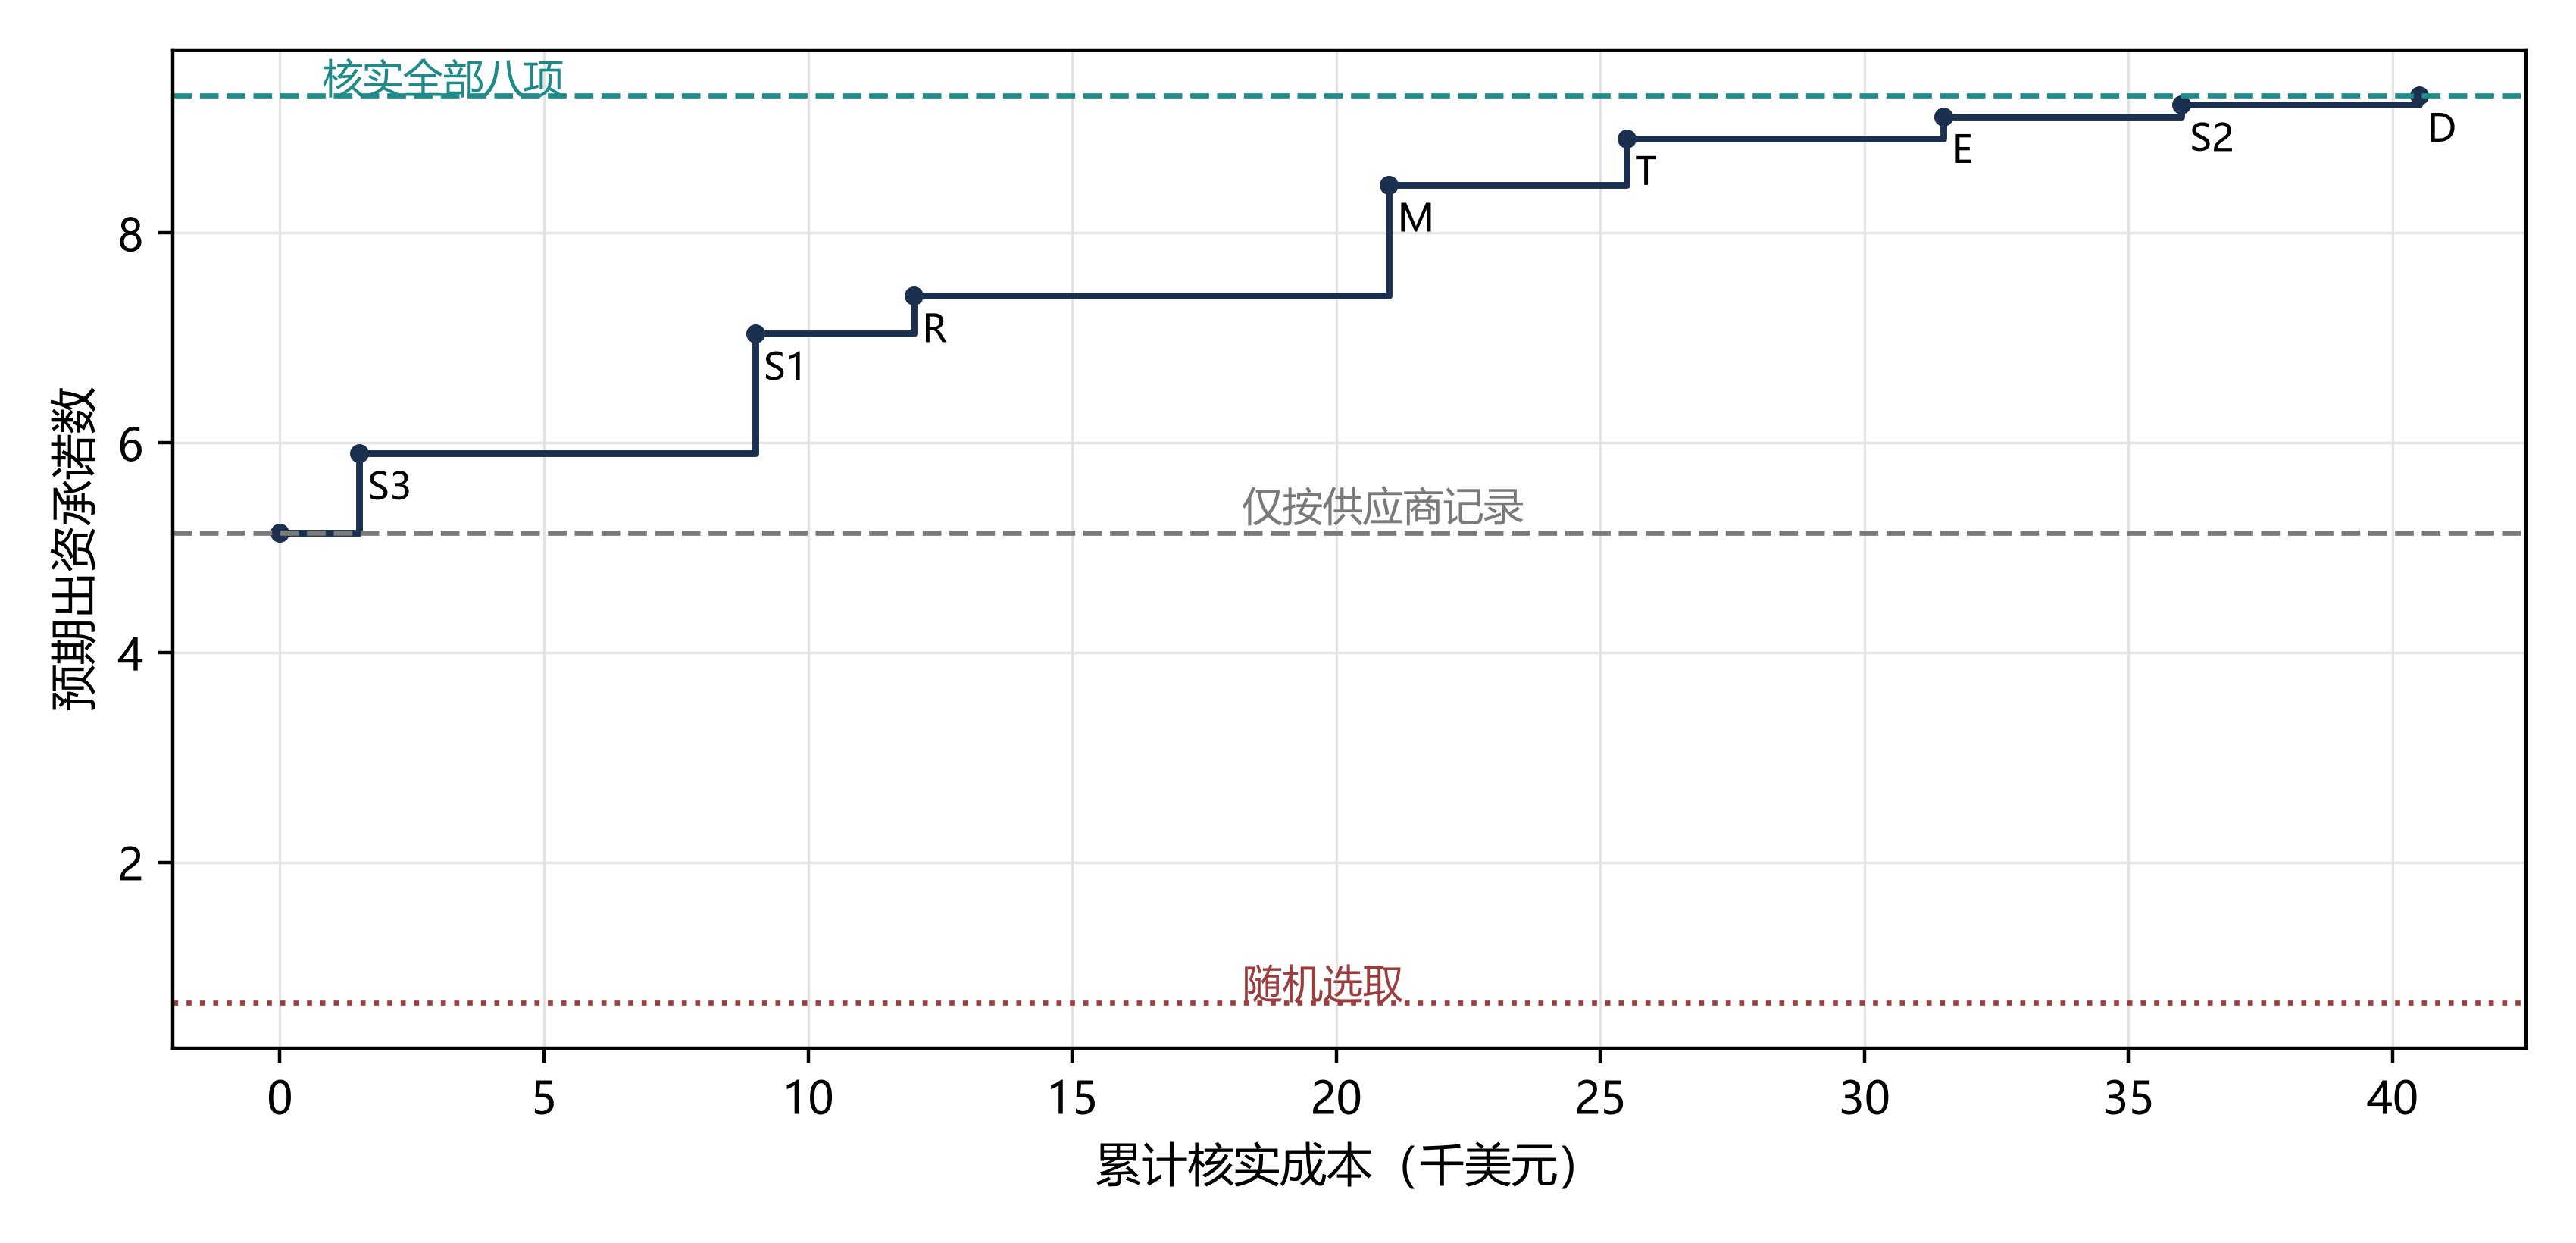
Matchpoint对模拟名单的分析。结果为给定输入下的模型输出,并非观测结果。 按每美元成本带来的边际增量依次加入各项。虚线分别表示仅依供应商记录和全面核实,点线表示随机选择。
增加核实项所带来的边际收益逐步递减,没有明显断点。最后三项合计贡献约一成增量,耗费超过三分之一的预算。最精简的组合取决于模型设定。在实际操作中,团队可根据已掌握的信息,按每美元成本的额外收益选择下一核实项。固定字段顺序的报告无法根据现有信息调整核实优先级。
14 在模拟案例中,描述性字段有助于初选,对最终排序没有额外贡献
供应商记录包含易于收集的字段,例如投资者类型、规模、人员数量和公众知名度。在实验中,类型改变各项准入条件的基础通过率,规模影响出资金额条件和近期投资活动。人员数量和公众知名度是含误差的规模代理指标,没有独立影响。表9和图4分别衡量三个情形:单独使用各字段;仅使用供应商记录时,在其余三个字段之后加入该字段;以及八项信息均已核实时,最后加入该字段。
横向滚动可查看全部列。
| 描述性字段 | 单独使用,仅用记录 | 最后加入,仅用记录 | 最后加入,全部核实(仅影响初选) |
|---|---|---|---|
| 投资者类型 | 0.390 | 0.348 | 0.275 |
| 规模(管理资产规模的对数) | 0.172 | 0.055 | 0.085 |
| 人员数量 | 0.119 | 0.000 | 0.000 |
| 公众知名度 | 0.068 | 0.000 | 0.000 |
Matchpoint对模拟名单的分析。结果为给定输入下的模型输出,并非观测结果。 以75次接洽为一批,衡量预期出资承诺数的增量,共重复80次。第三列仅衡量形成初选名单所带来的价值。
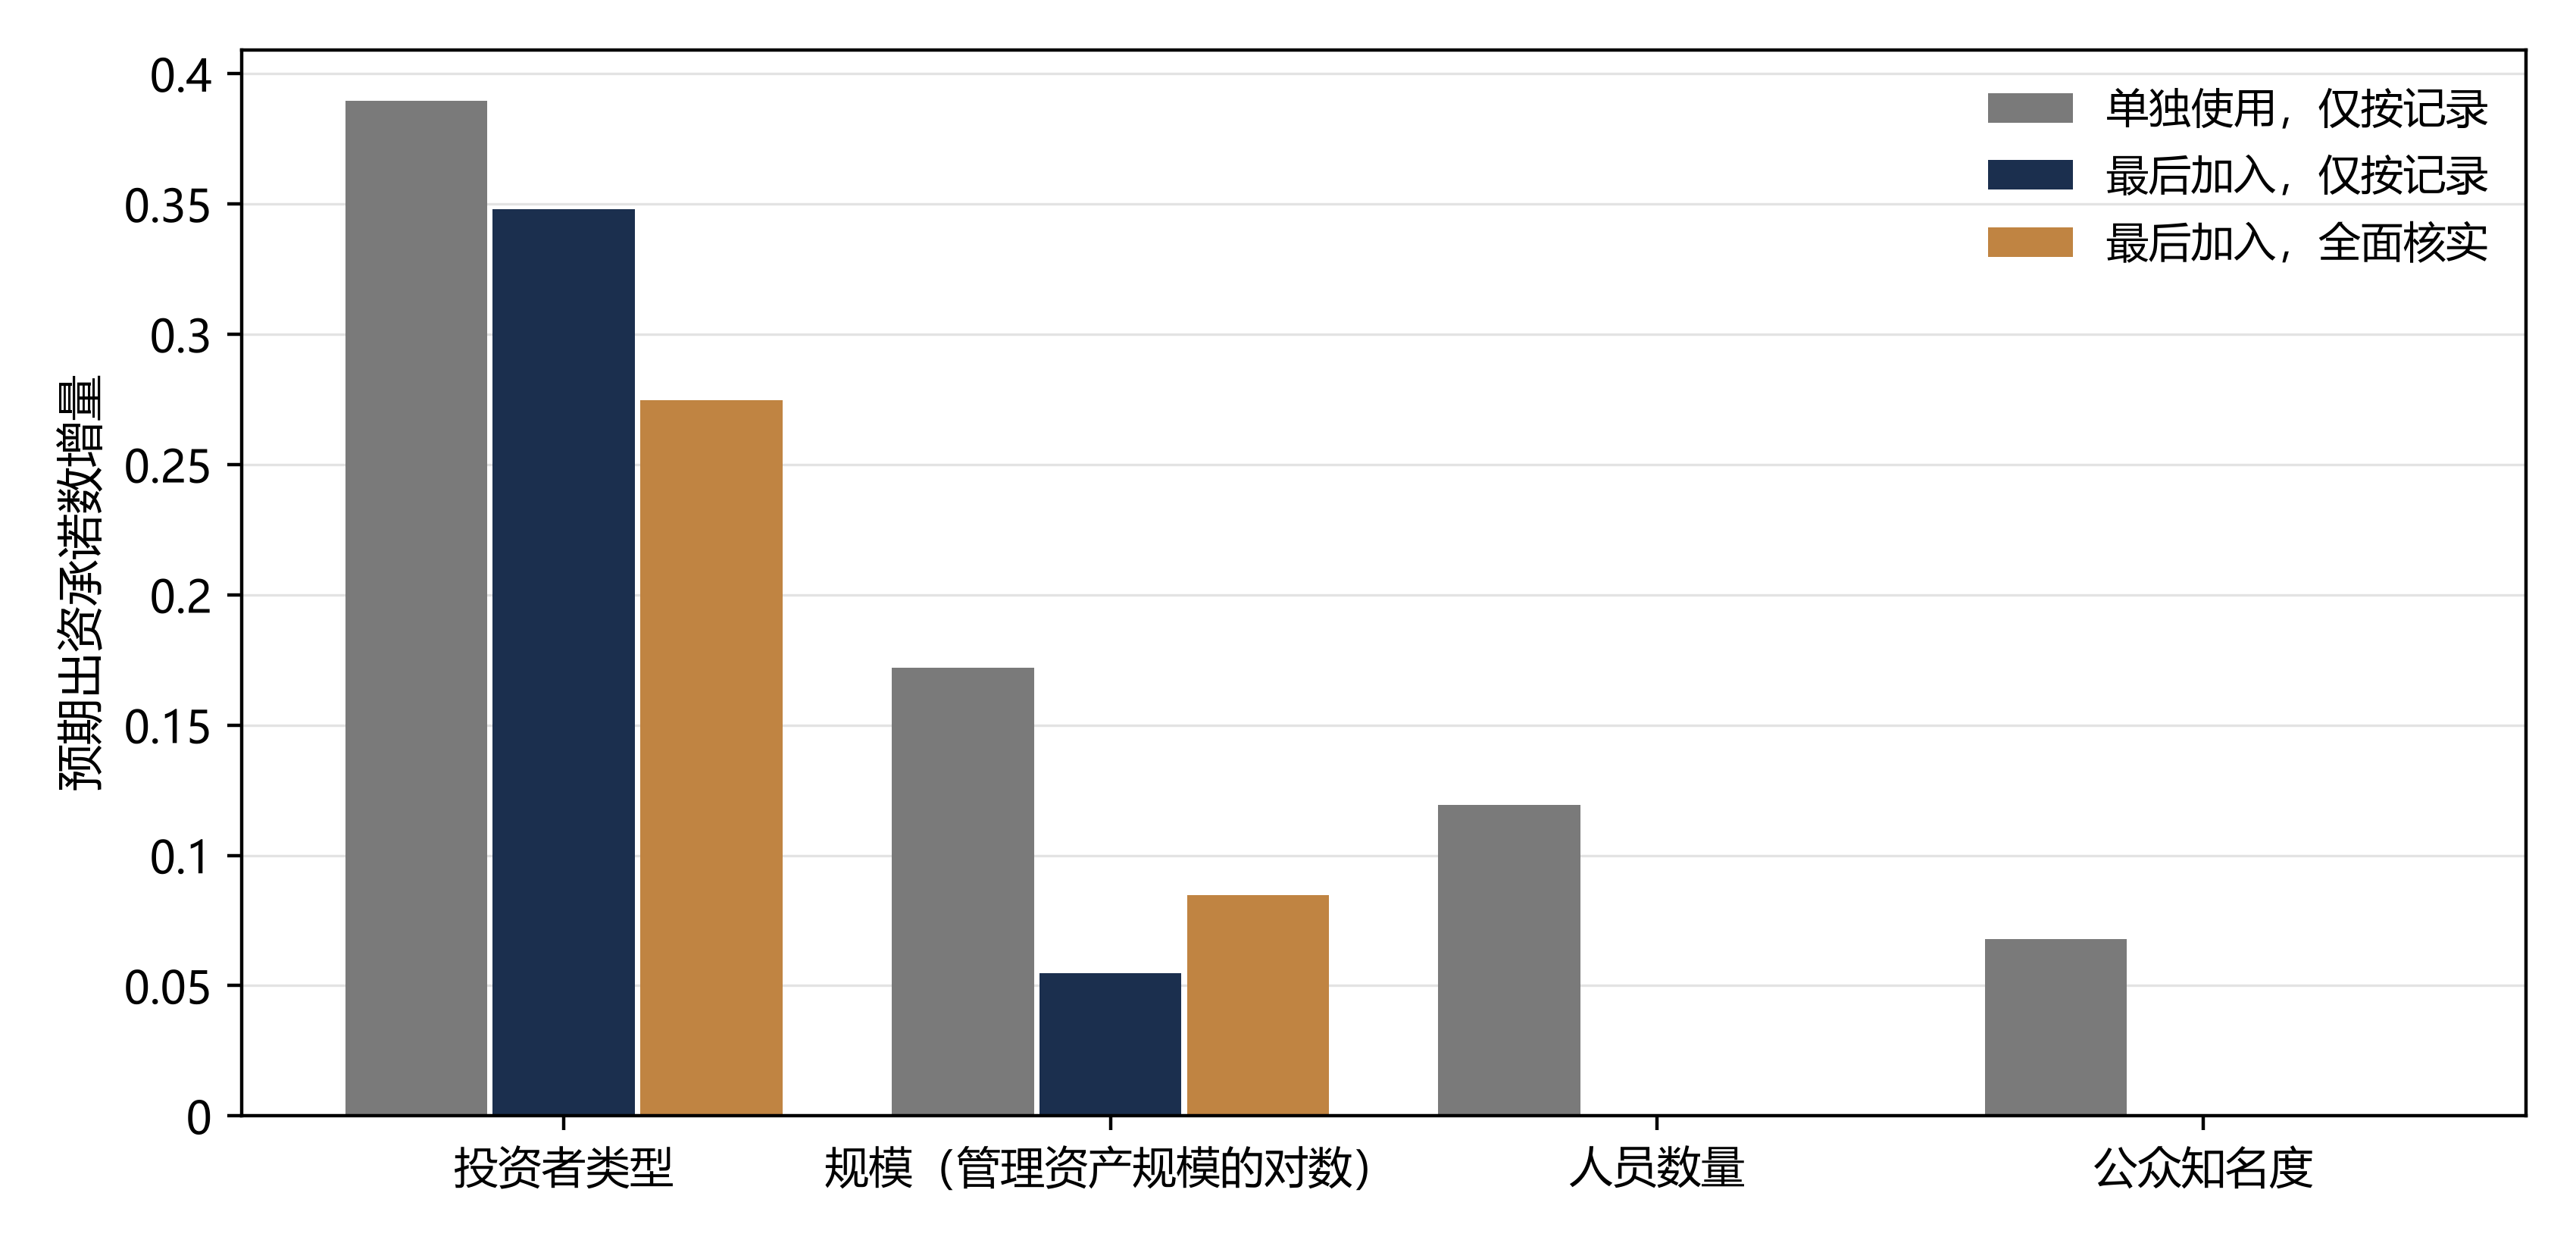
Matchpoint对模拟名单的分析。结果为给定输入下的模型输出,并非观测结果。 按描述性字段和信息条件列出预期出资承诺数的增量。
单独使用时,类型的价值为0.390份预期出资承诺,规模为0.172份,人员数量为0.119份,公众知名度为0.068份。后两项单独使用时看似有效,因为都是规模的代理指标。若在规模已知后最后加入,两项分别贡献0.000份和0.000份。仅使用记录时,类型仍贡献0.348份;核实全部八项时,仍贡献0.275份。后一个数值源于初选发生在核实之前,较准确的先验信息有助于选择核实对象。这属于初步筛选的价值。规模也通过同一途径贡献0.085份。
这一区分涉及两项决策。类型和规模有助于确定哪些候选人值得分析人员投入时间。准入条件和排序因素核实后,这两项对最终批次的排序没有额外贡献。把人员数量和公众知名度与核实字段并列,可能使读者高估它们在本案例中的作用。实际数据中它们是否有独立价值,需要按后文的取证设计检验。
15 接洽批次与初选名单的规模改变各字段的重要性
一项信息的价值取决于接洽对象占名单的比重。图5将初选名单固定为300人,再改变批次规模。接洽25人时,核实三项排序因素带来1.51份预期出资承诺增量,核实四项准入条件带来1.42份,两者相近。接洽150人时,准入条件带来2.50份增量,排序因素带来1.72份。小批次可从名单前端选足对象,排序与剔除同样重要。大批次可能纳入未通过准入条件的候选人,此时核实准入条件的作用更大。
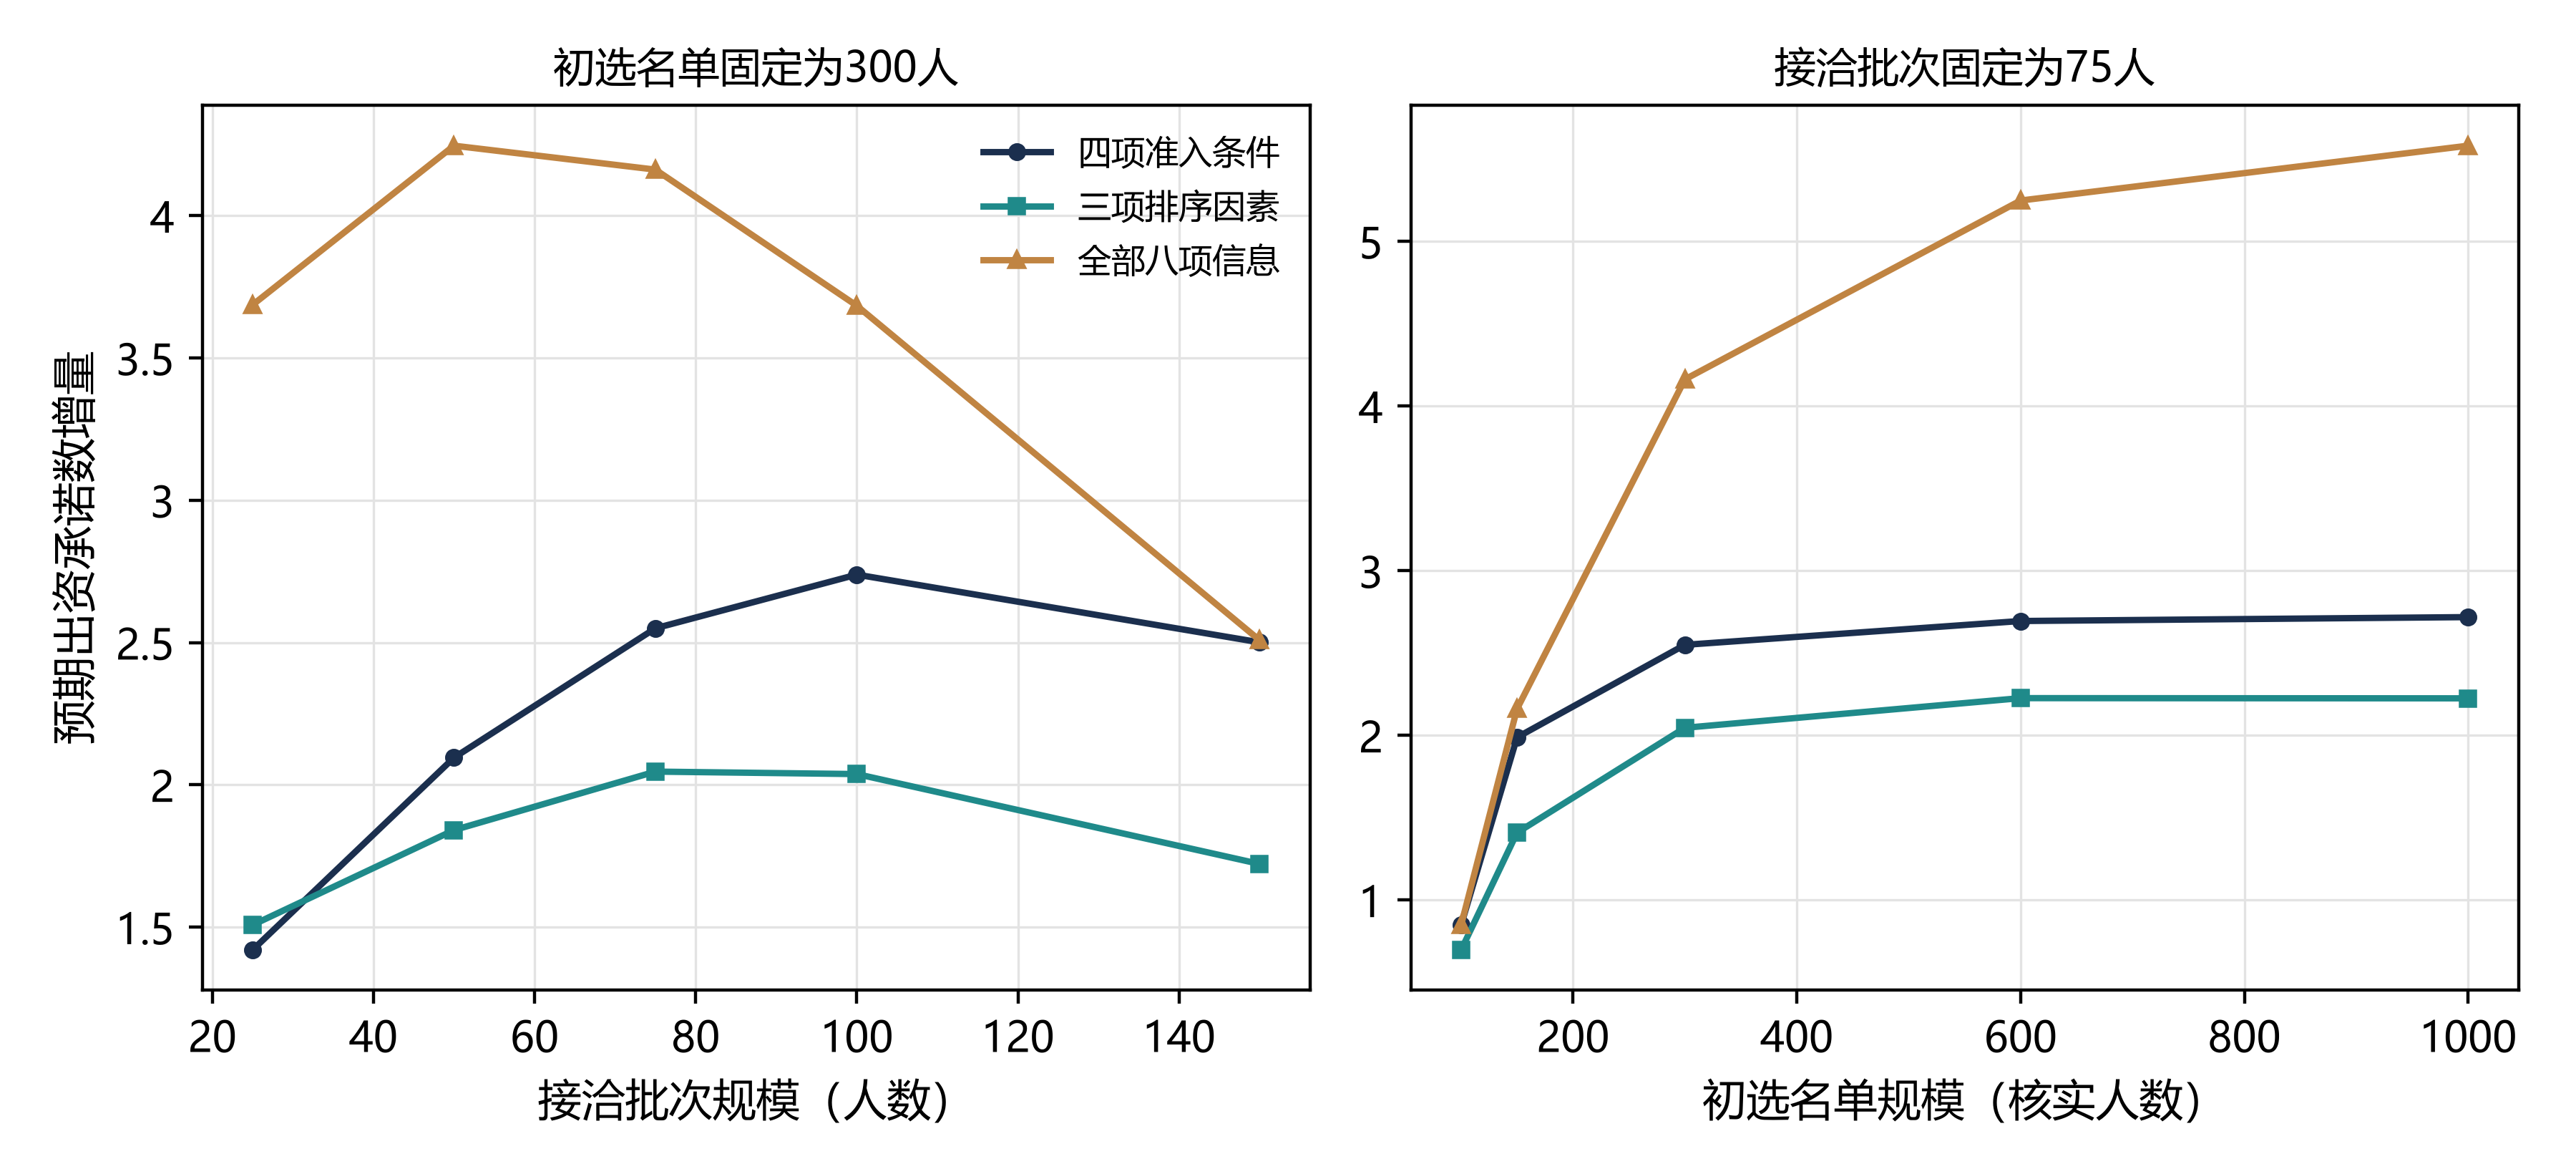
Matchpoint对模拟名单的分析。结果为给定输入下的模型输出,并非观测结果。 比较核实准入条件、排序因素和全部八项信息相对于仅按记录排序的增量。每个点重复60次。
右图将接洽人数固定为75人,改变初选名单的规模。核实100人带来0.85份预期出资承诺增量;核实1,000人带来5.58份。每投入10,000美元所增加的预期出资承诺数,在初选100人时为0.63份,150人时为1.07份,300人时为1.03份,600人时为0.65份,1,000人时为0.41份。初选人数为接洽人数的两至四倍时,单位成本收益最高,继续扩大则效率下降。若两者规模相同,就无从筛选;若初选范围过大,则会为不会接洽的对象支付核实成本。
这一操作建议取决于模型输入。先核实由接洽规模决定、对该批次最关键的字段。除非实际核实成本远低于本文设定,否则初选人数可设为接洽人数的两至四倍。接洽批次规模变化时,应重新计算应核实的字段。
16 压力情景提示不同问题应排查哪些因素
表10每次只改变一个输入。核实结果过期的情景按0.25的概率,在接洽日重新抽取各项准入条件的状态。核实有误的情景按0.05的概率反转各项已核实的准入判断,并给排序因素的读数加入噪声。市场转冷时,两个门槛均上调0.5。排序模型权重设置有误时,三项排序因素的权重由0.70、0.40、0.50改为0.20、0.80、0.20。供应商记录质量低或高的情景则改变记录准确率。
横向滚动可查看全部列。
| 情景 | 仅用供应商记录 | 全部核实 | 增量 | 仅按记录选择时批次中无法出资的比例 | 同上,全部核实 | 本可出资却被错误剔除的候选人 | 诊断信号 |
|---|---|---|---|---|---|---|---|
| 基础输入 | 5.15 | 9.32 | 4.17 | 42% | 0.0% | 0% | 参照 |
| 核实结果过期 | 4.68 | 7.33 | 2.65 | 47% | 21.0% | 0% | 增量下降;已核实候选人在接洽时未通过 |
| 核实错误 | 5.15 | 7.49 | 2.34 | 42% | 4.7% | 18% | 增量下降;错误剔除在接洽批次中不可见 |
| 市场转冷 | 2.55 | 4.35 | 1.80 | 44% | 0.0% | 0% | 准入在增量中的份额基本不变;预期数下降 |
| 排序模型权重设置有误 | 3.88 | 7.30 | 3.42 | 42% | 0.0% | 0% | 准入增量基本不变;排序增量下降 |
| 供应商记录质量低 | 3.62 | 7.87 | 4.25 | 55% | 0.0% | 0% | 相对增幅上升;准入条件贡献最大 |
| 供应商记录质量高 | 8.08 | 10.49 | 2.41 | 19% | 0.0% | 0% | 增量收窄;剩余核实空间小 |
Matchpoint对模拟名单的分析。结果为给定输入下的模型输出,并非观测结果。 以接洽75人为一批计算预期出资承诺数,每个情景重复100次。
核实结果过期时,增量从4.17份降至2.65份,已核实批次中有21.0%的候选人在接洽时无法出资。实务中可观察到先前被判定合格的候选人后来未能通过。出现核实错误时,增量降至2.34份。有18%本可承诺出资的候选人被错误剔除,这一损失不会在接洽批次中显现。可见的后期未通过比例仅为4.7%。抽查一部分被剔除的候选人,寻找可能漏掉的合格对象。
市场转冷使增量降至1.80份,准入条件所占的增量份额为62%,基础情景为61%。预期出资承诺数约减半,准入条件与排序因素之间的贡献分配基本不变。权重设置有误时,核实准入条件带来的增量基本维持在2.17份,但核实排序因素带来的增量减少45%。准入判断不用这些权重,因此错误主要影响排序。供应商记录质量较低时,绝对增量为4.25份,与基准相近,但相对较低的仅按记录排序的预期数,相当于118%的增幅。记录质量较高时,增量降至2.41份。供应商记录越弱,核实带来的增量越大。
用这些表现确定排查方向。接洽后才发现未通过条件时,应复核核实日期和此后发生的变化。若增量较大且主要来自准入条件,应以独立证据验证供应商记录。若剔除决定可靠而重新排序收效甚微,应检查权重。每种表现都可能有多种成因,仅凭出资承诺数无法诊断。
17 会议与出资承诺的统计功效
实际募资团队需要验证,按核实信息排序是否优于只按供应商记录排序。表11给出所需样本量。在模型中,仅按记录排序时,32.4%的接洽带来符合条件的会议;按核实信息排序时,比例为63.0%。在双侧显著性水平为5%、统计功效为80%的条件下,要检出这一差异,每组需要42次接洽;每组接洽75次时,功效为97%。两种排序方法的出资承诺率分别为6.9%和12.4%,所需样本量为每组443次;每组只接洽75次时,功效为21%。
横向滚动可查看全部列。
| 结果 | 仅按记录排序时的发生率(%) | 核实后排序时的发生率(%) | 达到80%统计功效所需的每组接洽次数 | 每组一个接洽批次时的统计功效(%) |
|---|---|---|---|---|
| 符合条件的会议 | 32.4 | 63.0 | 42 | 97 |
| 已签署的出资承诺 | 6.9 | 12.4 | 443 | 21 |
Matchpoint对模拟名单的分析。结果为给定输入下的模型输出,并非观测结果。 采用两独立样本比例检验;统计功效基于20,000次模拟试验。
这些计算假设各次接洽独立,且结果发生率已给定。实际活动中的共同环境、重复出现的投资者和溢出效应都可能改变估计精度。前瞻性实地研究应考虑分配单位和聚类,再按合格群体的实际发生率估计所需样本量。这些规划数值无法证明核实能够改善结果。
18 选择偏差与随机探索的成本
实际数据面临结果只在部分候选人中可见的问题。历史记录仅包含旧排序选中且实际接洽过的候选人的结果。用这些记录评估新排序时,只能看到新旧方法都选中的候选人的结果。新纳入的候选人原来排名较低,没有接洽结果记录。朴素估计法以重合候选人的平均结果推算整个批次。
式(6)中,W_B为新排序选出的批次;若早期活动接洽过投资者i,则A_i为1;y_i为观测到的会议结果;π_i为i被接洽的概率。早期批次内的候选人π等于1。初选名单中的其余候选人按概率ε随机接洽,其π等于ε。式(6b)给出逆概率加权估计量。估计目标是新批次的预期会议数,模型值为47.09场。表12和图6列出两种估计量的误差。
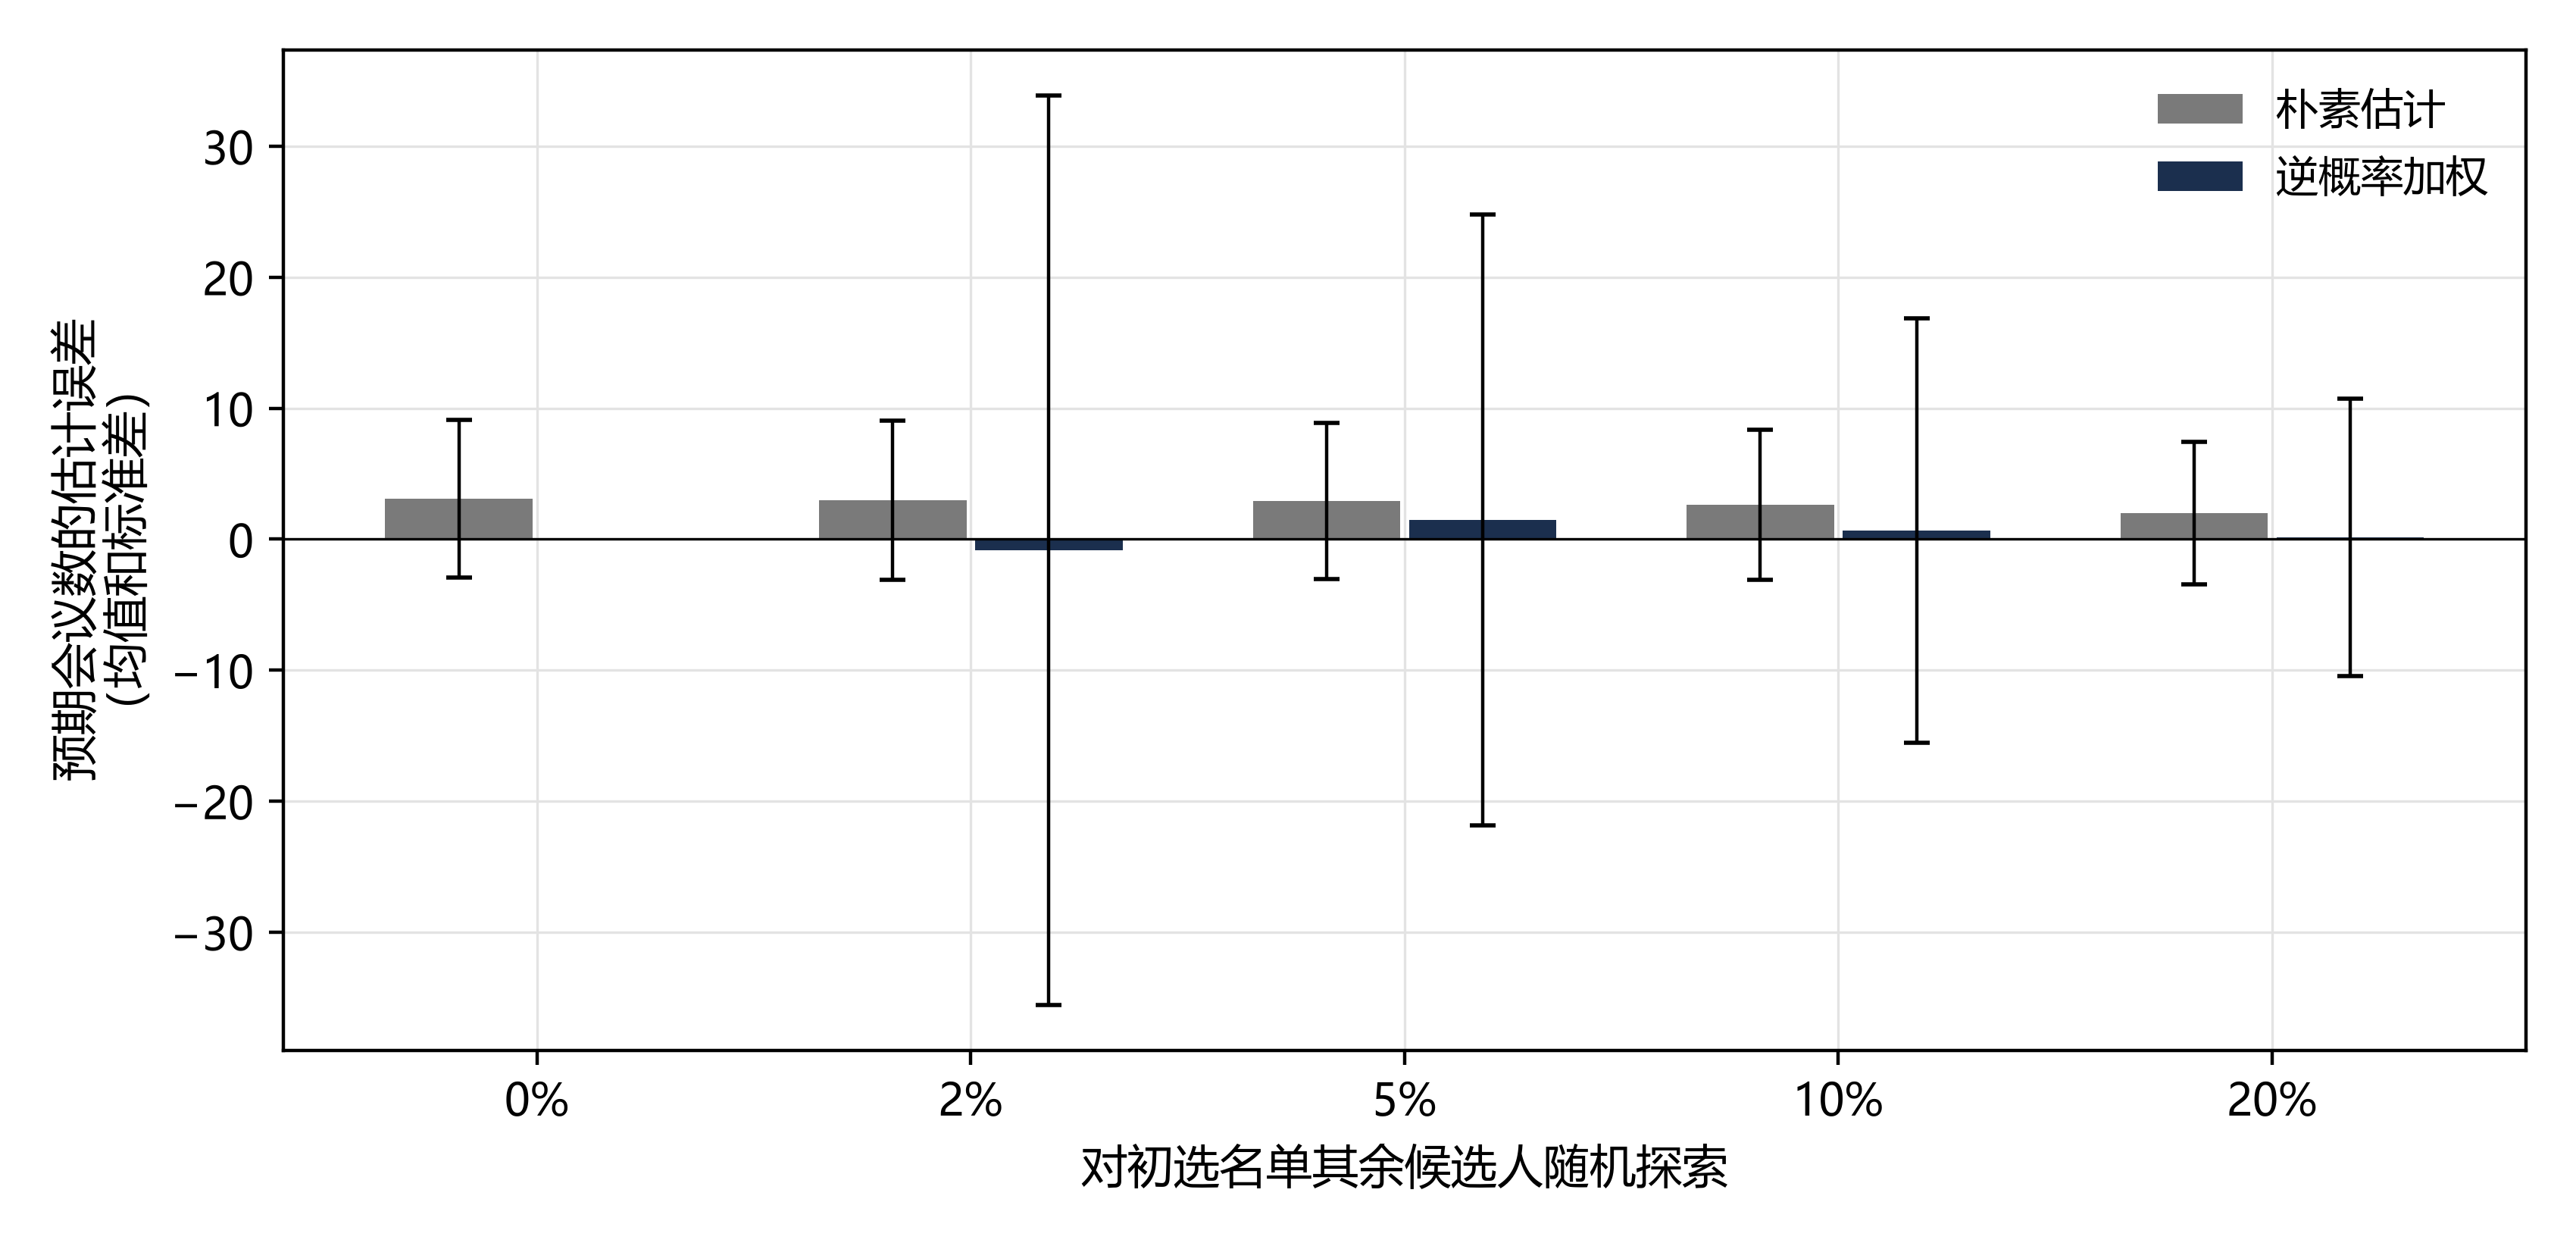
Matchpoint对模拟名单的分析。结果为给定输入下的模型输出,并非观测结果。 预期会议数估计误差的均值和标准差;每个探索比例重复400次。
横向滚动可查看全部列。
| 对初选名单中其余候选人进行随机探索 | 额外接洽次数 | 朴素估计误差(均值) | 朴素估计误差(标准差) | 逆概率加权估计误差(均值) | 逆概率加权估计误差(标准差) |
|---|---|---|---|---|---|
| 0% | 0.0 | 3.11 | 6.01 | 未定义 | 不适用 |
| 2% | 4.3 | 2.98 | 6.05 | -0.83 | 34.71 |
| 5% | 11.2 | 2.90 | 5.95 | 1.47 | 23.33 |
| 10% | 22.3 | 2.63 | 5.72 | 0.67 | 16.20 |
| 20% | 45.0 | 1.99 | 5.43 | 0.14 | 10.60 |
Matchpoint对模拟名单的分析。结果为给定输入下的模型输出,并非观测结果。 误差为估计值减去新批次在模型中的真实预期会议数。
没有随机探索时,朴素估计高估3.11场会议,相当于目标值的7%;随着探索比例提高,偏差缓慢缩小。探索比例为20%时,逆概率加权估计量的偏差在抽样误差范围内,但波动明显:其标准差为10.60场,朴素估计为5.43场;均方根误差分别为10.59场和5.78场。不进行探索就无法构造加权估计量,直接加总观测结果会产生-25.58场的误差。以单次活动为单位,修正带来的额外波动超过它消除的偏差。
本次模拟中,20%的探索比例增加45.0次接洽,超过基础批次75次的一半。模拟的抽样范围覆盖初选名单中其余候选人。实际研究必须先分别审查募集事项、接收方、发送方和接洽渠道,只对已独立确认合规的候选人与接洽路径组合进行随机分配。模拟的误差和接洽量不能直接套用于这一筛选后的抽样框。
19 检验模型内部一致性,并说明模型前提的循环性
表13列出44项检查。在核实完全准确且准入条件稳定时,全面核实选出的批次与初选名单中模型真实概率最高的批次一致,在基础情景的每次重复模拟中,其表现均不低于任何部分核实方案。个别模拟中,部分核实的预期出资承诺数可能低于仅按记录选出的批次。检查还涵盖夏普利值加总的一致性、均值校准,以及概率单位模型公式与数值积分结果是否相符。
横向滚动可查看全部列。
| 检查项 | 结果 |
|---|---|
| 模型验证的恒等关系 | 44项检查通过 |
| 基础情景中全面核实的基准 | 与初选名单内的最优批次一致,且不低于任一部分核实方案 |
| 夏普利值之和等于总增量 | 加总值与增量相等,误差不超过1e-9 |
| 仅按记录计算的分数已校准 | 预测均值与真实概率均值的相对差异在3%以内 |
| 概率单位模型期望值恒等式 | 闭式解与数值积分结果一致,误差不超过1e-9 |
| 逆概率加权估计量 | 探索比例为20%时,估计偏差在四个标准误以内 |
| 重复模拟次数 | 基础模拟200次、压力情景100次、描述性字段80次、参数网格60次、结果选择性可见实验400次 |
| 随机种子 | 20261014加重复模拟序号 |
Matchpoint分析。检查条件写入模型代码,每次运行均执行;任何条件不满足即停止。
模型前提存在循环性:生成结果与排序使用同一组信息,排序模型也预先知道权重。实验展示了这些信息按假定方式影响出资承诺时,方法如何运行。实际募集是否也受到投资授权、策略匹配度或其他字段影响,仍需检验。人员数量和公众知名度没有独立效果,是因为模型预先设定了这一点;实际报告是否可从此类字段获得额外信息,应由数据回答。
实验也省略了实际活动中的若干因素:准入条件之间的相关性、团队在多轮接洽中的学习、投资者对顾问声誉的反应、接洽时点的影响,以及可对监管风险定价的损失函数。接洽能力、时点和顺序不在本文范围内,更完整的模型可将它们合并分析。
20 实地研究需要经同意并带有时间记录的数据、随机样本和事先确定的分析计划
要用实地数据替代模型设定,研究需要先确定分析单位、观察期和结果定义。分析单位为一次募资活动中的一名候选投资者。观察期从字段核实开始,到签署出资承诺或活动结束为止。结果包括符合条件的会议、进入正式尽职调查和签署出资承诺,每一项均记录时间。表14列出设计。
横向滚动可查看全部列。
| 要素 | 要求 | 理由 |
|---|---|---|
| 分析单位与记录 | 候选投资者与募资活动的组合;逐项记录来源、查阅人和日期 | 区分信息过期与信息错误 |
| 合法处理依据与数据最小化 | 说明每项个人信息的用途与保留期限 | 数据保护原则[12, 15] |
| 随机抽样部分 | 预先审查候选人与接洽路径组合的合规性;在通过审查的抽样框内随机抽取,并记录纳入概率 | 支持对通过筛选的群体作统计推断 |
| 核实审计 | 从被剔除的候选人中随机抽样,由独立人员重新核实 | 衡量未显现的错误剔除 |
| 结果阶段 | 分别记录会议、进入尽职调查和出资承诺的时间 | 出资承诺发生率较低 |
| 合并多次活动 | 按研究设计确定样本量,考虑活动层面的聚类与合格抽样框内观测到的发生率 | 评估检出最低频结果所需的统计功效 |
| 分析计划 | 获取数据前确定用夏普利值和最后核实价值衡量各项信息,并计算区间 | 减少事后挑选结果 |
拟议研究设计。此表说明应收集哪些数据,未报告研究结果。
实地研究开始前,应记录接洽许可、适用的数据保护与营销要求、合法处理依据和研究许可。随机分配本身不能取得接洽许可。事先明确合格接洽批次,并为其中每个候选人与接洽路径的组合记录已知且大于零的纳入概率。预先确定探索预算,并考虑活动层面的聚类。对被剔除对象可进行文件审查,无需直接接洽。
研究将估算与模型相同的量,并分别给出区间:各项核实带来的增量、单位成本增量和随机抽样部分对估计的影响。研究还将直接检验模型前提,尤其是描述性字段是否具有独立信息价值,以及未通过准入条件造成的损失是否达到设定水平。
21 向客户或委员会提交已核实字段表,列出成本和审计结果
客户或投资委员会需要一份可用于决策的报告。建议列明接洽批次规模、已核实的初选名单及核实字段,并附各字段的来源和日期。记录每项准入条件剔除的人数、后来未通过的人数,以及排序发生变化的人数。参照表7,对比分析工时与预期出资承诺增量,并列出每份承诺的盈亏平衡值。
报告也应列出未核实的字段及原因。沿用供应商读数的字段仍受假定准确率约束,应向读者说明。同一页应展示对被剔除对象的审计:核实错误的情景表明,准入条件剔除过多候选人时,表面效率可能提高,却失去出资承诺机会。读者应能判断每个数字是观测值、核实值还是假定值。
措辞应准确。本文报告的增量属于模型结果,不能据此预测募资表现。预期出资承诺数应作为明确假设下的排序工具;实际发生的会议和出资承诺应按发生情况记录。模型与报告均不承诺结果,本文也不就具体募集提供建议。
22 用数据和AI更新字段,指定专人负责准入判断
可在核对投资授权与策略、提取出资金额区间和标记政策变化等重复性任务中测试自动化工具。决定在哪些环节使用前,应测量审查用时和人工复核后仍存在的错误。实验把核实成本作为输入;某项成本降低后,其核实优先级会上升。本文未测量任何自动化工具的准确率。
模型指出自动化环节需要哪些控制。信息过期和核实错误都可能不易察觉,而自动化工具可能大规模产生这两类问题。误读投资授权会剔除原可出资的候选人,接洽记录不会显示这项损失。建议将自动判读作为待审建议录入报告并附来源链接,由指定人员负责每项剔除决策,每一轮都随机抽取一部分自动剔除对象进行人工复核。
评估自动化判读工具时,应衡量模型揭示的损失。错误剔除会损失候选人的预期出资承诺;错误放行会占用一次接洽机会,如果涉及资格条件,还可能带来监管风险。评估应用未参与调校的候选人样本进行,来源文件发生变化后应重新评估;按某一年政策措辞调校的工具,下一年可能失效。
23 实务决策规则:先核实初选准入条件,按单位成本收益排序,并审计剔除决定
募资方可用自身记录检验这套操作规则。第一,依据高管可投入的时间设定接洽规模,将初选人数设为接洽人数的两至四倍。第二,先核实初选候选人的准入条件,再考虑排序字段,并记录来源与日期。第三,按单位成本增量逐步加入排序字段:若下一项的预期增量低于其核实成本除以募资方赋予每份出资承诺的价值,就停止加入。第四,对被剔除的候选人进行随机抽样审计。
三种条件会改变规则。若供应商记录准确,如高质量记录情景,核实增量会收窄,可缩小初选名单。若相对于初选名单的规模,接洽人数较少,排序因素与准入条件同等重要,可同时核实。若市场转冷,预期出资承诺数和核实增量会同时下降,准入条件与排序因素的贡献比例基本不变;此时仍可使用同一规则,但每项核实要求更高的承诺盈亏平衡值。
这套规则是供实地研究检验的假设,依据的是按设定输入生成的模拟案例。团队可用它安排自身工作,并记录可能推翻规则的结果:已核实的候选人后来未通过、被剔除的候选人后来证实有出资意愿,以及会议未能推进到下一阶段。
24 局限与下一步:借助有记录的抽样结果替代设定权重
权重、准入通过率和成本均为设定值,排序模型事先知道其结构。各准入条件相互独立,排序因素服从正态分布,结果由单一概率单位模型描述。实验未考虑投资者从以往接洽中学习,也未计入接洽带来的声誉成本。结果说明报告在上述条件下的运作逻辑,无法估计真实投资者群体的表现。尤其是各项信息的排序依赖设定权重,权重改变后顺序也可能变化。
若干资料所研究的问题比本文更窄:实地实验研究初创企业信息与天使投资者,数据库研究讨论风险投资数据,信息价值论文讨论医疗技术,CalPERS的政策例示了一家投资者公开披露的限额,这些限额不能推广至其他投资者。每项资料为某类分析提供依据,均未提供模型输入值。所引监管文本以注明的查阅日期为准,未对任何具体募集作适用性测试。
先审查剔除决定所依据的文件和逐项核实成本。开展前瞻性研究时,先独立审查合格接洽抽样框,再选择团队资源能够支持且足以精确衡量目标结果的探索比例。在更改报告模板前,使用合格研究群体的数据重新估算收益和成本。
参考文献
- Bernstein, S., Korteweg, A. and Laws, K. Is it Just the Idea that Matters? A Randomized Field Experiment on Early Stage Investments. 2014年3月工作论文草稿,已查阅全文。发表版本: Attracting Early-Stage Investors: Evidence from a Randomized Field Experiment, Journal of Finance 72(2), 2017, doi 10.1111/jofi.12470, (仅查阅摘要)。 https://www.haas.berkeley.edu/wp-content/uploads/BernsteinKorteweg_032314.pdf
- Gompers, P., Gornall, W., Kaplan, S. and Strebulaev, I. How Do Venture Capitalists Make Decisions? NBER Working Paper 22587, 2016年9月。 https://www.nber.org/system/files/working_papers/w22587/w22587.pdf
- Guyon, I. and Elisseeff, A. An Introduction to Variable and Feature Selection. Journal of Machine Learning Research 3, 2003, pp. 1157-1182. https://www.jmlr.org/papers/volume3/guyon03a/guyon03a.pdf
- Heath, A. and Baio, G. Calculating the Expected Value of Sample Information using Efficient Nested Monte Carlo: A Tutorial. arXiv:1709.02319. 研究背景为卫生经济学。 https://arxiv.org/pdf/1709.02319
- Bindels, J. et al. Use of Value of Information in Healthcare Decision Making: Exploring Multiple Perspectives. PharmacoEconomics, 2015. 结论涉及荷兰。 https://repub.eur.nl/pub/79197/2015-12-07-033.pdf
- Kaplan, S. and Lerner, J. Venture Capital Data: Opportunities and Challenges. NBER Working Paper 22500, 2016年8月。 https://www.nber.org/system/files/working_papers/w22500/w22500.pdf
- Lerner, J., Schoar, A. and Wong, W. Smart Institutions, Foolish Choices? The Limited Partner Performance Puzzle. NBER Working Paper 11136, 2005年2月。仅查阅摘要与引言。 https://www.nber.org/system/files/working_papers/w11136/w11136.pdf
- United States Securities and Exchange Commission. 17 CFR 230.506, Exemption for limited offers and sales without regard to dollar amount of offering, paragraph (c). 2026年10月14日查阅eCFR当时的现行文本。 https://www.ecfr.gov/current/title-17/chapter-II/part-230/section-230.506
- United States Securities and Exchange Commission. 17 CFR 230.501, Definitions and terms used in Regulation D, paragraph (a). 2026年10月14日查阅eCFR当时的现行文本。 https://www.ecfr.gov/current/title-17/chapter-II/part-230/section-230.501
- Dubai Financial Services Authority. DFSA Rulebook, Conduct of Business Module (COB), version 51 (COB/VER51/07-26), rules 2.3.2 to 2.3.4 and guidance. 2026年10月14日查阅时为现行合订版本。 https://dfsaen.thomsonreuters.com/sites/default/files/net_file_store/DFSA1547_12383_VER510726.pdf
- California Public Employees’ Retirement System. Public Employees’ Retirement Fund Investment Policy, 自2026年7月1日起生效, Appendix 4, Private Equity: Partner Relationship Exposure. https://www.calpers.ca.gov/documents/202606-invest-agenda-item05a-10-a/download
- United Kingdom. Regulation (EU) 2016/679 as it forms part of United Kingdom law, Article 5(1)(c) and (d). legislation.gov.uk. https://www.legislation.gov.uk/eur/2016/679/article/5
- Institutional Limited Partners Association. ILPA Due Diligence Questionnaire 2.0, 2021年11月更新。行业自愿采用的工具。 https://ilpa.org/wp-content/uploads/2021/11/ILPA-DDQ-2.0.pdf
- California Public Employees’ Retirement System. Investment Committee Meeting Summary, 2026年6月15日, approval of Agenda Item 5a, Total Fund Policy Review. https://www.calpers.ca.gov/documents/202606-full-agenda-item7a-invest-committee-summary/download?inline=
- Dubai International Financial Centre. Data Protection Law, DIFC Law No. 5 of 2020, 2025年7月合订版本, Article 9(1). https://edge.sitecorecloud.io/dubaiintern0078-difcexperie96c5-production-3253/media/project/difcexperiences/difc/difcwebsite/documents/laws--regulations/data-protection-law.pdf
关于作者
Chennakeshav(CK)是一位企业融资与投资银行高管,在并购、成长资本与企业战略领域拥有25年以上全球交易发掘、结构设计及执行经验。他曾为创始人、企业与基金领导价值创造项目,将董事会层面的视角衔接至实际执行与交割。
他的职业经历涵盖Morgan Stanley、HSBC、Lloyds Banking Group、EWEC、ADQ旗下投资组合公司与Emirates Growth Fund,涉及TMT、房地产、金融科技、深科技、清洁科技、基础设施与能源。他曾与企业高管、私募股权及创投基金、主权财富基金和家族办公室合作,为复杂融资与扩张期企业筹资,并领导并购尽调、并购后整合与业务转型项目以创造价值。
他在Matchpoint Partners担任管理合伙人,领导公司的企业融资、并购与募资业务。他拥有London Business School的MBA学位、VTU的工程学位,并正在UCL London攻读法学硕士(LLM)。
CK积极担任初创企业导师,参与Techstars、DIFC FinTech Hive、Startup Grind、Founder Institute与IN5的导师工作,在London Business School担任Entrepreneur Mentor in Residence(EMiR),并担任Entrepreneurship World Cup评委。
https://www.linkedin.com/in/ckadya/
https://www.matchpoint-partners.com/team/ck-adya.html
免责声明
本文属于持续研究私人及另类市场结构的系列。文中观点为作者个人观点。本文仅供参考,以一般性方式讨论市场结构,不构成投资、法律、税务或监管建议,也不构成针对任何证券、载体或交易对手的推荐。
