
1 De beleggersbenadering ordenen op mandaatfit
Een kapitaalwerving verbruikt een middel dat niet kan worden teruggekocht: de aandacht van de mensen die het bedrijf of fonds kunnen toelichten. Een oprichter, financieel directeur of sponsor die privaat kapitaal werft, en een fondsbeheerder die bij fondsbeleggers werft, moeten bepalen welke beleggers eerst worden benaderd, welke voor een latere ronde worden aangehouden en welke helemaal niet worden benaderd. Dit onderzoek behandelt die volgordebeslissing. Het vraagt of een scorekaart voor mandaatfit op basis van strategie, geografie, investeringsomvang en beslissingscyclus een gekwalificeerd eerste gesprek voldoende goed voorspelt om de benaderingsvolgorde te sturen.
De vraag is smaller dan zij op het eerste gezicht lijkt. Een scorekaart kan beleggers juist rangschikken en een planningsprognose toch misleiden. Zij kan in de ene markt goed voorspellen en in een andere overschatten. Ook kan zij uitstekend lijken op basis van een historie van benaderingen die zelf op oordeel zijn geselecteerd. Wij onderscheiden daarom drie eigenschappen: of de score beleggers rangschikt, of de bijbehorende kansen juist zijn en of het onderliggende bewijs standhoudt bij een andere methode om te bepalen wie wordt benaderd. Elke eigenschap ondersteunt een ander deel van de beslissing en kan op een andere manier falen.
Het beschikbare bewijs ondersteunt dit onderscheid. Institutionele beleggers en hun standaardstellers publiceren mandaatcriteria, zodat de fit uit documenten kan worden afgelezen. [1, 2, 3] Onderzoek naar beleggersgedrag beschrijft gefaseerde selectietrechters, netwerkgedreven sourcing en een voorkeur voor de thuismarkt. [4, 5, 6] Toezichthouders bepalen wie rechtmatig een aanbod mag ontvangen. [7, 8, 9, 10, 11] De statistische literatuur beschrijft hoe een score moet worden beoordeeld. [12, 13, 16] Geen van deze bronnen toetst een praktisch gebruikte scorekaart aan benaderingsuitkomsten; ook onze literatuurstudie vond geen dergelijke gepubliceerde toets. Die uitspraak betreft onze literatuurstudie en niet de gehele literatuur.
Onze voornaamste bijdrage is een reproduceerbaar experiment dat laat zien wat een validatie zou moeten meten en hoe groot zij zou moeten zijn. Wij beschikken niet over een waargenomen cohort van benaderingen met toestemming en tijdstempels en vermelden dat uitdrukkelijk. De populatie, uitkomsten en percentages van het experiment zijn geconstrueerd. Het experiment stelt vast hoe een bepaalde scorekaart zich onder bepaalde aannames gedraagt. Het schat geen responspercentage van een belegger, conversie van een kapitaalwerving of toegevoegde waarde van een adviseur.
2 Het gekwalificeerde eerste gesprek definiëren vóór de score
Een score voorspelt een uitkomst; die uitkomst moet daarom eerst vaststaan. Wij stellen voor een gekwalificeerd eerste gesprek alleen vast te leggen als aan vier voorwaarden is voldaan: het gesprek heeft plaatsgevonden, de belegger werd vertegenwoordigd door iemand met de bevoegdheid om een kans verder te brengen, de belegger ontving vooraf de mandaatsamenvatting en de belegger bevestigde dat de kans binnen een mandaat viel waarbinnen hij kon handelen. Een telefoongesprek uit beleefdheid, een als gunst aangenomen gesprek en een gesprek met een analist die marktinformatie verzamelt worden geregistreerd, maar niet als gekwalificeerd geteld.
De definitie is belangrijk omdat een ruim gedefinieerde uitkomst een zwakke score gunstiger doet lijken. Als ieder gesprek meetelt, lijkt een rangschikking op relatiewarmte te werken doordat bekenden gesprekken aannemen. De latere fasen vereisen dezelfde discipline. Voortgang naar due diligence wordt geregistreerd wanneer de belegger toegang tot de dataroom vraagt of een due-diligencelijst verstrekt. Een toezegging wordt pas geregistreerd wanneer een ondertekend document een bindende investeringsverplichting schept. Niet-bindende term sheets en blijken van belangstelling worden afzonderlijk vastgelegd. Elke gebeurtenis krijgt een datum.
Tabel 1 beschrijft de voorgestelde registratie voor iedere belegger op de longlist. Deze scheidt wat de belegger heeft gepubliceerd van wat het team inschat en bevat voor iedere invoervariabele een beoordelingsdatum. Dat onderscheid is bewust. Paragraaf 15 laat zien dat niet-vastgelegd oordeel de belangrijkste route is waarlangs een historisch cohort misleidt. De registratie is een voorstel voor een transactiedossier; zij is geen bevinding over een bepaalde belegger.
| Rubriek | Vereiste informatie | Ondersteunde beslissing |
|---|---|---|
| Verklaarde strategie | Beleggingscategorie, fase, instrument en uitsluitingen, met het brondocument en de datum daarvan | Of de kans binnen het mandaat valt, eraan grenst of erbuiten valt |
| Verklaarde geografie | Toegestane, prioritaire en uitgesloten regio's en eventuele concentratielimieten | Of de belegger de blootstelling mag aanhouden |
| Capaciteit voor de investeringsomvang | Minimale en maximale toezegging, limieten voor het aandeel in het vehikel en belangstelling voor co-investeringen | Of het voorgestelde bedrag kan worden geïnvesteerd |
| Stand van de beslissingscyclus | Investeringsperiode, investeringstempo, commissiekalender en laatst bekende allocatiestatus | Of de belegger nu kan handelen |
| Juridisch kader | Beleggerscategorie in iedere relevante jurisdictie en de toegestane benaderingsroute | Of en hoe de belegger mag worden benaderd |
| Relatie | Bestaand contact, introducerende partij en toestemming om te worden benaderd | Het kanaal en de persoon die de benadering uitvoert |
| Benaderingsgebeurtenis | Datum, afzender, verzonden materiaal en de regel waarmee de belegger werd geselecteerd | Of de uitkomst als bewijs kan worden gebruikt |
| Uitkomst | Gedateerde gebeurtenissen voor gesprek, due diligence en toezegging volgens de bovenstaande definities | Waaraan de score wordt getoetst |
Voorgestelde transactieregistratie. De vermeldingen beschrijven te verkrijgen informatie; zij zijn geen bevindingen over een bepaalde belegger. [1, 2, 3]
3 Het mandaat aflezen uit de eigen gepubliceerde stukken van de belegger
Mandaatfit is waarneembaar omdat instellingen hun mandaten vastleggen. De Santiago Principles, gepubliceerd in oktober 2008 door de International Working Group of Sovereign Wealth Funds, stellen dat het beleggingsbeleid van een fonds duidelijk moet zijn en moet aansluiten bij de vastgestelde doelstellingen, risicotolerantie en beleggingsstrategie. Zij voegen toe dat het beleid het gebruik van externe beheerders en hun selectieproces moet behandelen en dat een beschrijving van het beleid openbaar moet worden gemaakt. [2] De beginselen zijn vrijwillig. Zij scheppen een verwachting van openbaarmaking; zij tonen niet aan dat de huidige beleggingsinteresse van een bepaald fonds overeenkomt met het gepubliceerde beleid.
Het beleid van publieke pensioenfondsen laat zien welke vorm zulke criteria aannemen. Een beleidsdocument voor het private-equityprogramma dat in november 2019 aan het Investment Committee van CalPERS werd voorgelegd, bevat strategiedoelen en bandbreedtes: buy-outs op 65% binnen 55% tot 75%, groeikapitaal op 15% binnen 5% tot 20%, kredietgerelateerde en opportunistische strategieën elk op 10% binnen 0% tot 15% en venture capital op 1% binnen 0% tot 7%. Het beperkt een toezegging tot 25% van een individueel fonds, begrenst de blootstelling aan één general partner als aandeel van het programma en verlangt dat medewerkers maandelijks rapporteren over ontvangen voorstellen, hun fase in de pijplijn en hun afhandeling. [3] Het document is een gedateerd commissiestuk met voorgestelde herzieningen. Het ondersteunt de aanwezigheid en vorm van gepubliceerde limieten; het is geen bewijs van huidige limieten.
De due-diligencestandaard van fondsbeleggers verwijst naar dezelfde invoervariabelen. De vragenlijst van de Institutional Limited Partners Association, bijgewerkt in november 2021, behandelt twintig onderwerpen. Het onderdeel beleggingsstrategie vraagt een beheerder naar verwachte transactieomvang, inclusief minimum en maximum, investeringstempo, aanhoudingsduur, geografische focus, sectorfocus en fase en eventuele concentratielimieten naar geografie of sector. [1] ILPA stelt dat de vragenlijst geen verplicht document is. Zij laat zien naar welke kenmerken beleggers eerst vragen. Zij rangschikt die kenmerken niet en meet niet hoe vaak een mismatch een gesprek beëindigt.
Deze bronnen onderbouwen de invoervariabelen van de scorekaart als categorieën. Geen ervan levert een gewicht. De punten die in paragraaf 7 aan iedere invoervariabele worden toegekend, zijn een ontwerpkeuze; het experiment onderzoekt wat er gebeurt wanneer die keuze onjuist is.
4 Geografie behandelen als mandaatkenmerk en juridisch kader
Geografie speelt op twee manieren een rol in de beslissing. Zij is een voorkeur, omdat beleggers zich concentreren op plaatsen waar zij kennis en relaties hebben, en een juridische afbakening, omdat aanbiedingen alleen aan bepaalde personen en op bepaalde manieren mogen worden gedaan. Hochberg en Rauh constateren dat alle typen institutionele beleggers een overwogen positie aanhouden in private-equityfondsen in hun eigen Amerikaanse staat. Voor publieke pensioenfondsen bedraagt die oververtegenwoordiging gemiddeld 9.7% van hun private-equityportefeuille; beleggingen binnen de eigen staat presteren slechter dan die erbuiten. [5] Het onderzoek betreft Amerikaanse fondsbeleggers en één beleggingscategorie. Het ondersteunt het gebruik van nabijheid als voorspeller van belangstelling. Het toont niet aan dat nabijheid een gunstige uitkomst voor een van beide partijen voorspelt.
De onderstaande regelgevingsvoorbeelden beschrijven de aangehaalde versies van de regels. Vóór iedere benadering moet juridisch advies het geldende recht, de vergunningen van de onderneming en de classificatie van de ontvanger bevestigen. De aangehaalde Amerikaanse marketingregel voor beleggingsadviseurs definieert welke advertenties eronder vallen en beperkt onware verklaringen, niet-onderbouwde materiële claims en voordelen die zonder een eerlijke en evenwichtige behandeling van de risico's worden gepresenteerd. De toepassing op een concrete mededeling hangt af van inhoud, ontvangers en toepasselijke uitzonderingen. [7] Rule 506(c) staat een uitgevende instelling algemene werving toe, mits iedere koper een accredited investor is, de uitgevende instelling redelijke stappen neemt om die status te verifiëren en aan de overige voorwaarden van Regulation D is voldaan. [8] In het Verenigd Koninkrijk mag een onderneming geen promotie van een niet voor de massamarkt bestemde belegging verspreiden die waarschijnlijk een particuliere klant bereikt, behoudens uitzonderingen die afhangen van de gecertificeerde categorie van de ontvanger. [9] Deelnemingsrechten in niet-gereguleerde collectieve beleggingsregelingen vallen buiten die regel en worden in plaats daarvan beheerst door section 238 van de Financial Services and Markets Act 2000. [9]
De regels in de Golfregio zijn even specifiek. Toelichting in het regelboek van de Dubai Financial Services Authority vermeldt dat een buitenlands fonds alleen vanuit het Dubai International Financial Centre mag worden aangeboden wanneer aan een van drie voorwaarden is voldaan. Een daarvan is een onderhandse plaatsing bij personen die kwalificeren als Professional Clients met een eerste inschrijving van minstens USD 50 000. [10] De Saudische Investment Funds Regulations verlangen dat een buitenlands fonds via een vergunninghoudende distributeur als onderhandse plaatsing wordt aangeboden. Die plaatsing wordt afgebakend door institutionele en gekwalificeerde klanten en een limiet aan het bedrag dat iedere particuliere geadresseerde mag betalen, na kennisgeving aan de toezichthouder minstens vijftien dagen vóór het aanbod. [11] Wij hebben de regels van de toezichthouder van de Abu Dhabi Global Market niet onderzocht en doen daarover geen uitspraak.
Tabel 2 vertaalt deze regels naar registraties voor de scorekaart. Het juridische kader is een toegangstoets en krijgt nooit een score. Een belegger buiten de toegestane categorie wordt vóór iedere rangschikking van de lijst verwijderd of via een toegestaan kanaal geleid. Een hoge fitscore mag nooit worden gebruikt om een benadering te rechtvaardigen die het juridische kader uitsluit. De tabel is een onderzoekssamenvatting en geen juridisch advies.
| Jurisdictie en bron | Wat de bron vaststelt | Registratie voor de longlist |
|---|---|---|
| Verenigde Staten: marketingregel voor adviseurs, 17 CFR 275.206(4)-1 | Bepaalde mededelingen van adviseurs aan potentiële beleggers in private fondsen vallen onder de definitie van advertentie; betrokken claims moeten onderbouwd en evenwichtig zijn. De regel bevat voorwaarden voor bruto- en nettorendementen en uitsluitingen van het toepassingsgebied | Aan iedere belegger verzonden goedgekeurde materiaalversie; onderbouwingsdossier |
| Verenigde Staten: Rule 506(c) | Algemene werving is toegestaan wanneer alle kopers accredited investors zijn en redelijke verificatiestappen worden genomen | Gekozen aanbiedingsroute; verificatiebewijs voor iedere koper |
| Verenigd Koninkrijk: FCA COBS 4.12B | Promoties van niet voor de massamarkt bestemde beleggingen mogen particuliere klanten alleen bereiken als een uitzondering geldt; redelijke stappen om de ontvangerscategorie vast te stellen; rechten in niet-gereguleerde collectieve regelingen vallen onder section 238 | Klantcategorie en, waar relevant, certificaatdatum |
| DIFC: DFSA Collective Investment Rules, hoofdstuk 15 | Aanbiedingen van buitenlandse fondsen vereisen een designated fund, een geschiktheidsaanbeveling of een onderhandse plaatsing bij Professional Clients met minstens USD 50 000 eerste inschrijving | Gebruikte route; classificatie als Professional Client |
| Saudi-Arabië: CMA Investment Funds Regulations, deel 6 | Buitenlandse fondsen worden via een vergunninghoudende distributeur onderhands geplaatst, afgebakend door institutionele en gekwalificeerde klanten met een limiet per particuliere geadresseerde en vijftien dagen voorafgaande kennisgeving | Aangestelde distributeur; kennisgevingsdatum; beleggerscategorie |
Samenvatting van de aangehaalde bronnen voor onderzoeksdoeleinden; geen juridisch advies. Iedere rij beschrijft wat de bron vaststelt en geen volledig overzicht van het regime. [7, 8, 9, 10, 11]
5 De stand van de beslissingscyclus scheiden van structurele mandaatfit
Strategie, geografie en investeringsomvang veranderen langzaam. Zij beschrijven wat een belegger mag en geneigd is te doen. De stand van de beslissingscyclus verandert snel. Die beschrijft of de belegger kan handelen in de periode die ertoe doet: of zijn vehikel nog investeert, of de jaarlijkse allocatie openstaat en wanneer zijn commissie weer bijeenkomt. Wij behandelen de eerste drie als structurele fit en de vierde als timing. Een belegger met perfecte structurele fit en een gesloten allocatie is een goede naam voor de volgende kapitaalwerving en een slechte besteding van tijd in de huidige ronde.
Onderzoek naar venturebeleggers geeft, met beperkingen, een indruk van de benodigde tijd. In een enquête onder 885 institutionele venturecapitalbeleggers bij 681 ondernemingen rapporteren Gompers, Gornall, Kaplan en Strebulaev dat een gemiddelde transactie 83 dagen tot afronding duurt en 118 uur due diligence en tien referentiegesprekken vergt. [4] Dit zijn zelfgerapporteerde cijfers van venturecapitalondernemingen die bedrijven beoordelen. Zij beschrijven geen fondsbeleggers die fondsen beoordelen, kredietbeleggers of instellingen in de Golfregio. Zij laten zien dat de periode tussen eerste contact en toezegging lang genoeg is om de cyclusstatus van een belegger tijdens een lopend proces te laten veranderen.
Timing heeft ook de zwakste gegevens. Een gepubliceerd beleid is gedateerd en stabiel; een investeringsstatus wordt afgeleid uit aankondigingen, gesprekken en de kalender. Wij verwachten daarom dat de registratie van de beslissingscyclus vaker verouderd is dan iedere andere invoervariabele en kennen haar in het experiment de hoogste verouderingskans toe. Dat is een aanname, vermeld in tabel 4, die paragraaf 16 varieert. De invoervariabele met het grootste voorspellende gewicht kan ook de minst betrouwbare zijn.
6 Wat onderzoek naar beleggersselectie vaststelt en wat het niet vaststelt
Drie bevindingen uit de literatuur bepalen de vorm van het experiment. De eerste is dat beleggingsprocessen gefaseerd en sterk selectief zijn. Gompers en medeauteurs rapporteren dat een venturecapitalonderneming ongeveer 100 kansen beoordeelt voor iedere transactie die zij afrondt. Ongeveer een op vier leidt tot een gesprek met het management, een derde daarvan tot een partnerbespreking, ongeveer de helft daarvan tot due diligence en ongeveer een derde van de due-diligencegevallen ontvangt een term sheet. [4] Die trechter behoort tot het eigen proces van de belegger. Zij ondersteunt het modelleren van de uitkomst als een reeks voorwaardelijke fasen, zoals in paragraaf 13 gebeurt.
De tweede bevinding is dat toegang op relaties berust. Dezelfde enquête rapporteert dat meer dan 30% van de transacties uit professionele netwerken komt, ongeveer 20% door andere beleggers wordt aangebracht en slechts ongeveer 10% als inkomende benadering door het bedrijfsmanagement ontstaat. Ook noemt ongeveer de helft van de respondenten fit met het fonds als een belangrijke selectiefactor en 14% als de belangrijkste, ruim achter het managementteam. [4] Mandaatfit is dus één invoervariabele naast andere; een bestaande relatie is een afzonderlijke voorspeller. In het geconstrueerde genererende model bevat de relatie aanvullende uitkomstinformatie. De extra voorspellende waarde buiten de schattingssteekproef moet in een echte campagne worden onderzocht en mag niet worden aangenomen.
De derde bevinding is methodologisch. Bernstein, Korteweg en Laws voerden een gerandomiseerd veldexperiment uit op een onlineplatform. Zij verstuurden bijna 17 000 e-mails aan ongeveer 4 500 actieve vroegefasebeleggers en varieerden welke informatie iedere e-mail bevatte. De gemiddelde belegger reageerde sterk op informatie over het oprichtersteam en niet op tractie of bestaande leidende beleggers. [6] Het onderzoek betreft vroegefase-eigenkapitaal op één platform. De betekenis hier ligt in de opzet: doordat de informatieverstrekking was gerandomiseerd, kan de respons aan de informatie worden toegeschreven. Een scorekaartstudie heeft dezelfde eigenschap nodig.
Geen van deze onderzoeken meet of een mandaatfitscore een eerste gesprek voorspelt bij een onderhandse plaatsing bij instellingen; geen ervan betreft de Golfregio. Wij gebruiken ze om de structuur van het experiment te kiezen en niet om een percentage vast te stellen.
7 De scorekaart zo specificeren dat zij kan worden weerlegd
Een scorekaart verdient haar plaats door eenvoudig genoeg te zijn om te controleren. Wij stellen vier invoervariabelen voor, elk op drie niveaus beoordeeld, met punten die optellen tot 100. Strategie en beslissingscyclus krijgen elk 30 punten; geografie en investeringsomvang elk 20. Een variabele scoort nul als de registratie laat zien dat de kans buiten het mandaat valt of de cyclus gesloten is, de helft van de punten bij aangrenzende of onzekere fit en de volle punten bij gedocumenteerde fit. Tabel 3 bevat de matrix. Het juridische kader van paragraaf 4 wordt vóór het scoren toegepast en krijgt geen punten.
In vergelijking (1a) is S de score van belegger i, w het puntengewicht van invoervariabele k en neemt het vastgelegde niveau van die variabele, aangeduid met een tilde, de waarde 0, 0.5 of 1 aan. Vergelijking (1b) is het genererende model van het experiment: M is gelijk aan één wanneer een gekwalificeerd eerste gesprek plaatsvindt; x is het werkelijke niveau van iedere invoervariabele; r is gelijk aan één wanneer een relatie bestaat; u is niet-vastgelegde beleggingsinteresse; de Griekse letters zijn de genoemde coëfficiënten. De score gebruikt vastgelegde invoer en vaste punten. De uitkomst hangt af van werkelijke invoer en twee zaken die de score niet ziet.
| Invoervariabele | Punten | Geen punten | Halve punten | Volle punten | Te bewaren bewijs |
|---|---|---|---|---|---|
| Strategie | 30 | Beleggingscategorie, fase of instrument uitgesloten | Toegestaan, maar buiten de verklaarde focus | Binnen de verklaarde focus | Beleid, mandaat- of fondsdocumenten, gedateerd |
| Geografie | 20 | Regio uitgesloten | Regio toegestaan, geen focus | Focusregio of thuismarkt | Beleidslimieten; eerdere beleggingen |
| Investeringsomvang | 20 | Bedrag buiten de opgegeven bandbreedte | Aan de rand van de bandbreedte of een limiet voor het aandeel in een vehikel | Binnen de bandbreedte | Bandbreedte van toezeggingen; limiet voor het aandeel in een fonds |
| Beslissingscyclus | 30 | Middelen van het vehikel volledig vastgelegd of allocatie gesloten | Midden in de cyclus of status onzeker | Actief investerend met een open allocatie | Gedateerde statusnotitie en bron |
| Juridisch kader | Toegangstoets | Geen benadering of via een toegestaan kanaal | Niet van toepassing | Toelaatbaarheid gedocumenteerd | Categorie en route volgens tabel 2 |
Voorgestelde scorekaart. Punten zijn een ontwerpkeuze en geen schatting uit gegevens. Het juridische kader is een toegangstoets die vóór het scoren wordt toegepast. [1, 2, 3]
Drie keuzes maken de scorekaart toetsbaar. De invoervariabelen zijn categorisch, zodat twee analisten die dezelfde documenten lezen tot dezelfde score zouden moeten komen. De gewichten staan vast voordat de uitkomsten bekend zijn. De relatie blijft buiten de score, zodat de waarde van fit kan worden gescheiden van de waarde van toegang.
8 De score beoordelen op onderscheidend vermogen, kalibratie en lift
Een score heeft twee taken die verschillend worden gemeten. Onderscheidend vermogen is het vermogen om te rangschikken: beleggers die een gesprek aannemen moeten hoger scoren dan degenen die dat niet doen. De standaardmaat is de oppervlakte onder de receiver-operating-characteristiccurve. Fawcett laat zien dat deze oppervlakte gelijk is aan de kans dat een willekeurig gekozen positief geval hoger wordt gerangschikt dan een willekeurig gekozen negatief geval, dat willekeurige ordening 0.5 oplevert en dat de Gini-coëfficiënt tweemaal de oppervlakte min één is. [12] AUC is ongevoelig voor veranderende klassenverhoudingen zolang de scoreverdelingen binnen iedere uitkomstklasse behouden blijven. Vergelijkingen tussen kapitaalwervingen vereisen nog steeds aandacht voor de samenstelling van gevallen en het uitkomstmechanisme.
In vergelijking (2a) duidt a een belegger aan die een gekwalificeerd gesprek aannam en b een belegger die dat niet deed; gelijke scores tellen voor de helft mee, wat belangrijk is bij een scorekaart met weinig verschillende waarden. In vergelijking (2b) is de lift van deciel d het gesprekspercentage ervan, gesprekken m gedeeld door beleggers n in dat deciel, gedeeld door het percentage voor de hele lijst. Lift beantwoordt de praktische vraag hoeveel beter de eerste tranche is dan het gemiddelde. Fawcett merkt op dat lift, anders dan de ROC-curve, met het basispercentage verandert. De lift van de ene kapitaalwerving mag daarom niet zonder het bijbehorende basispercentage naar een andere worden overgebracht. [12]
Kalibratie is de tweede taak: een voorspelde 20% moet ongeveer één op vijf keer uitkomen. Van Calster en medeauteurs beschrijven kalibratie als het zwakke punt van voorspellende modellen en onderscheiden verschillende niveaus. Gemiddelde kalibratie vergelijkt de gemiddelde voorspelling met het waargenomen percentage. Zwakke kalibratie wordt samengevat door een intercept met streefwaarde nul en een helling met streefwaarde één; een helling onder één betekent dat voorspellingen te extreem zijn. Zij noemen overfitting, verschillen tussen toepassingscontexten, veranderingen in de tijd en meetfouten als oorzaken en merken op dat een slecht gekalibreerd model minder bruikbaar kan zijn dan een concurrerend model met een lagere AUC. [13]
In vergelijking (3a) wordt de aangepaste kans voor belegger i, aangeduid met een dakje, met regressie tegenover de uitkomst gezet op de log-oddsschaal; alfa is het kalibratie-intercept, geschat met de helling op één vastgezet, en lambda is de kalibratiehelling. Vergelijking (3b) is de Brier-score B, het gemiddelde gekwadrateerde verschil tussen voorspelling en uitkomst over n beleggers. Lager is beter; vergelijking is alleen mogelijk tussen scores die op dezelfde uitkomsten zijn getoetst. In april 2026 uitgegeven toezichtsrichtlijnen over modelrisico bij banken beschrijven de vergelijking van modeluitvoer met werkelijke uitkomsten als uitkomstenanalyse en merken op dat deze helpt de kwaliteit van deskundig oordeel te beoordelen wanneer een ontwerp daarop steunt. [16] Die richtlijnen richten zich op bankinstellingen en zijn geen regel voor adviseurs; wij gebruiken hun terminologie zonder hun bevoegdheid over te nemen.
9 Een geconstrueerde populatie met expliciete genererende aannames
Het experiment is volledig geconstrueerd. Wij genereren 12 000 beleggers met een vast toevalsstartgetal van 1376. Iedere belegger krijgt een werkelijk niveau voor strategie, geografie, investeringsomvang en beslissingscyclus, onafhankelijk getrokken met de aandelen uit tabel 4. Een op vijf beleggers heeft een bestaande relatie met het team. Iedere belegger heeft niet-vastgelegde beleggingsinteresse, getrokken uit een standaardnormale verdeling, die staat voor alles wat een belegger beweegt en nooit een database bereikt. Ieder krijgt ook een bekendheidswaarde die geen effect heeft op enige uitkomst.
De uitkomsten volgen vergelijking (1b). De log-odds van een gekwalificeerd eerste gesprek stijgen met 2.2 bij volledige strategiefit, 2.0 bij een open beslissingscyclus, 1.2 bij passende investeringsomvang en 1.0 bij geografische fit, met 0.9 voor een relatie en 0.7 voor iedere eenheid beleggingsinteresse. Due diligence en toezegging worden gegenereerd door verdere genoemde vergelijkingen, voorwaardelijk op de voorafgaande fase. Onder deze invoer zou 12.5% van de populatie een gekwalificeerd gesprek aannemen wanneer zij worden benaderd. Dat percentage is een gevolg van de invoer en geen marktschatting. Het team ziet de werkelijke niveaus niet. Het ziet registraties, en iedere registratie is met een genoemde kans verouderd: 5% voor strategie en geografie, 15% voor investeringsomvang en 20% voor beslissingscyclus.
De populatie wordt willekeurig verdeeld in een ontwikkelhelft en een validatiehelft van elk 6 000 beleggers. De punten van de scorekaart staan vooraf vast en gebruiken geen van beide helften. De ontwikkelhelft wordt alleen gebruikt om de omzettingsfunctie van score naar kans te schatten. Alle gerapporteerde waarden voor onderscheidend vermogen, lift en kalibratie komen uit de validatiehelft, waarin iedere belegger wordt benaderd. Die laatste voorwaarde is de belangrijke. Zij is het geconstrueerde equivalent van een volledig gerandomiseerde campagne en iets waarover een echt team bijna nooit beschikt. Paragraaf 15 laat die voorwaarde vervallen.
| Invoervariabele | Aanname | Status |
|---|---|---|
| Populatie | 12 000 beleggers; toevalsstartgetal 1376; helften van 6 000 | Geconstrueerd |
| Strategiefit (buiten / aangrenzend / kern) | 40% / 35% / 25% | Aangenomen |
| Geografische fit (buiten / toegestaan / focus) | 30% / 35% / 35% | Aangenomen |
| Fit van de investeringsomvang (buiten / rand / binnen bandbreedte) | 30% / 40% / 30% | Aangenomen |
| Beslissingscyclus (gesloten / midden / open) | 30% / 40% / 30% | Aangenomen |
| Bestaande relatie | 20% van de beleggers | Aangenomen |
| Log-odds van een gesprek | -5.95 + 2.2 strategie + 1.0 geografie + 1.2 investeringsomvang + 2.0 cyclus + 0.9 relatie + 0.7 beleggingsinteresse | Genererend model |
| Log-odds van due diligence, gegeven een gesprek | -2.3 + 1.2 strategie + 0.8 investeringsomvang + 0.6 cyclus + 0.5 beleggingsinteresse | Genererend model |
| Log-odds van een toezegging, gegeven due diligence | -2.3 + 1.0 investeringsomvang + 1.0 cyclus + 0.4 geografie + 0.5 beleggingsinteresse | Genererend model |
| Niet-vastgelegde beleggingsinteresse; bekendheid | Beide standaardnormaal verdeeld; bekendheid heeft geen effect op uitkomsten | Aangenomen |
| Scorekaartpunten | 30 strategie / 20 geografie / 20 investeringsomvang / 30 cyclus | Ontwerpkeuze |
| Verouderde registraties, basisgeval | 5% strategie / 5% geografie / 15% investeringsomvang / 20% cyclus | Aangenomen |
| Verouderde registraties, stressgeval | 15% / 10% / 30% / 50% | Stressinvoer |
| Scorekaart met onjuiste gewichten | 15 strategie / 45 geografie / 40 investeringsomvang / 0 cyclus | Stressinvoer |
| Zwakkere markt | Log-odds van ieder gesprek 0.7 lager; nieuwe uitkomsttrekking | Stressinvoer |
| Eerste ronde | 100 benaderingen per 1 000 namen | Ontwerpkeuze |
| Herhaalde cohortsteekproeven | 2 000 willekeurige cohorten van iedere omvang, zonder teruglegging | Methode |
Volledig geconstrueerd. Niveaus krijgen de score 0, 0.5 en 1. Geen invoervariabele is een waargenomen marktpercentage.
10 Onderscheidend vermogen: de score rangschikt beleggers beter dan de alternatieven
In de validatiehelft bereikt de basisscorekaart een AUC van 0.744, gelijk aan een Gini-coëfficiënt van 0.488. Bij willekeurige selectie scoort een belegger die een gekwalificeerd gesprek aannam ongeveer drie op vier keer hoger dan een belegger die dat niet deed. Twee vergelijkingsmaatstaven plaatsen dat cijfer in context. Rangschikken op bekendheid, de gewoonte om te beginnen met de grootste en bekendste namen, levert 0.524 op. Dat ligt dicht bij toeval omdat bekendheid geen effect op uitkomsten kreeg. Alleen op relatie rangschikken levert 0.550 op: relaties hebben invloed in het genererende model, maar slechts een vijfde van de beleggers heeft er een, zodat de regel de rest niet kan ordenen.
De bovengrens is even informatief als het resultaat. Beleggers rangschikken op de genererende kans zelf, die geen team zou kunnen kennen, levert 0.833 op. Het verschil tussen 0.744 en die bovengrens heeft drie oorzaken. Registraties zijn onvolmaakt: dezelfde gewichten op perfecte gegevens bereiken 0.782. De scorekaart laat de relatie buiten beschouwing. En de term voor beleggingsinteresse is per constructie niet waarneembaar. Een op documenten gebaseerde score kan dat laatste verschil niet dichten; een team mag dat ook niet verwachten.
Gewichten zijn minder bepalend dan wellicht verwacht. Een logistische regressie, geschat op de ontwikkelhelft met de vier vastgelegde invoervariabelen en de relatie, bereikt 0.758. De vier fitcoëfficiënten worden genormaliseerd op een totaal van 100; hun afzonderlijk afgeronde aandelen zijn 35 / 18 / 19 / 29 en tellen door afronding op tot 101. Zij liggen dicht bij de vooraf gekozen 30, 20, 20 en 30. Een scorekaart met gelijke gewichten van 25 bereikt 0.732. In deze populatie beïnvloeden de keuze van variabelen en de kwaliteit van de gegevens het onderscheidend vermogen sterker dan een fijne afstelling van punten.
11 Lift per deciel concentreert de eerste ronde
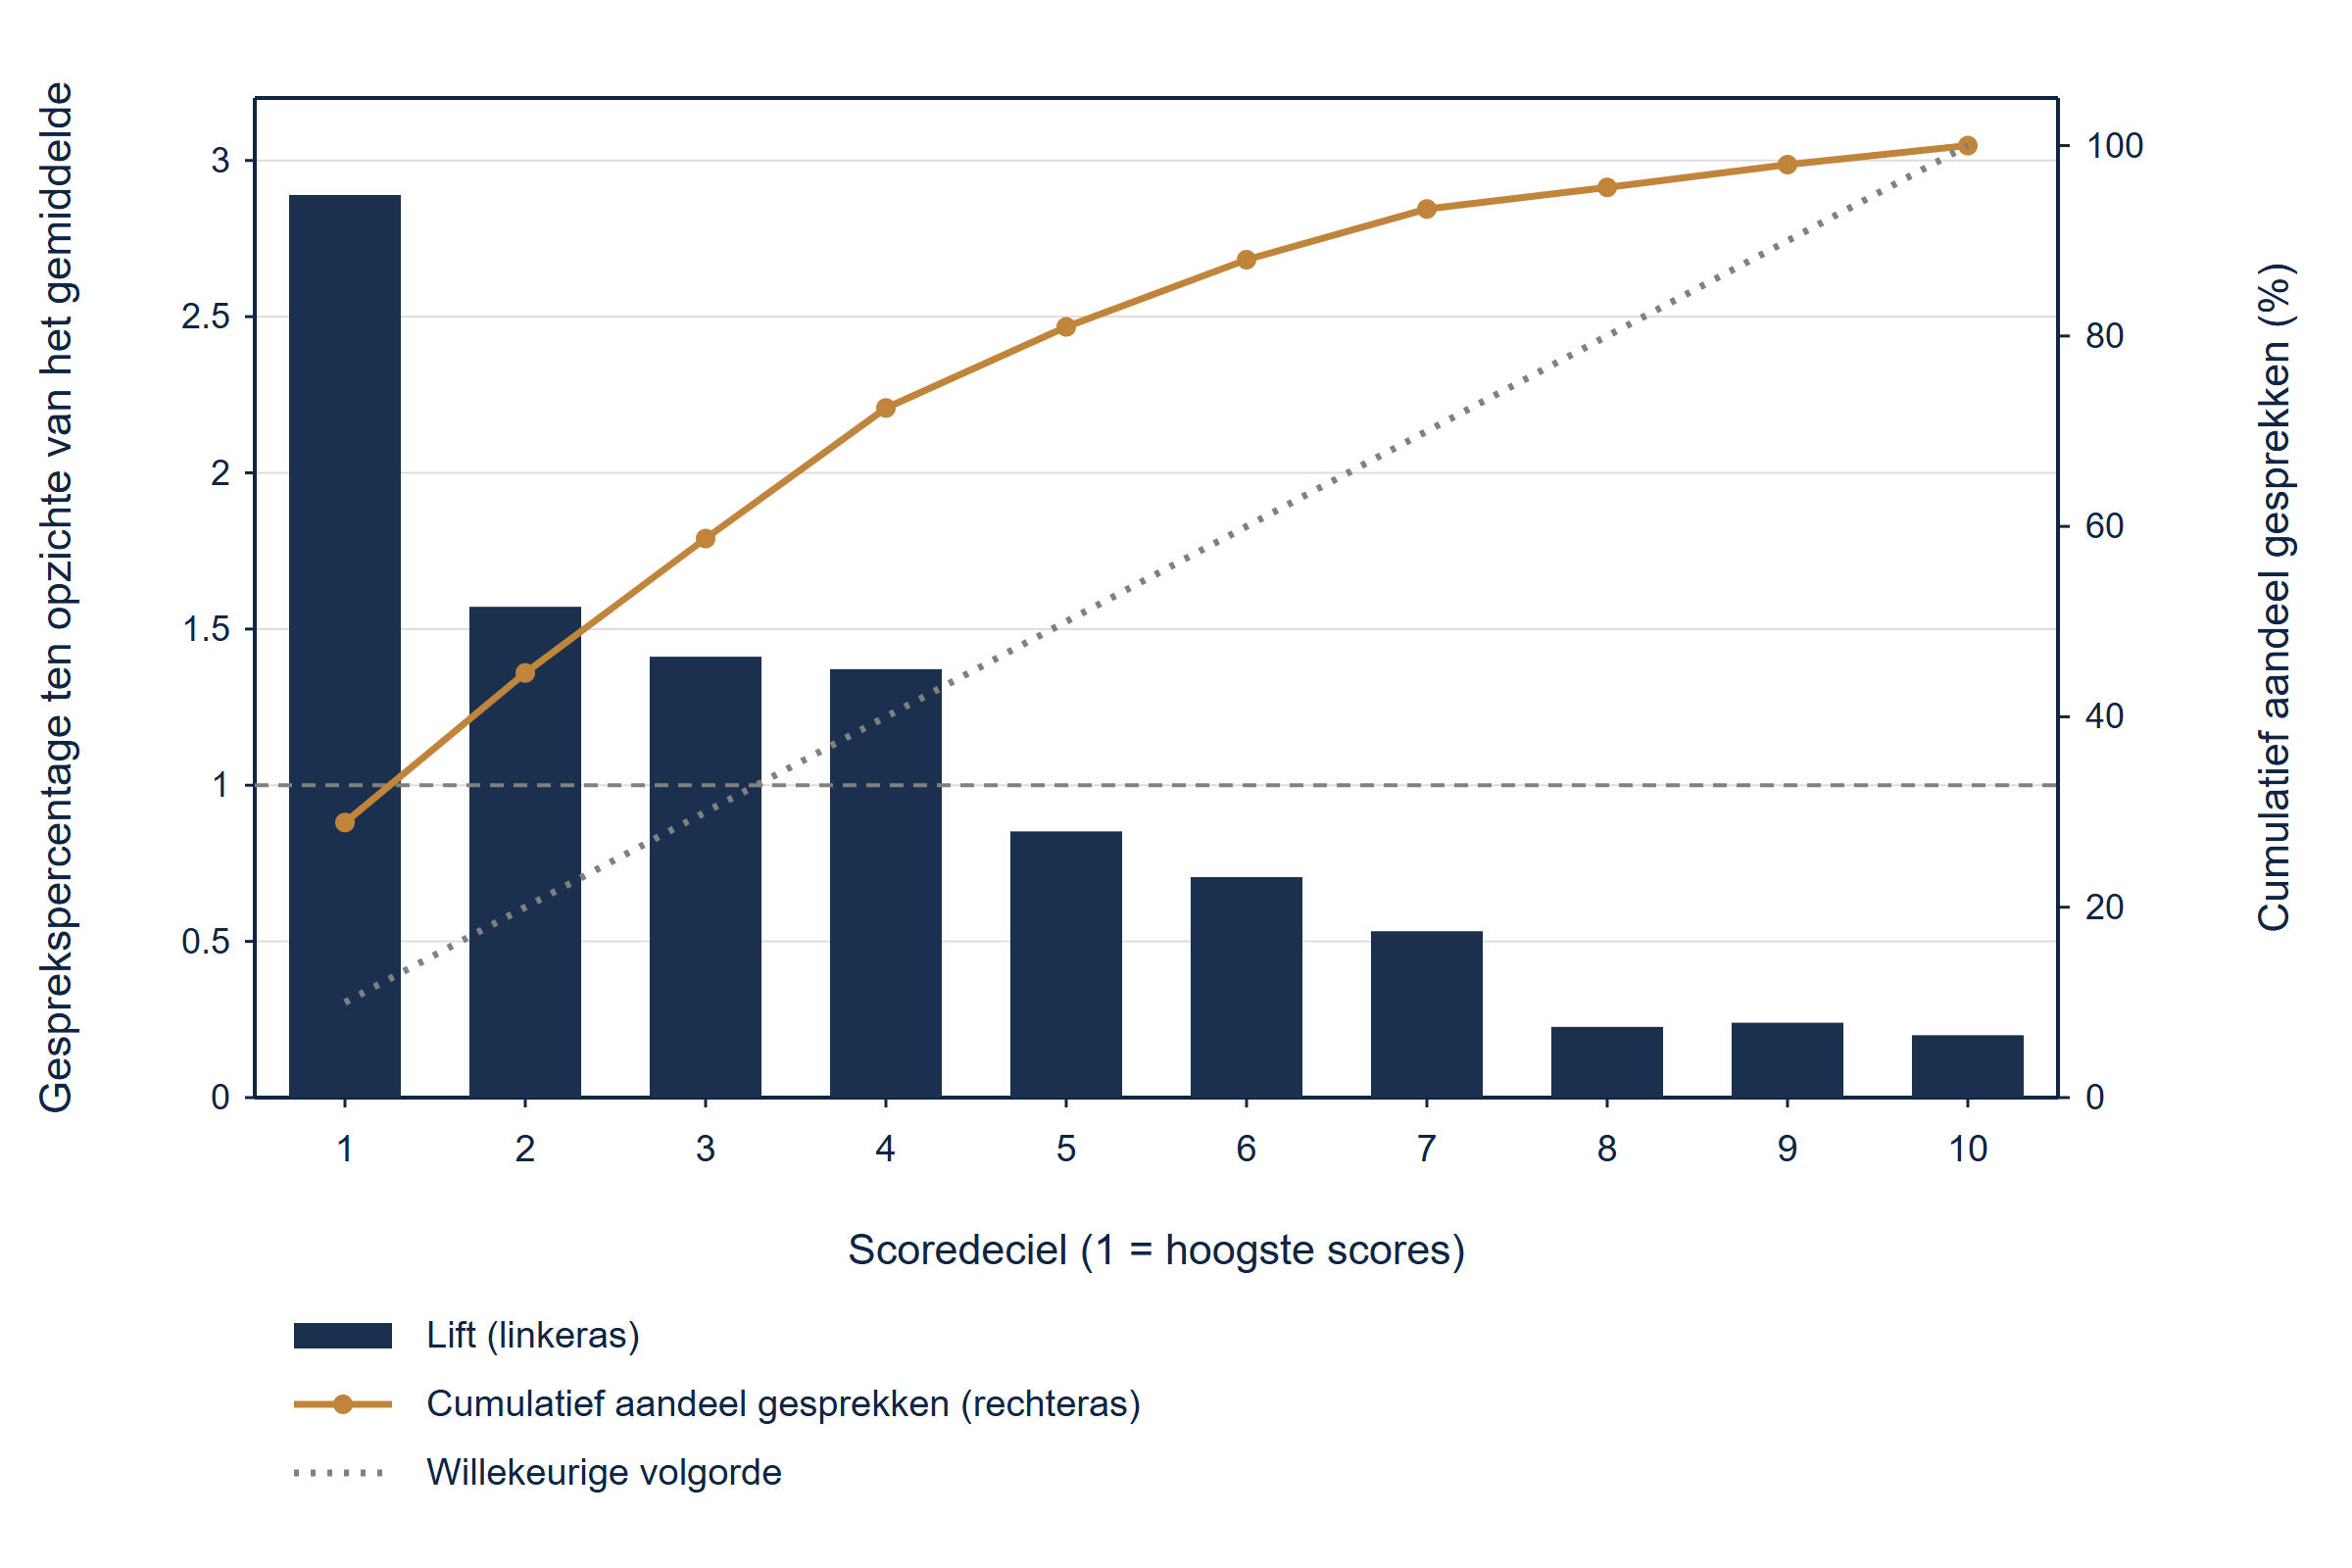
Tabel 5 en figuur 1 rangschikken de validatiehelft op score en verdelen haar in tien even grote groepen. Een scorekaart met vier invoervariabelen levert weinig verschillende waarden op. Beleggers met gelijke scores worden daarom geordend met een vaste willekeurige sleutel, waardoor de scorebandbreedtes van aangrenzende decielen elkaar raken. Het hoogste deciel behaalt 36.2% gesprekken, 2.89 maal het gemiddelde van 12.5%. Het laagste deciel behaalt 2.5%, een lift van 0.20. De hoogste twee decielen omvatten 44.6% van alle gekwalificeerde gesprekken, de hoogste drie 58.7% en de hoogste helft 81.0%.
De vorm van de curve draagt de beslissing. Lift daalt sterk na het eerste deciel en zakt tussen het vierde en vijfde onder één. Daaronder is iedere benadering minder productief dan een willekeurige; in het achtste deciel is zij ongeveer een kwart zo productief. Een team dat de hele lijst wil benaderen wint met de score geen extra gesprekken in totaal, alleen een andere volgorde waarin zij plaatsvinden. De score is een instrument voor volgordebepaling en is het waardevolst wanneer capaciteit het schaarsst is.
| Deciel | Beleggers | Scorebandbreedte | Gesprekken | Gegenereerd percentage | Voorspeld percentage | Lift | Cumulatief aandeel |
|---|---|---|---|---|---|---|---|
| 1 | 600 | 75 tot 100 | 217 | 36.2% | 39.1% | 2.89 | 28.9% |
| 2 | 600 | 65 tot 75 | 118 | 19.7% | 23.1% | 1.57 | 44.6% |
| 3 | 600 | 60 tot 65 | 106 | 17.7% | 16.7% | 1.41 | 58.7% |
| 4 | 600 | 55 tot 60 | 103 | 17.2% | 13.0% | 1.37 | 72.4% |
| 5 | 600 | 50 tot 55 | 64 | 10.7% | 9.6% | 0.85 | 81.0% |
| 6 | 600 | 45 tot 50 | 53 | 8.8% | 7.9% | 0.71 | 88.0% |
| 7 | 600 | 35 tot 45 | 40 | 6.7% | 5.8% | 0.53 | 93.3% |
| 8 | 600 | 30 tot 35 | 17 | 2.8% | 4.3% | 0.23 | 95.6% |
| 9 | 600 | 20 tot 30 | 18 | 3.0% | 3.0% | 0.24 | 98.0% |
| 10 | 600 | 0 tot 20 | 15 | 2.5% | 1.6% | 0.20 | 100.0% |
MatchPoint-analyse van de geconstrueerde populatie. Modeluitvoer onder expliciete invoer; geen resultaat van een waargenomen cohort. Afgeronde weergave. Het voorspelde percentage gebruikt de functie die op de ontwikkelhelft is geschat.
Schuif horizontaal om de figuur op volledige grootte te lezen. U kunt de figuur ook op volledige grootte openen.
MatchPoint-analyse van de geconstrueerde populatie, validatiehelft. Modeluitvoer onder expliciete invoer; geen waargenomen cohort.
12 Kalibratie zet een rang om in een planningskans
Een rang vertelt het team waar het moet beginnen. Een kans vertelt hoeveel benaderingen nodig zijn voor een beoogd aantal gesprekken; dat is het cijfer waarnaar een klant vraagt. Op de ontwikkelhelft schatten wij een logistische omzettingsfunctie met twee parameters van score naar kans, met een intercept van -4.89 en een coëfficiënt van 5.30 op de score gedeeld door 100. De functie kent 9.6% toe aan een score van 50, 23.4% aan een score van 70 en 60.0% aan een score van 100. Toegepast op de validatiehelft voorspelt zij gemiddeld 12.4% tegenover een gegenereerd percentage van 12.5%.
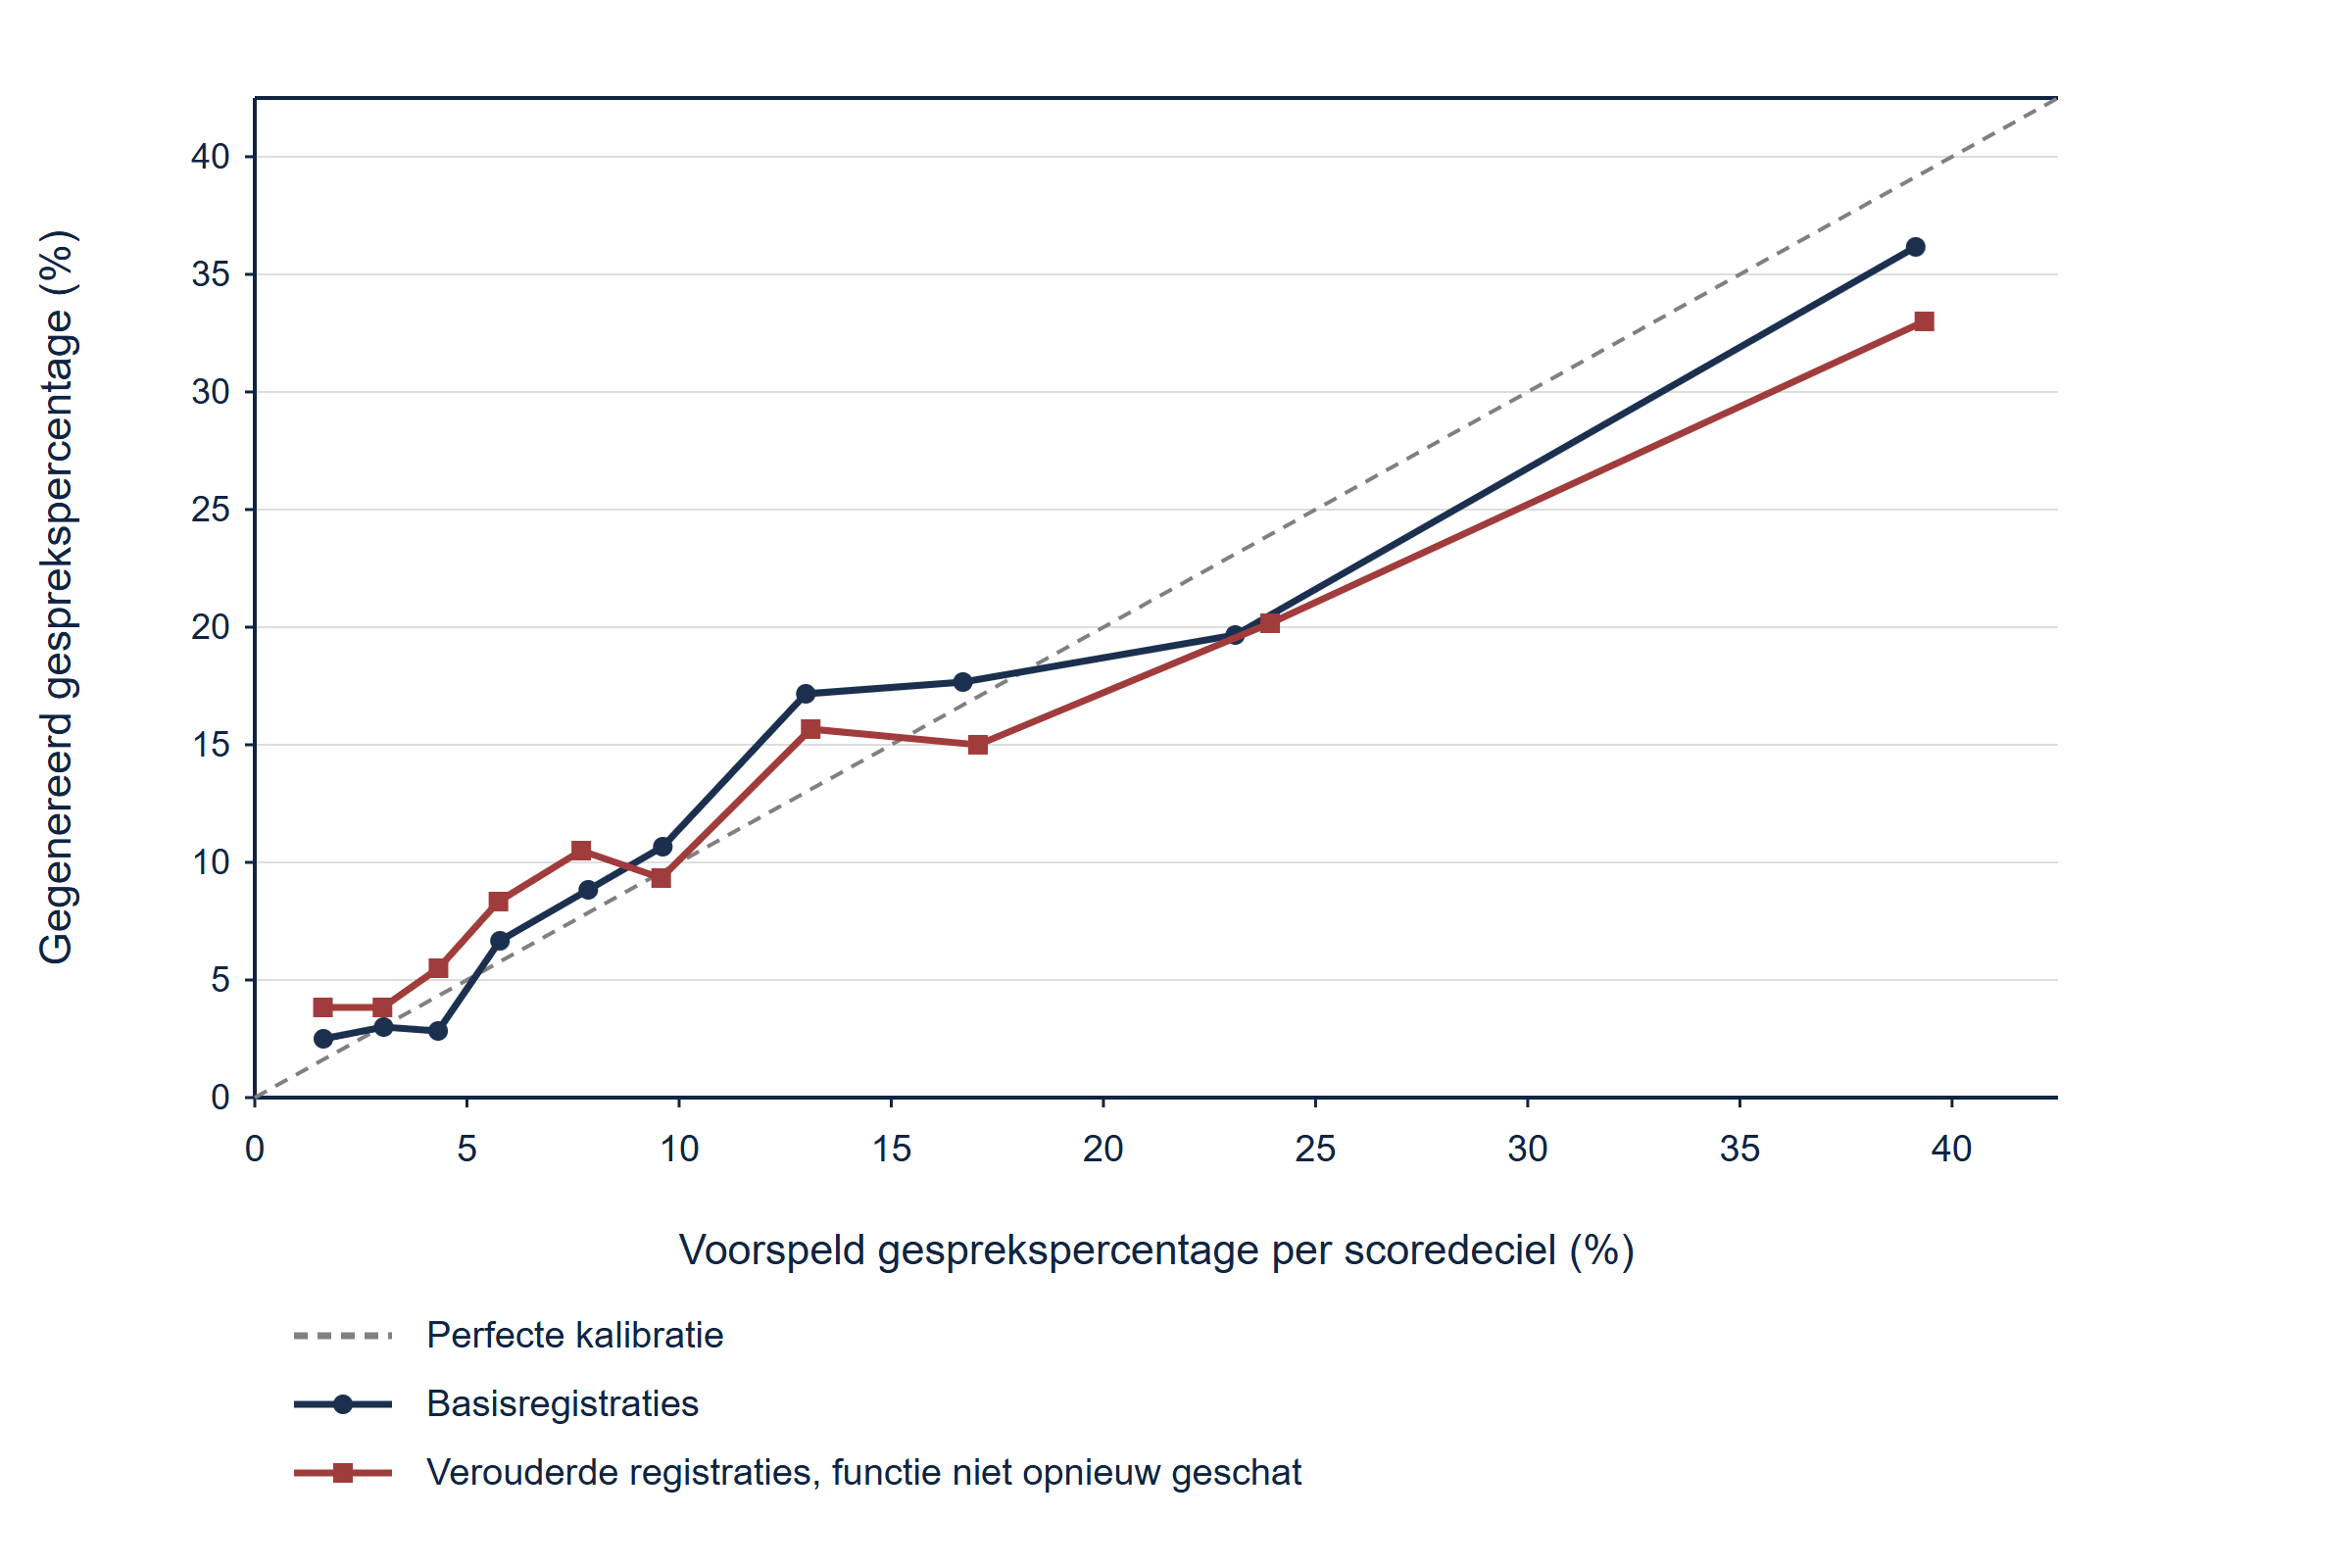
Het kalibratie-intercept in de validatiehelft is 0.01 en de helling is 0.89. De gemiddelde kalibratie is dus deugdelijk, terwijl de helling onder één wijst op enigszins te extreme voorspellingen. Tabel 5 laat zien waar: voor het hoogste deciel was 39.1% voorspeld, terwijl 36.2% een gesprek aannam. Het grootste verschil tussen voorspelde en gegenereerde percentages in een deciel is 4.2 procentpunt. Figuur 2 zet de tien decielen af tegen de diagonaal. De Brier-score is 0.0994, tegenover 0.1095 voor een voorspelling die iedere belegger het gemiddelde percentage toekent, een verbetering van 9.2%.
Hieruit volgen twee kanttekeningen. De helling is geschat op 751 gesprekken uit één uitkomsttrekking. Een deel van de afwijking van één is steekproefvariatie en geen eigenschap van de functie; zij wordt gerapporteerd zoals gevonden en is niet aangepast. Belangrijker is dat de omzettingsfunctie het kwetsbare deel van de scorekaart is. De scoregewichten blijven in deze stresstoets vast, terwijl de kansfunctie is geschat op het oorspronkelijke geconstrueerde responsmechanisme. Paragraaf 16 houdt de scorevolgorde vast en verandert de gesprekskansen; het scenario met een zwakkere markt overschat gesprekken met meer dan de helft.
Schuif horizontaal om de figuur op volledige grootte te lezen. U kunt de figuur ook op volledige grootte openen.
MatchPoint-analyse van de geconstrueerde populatie, validatiehelft. De lijn voor verouderde registraties past de op basisgegevens geschatte functie toe zonder deze opnieuw te schatten.
13 De trechter volgen van eerste gesprek tot toezegging
Een eerste gesprek is een tussenuitkomst. Het experiment voert iedere belegger daarom door due diligence en toezegging, met de voorwaardelijke structuur die de venture-enquête voor de kant van de belegger documenteert. [4]
In vergelijking (4a) is C gelijk aan één wanneer belegger i toezegt; p is de kans op een gekwalificeerd gesprek, q de kans op due diligence gegeven een gesprek en c de kans op een toezegging gegeven due diligence. In vergelijking (4b) is E het verwachte aantal toezeggingen uit een eerste ronde van K benaderingen en is T de verzameling van de K hoogst gerangschikte beleggers volgens de getoetste regel. Strategie en investeringsomvang bepalen due diligence in het genererende model, investeringsomvang en beslissingscyclus bepalen toezegging en de niet-vastgelegde beleggingsinteresse speelt in iedere fase een rol.
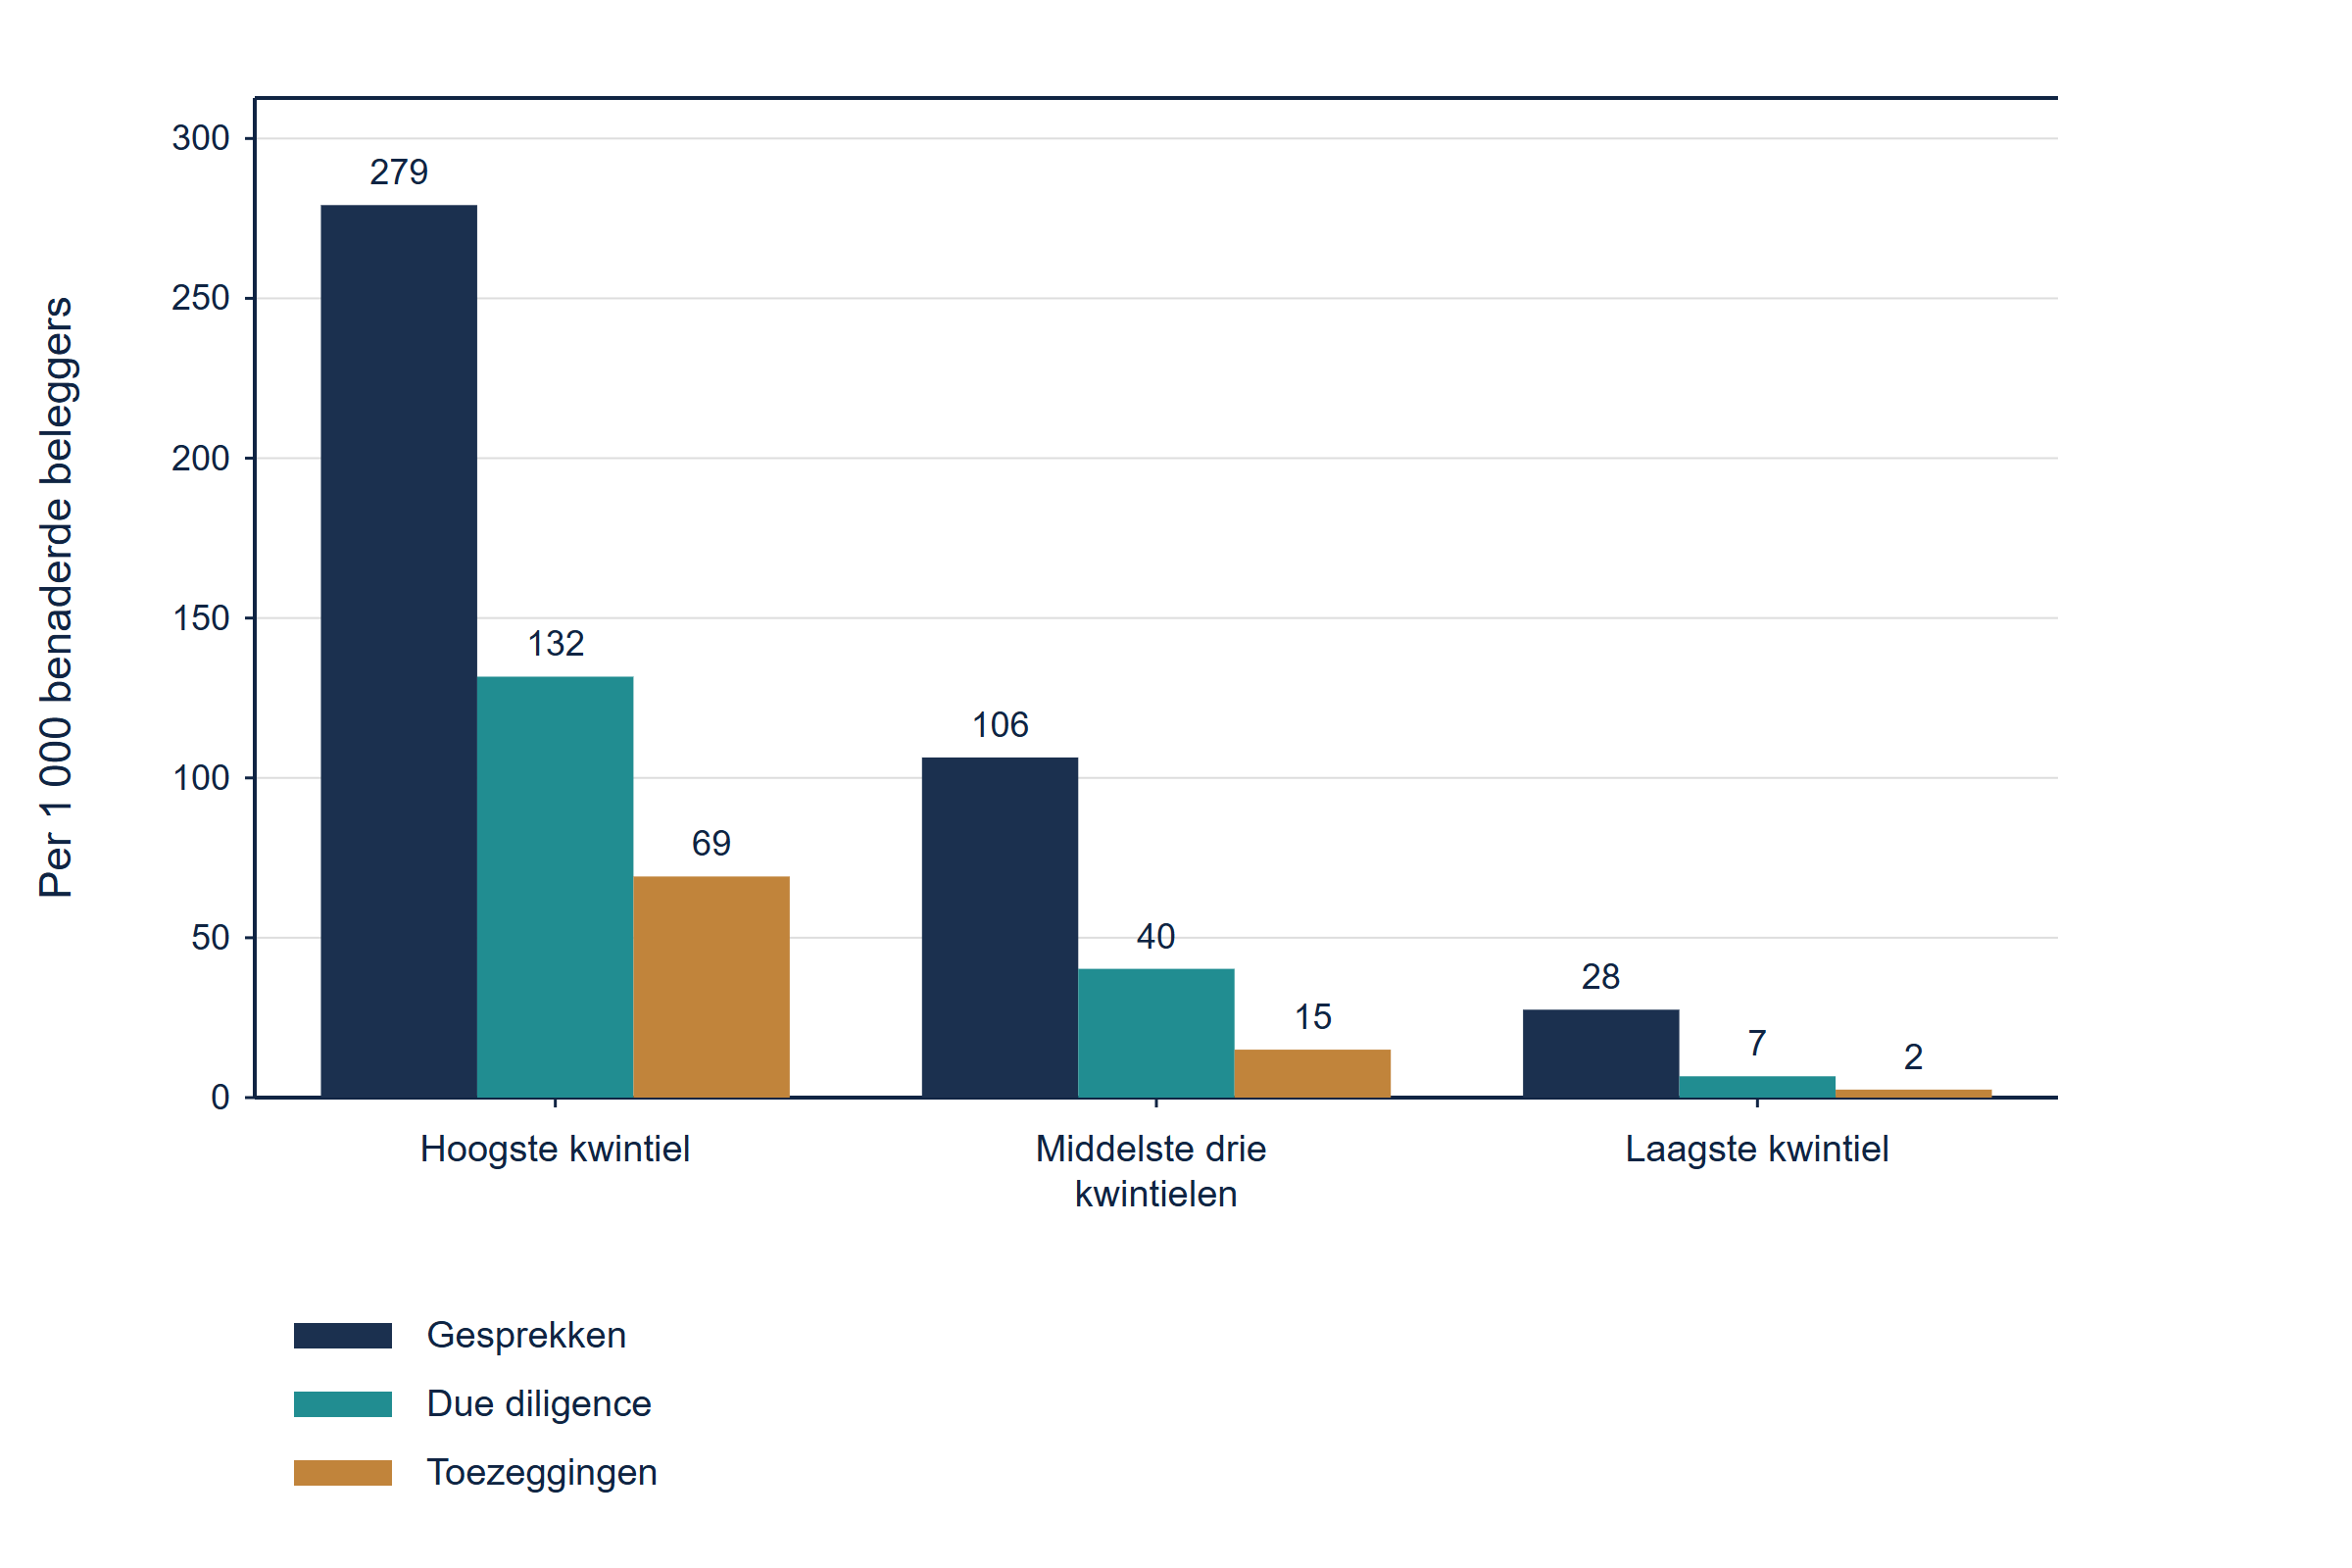
Tabel 6 en figuur 3 rapporteren gegenereerde uitkomsten per scoreband. Het hoogste kwintiel behaalt 27.9% gesprekken, zet 47.2% van de gesprekken om in due diligence en 52.5% van de due-diligencegevallen in een toezegging, goed voor 69.2 toezeggingen per 1 000 benaderingen. De middelste drie kwintielen leveren 15.0 op en het laagste kwintiel 2.5. Het hoogste kwintiel levert 83 van de 140 toezeggingen, ofwel 59.3%. De score rangschikt toezeggingen met een AUC van 0.791, iets hoger dan bij gesprekken, omdat de variabelen die de deur openen ook de latere fasen dragen.
Eén cijfer relativeert dit resultaat. Onder beleggers die al een gesprek hebben aangenomen, onderscheidt de score degenen die doorgaan naar due diligence met een AUC van slechts 0.595. Zodra een belegger aan tafel zit, heeft de scorekaart weinig meer te zeggen. Wat resteert is de beleggingsinteresse die zij niet ziet en de kwaliteit van de kans, die het experiment niet modelleert. De absolute conversiepercentages zijn door de auteur bepaald en veel hoger dan de circa één afgeronde transactie per 100 kansen die venturecapitalondernemingen rapporteren. [4] Zij beschrijven een vooraf gescreende longlist in een geconstrueerd geval en mogen niet als marktpercentages worden gelezen.
| Scoreband | Namen | Gesprekken | Due diligence | Ondertekend | Gesprekspercentage | Due-diligencepercentage | Ondertekeningspercentage | Ondertekend per 1 000 |
|---|---|---|---|---|---|---|---|---|
| Hoogste kwintiel | 1,200 | 335 | 158 | 83 | 27.9% | 47.2% | 52.5% | 69.2 |
| Middelste drie kwintielen | 3,600 | 383 | 145 | 54 | 10.6% | 37.9% | 37.2% | 15.0 |
| Laagste kwintiel | 1,200 | 33 | 8 | 3 | 2.8% | 24.2% | 37.5% | 2.5 |
| Alle | 6,000 | 751 | 311 | 140 | 12.5% | 41.4% | 45.0% | 23.3 |
MatchPoint-analyse van de geconstrueerde populatie. Modeluitvoer onder expliciete invoer; geen resultaat van een waargenomen cohort. Afgeronde weergave. Namen zijn benaderde beleggers; ondertekend betekent een toezegging; het due-diligencepercentage is per gesprek en het ondertekeningspercentage per due-diligencegeval.
Schuif horizontaal om de figuur op volledige grootte te lezen. U kunt de figuur ook op volledige grootte openen.
MatchPoint-analyse van de geconstrueerde populatie, validatiehelft. Gegenereerde uitkomsten; trechterpercentages zijn door de auteur vastgestelde invoer.
14 Capaciteit in de eerste ronde zet lift om in een beslissing
De volgordebeslissing heeft een budget. Stel dat de eindverantwoordelijken in de eerste ronde 100 goed voorbereide benaderingen kunnen doen per 1 000 namen op de longlist. Tabel 7 vergelijkt rangschikkingsregels binnen dat budget met verwachtingswaarden uit de genererende kansen. Dit verwijdert de ruis van een nieuwe Bernoulli-uitkomsttrekking uit de vergelijking, maar behoudt de afhankelijkheid van de eindige geconstrueerde populatie, de trekkingen voor rangschikking en afhandeling van gelijke scores en de aangenomen parameters. Willekeurige volgorde levert 12.9 verwachte gesprekken en 2.40 toezeggingen op. Bekendheid levert 13.1 en 2.44 op. Relaties eerst levert 19.9 en 3.55 op. De basisscorekaart levert 36.8 en 8.80 op: 2.8 maal de gesprekken en 3.7 maal de toezeggingen van willekeurige volgorde.
De vergelijking met relatiegedreven benadering is die waarmee de meeste teams te maken hebben. Beginnen met bekende beleggers is in het geconstrueerde geval beter dan willekeurig, omdat relaties een werkelijk effect in het model hebben. Toch produceert de scorekaart bij hetzelfde aantal benaderingen 2.5 maal zoveel verwachte toezeggingen. Het geschatte model dat beide gebruikt bereikt 39.5 gesprekken. De praktische lezing is dat fit de namen moet bepalen en de relatie de benaderingsroute. De scorekaart bereikt 74% van de gesprekken die perfecte voorkennis zou opleveren; geen documentgebaseerde rangschikking in de tabel dicht dat verschil.
| Rangschikkingsregel | Benaderingen | Verwachte gesprekken | Verwachte due diligence | Verwachte toezeggingen | Benaderingen per toezegging |
|---|---|---|---|---|---|
| Willekeurige volgorde | 100 | 12.9 | 5.5 | 2.40 | 42 |
| Alleen bekendheid | 100 | 13.1 | 5.6 | 2.44 | 41 |
| Relaties eerst | 100 | 19.9 | 8.3 | 3.55 | 28 |
| Onjuiste gewichten | 100 | 23.0 | 10.7 | 5.56 | 18 |
| Verouderde registraties | 100 | 31.1 | 15.2 | 6.94 | 14 |
| Basisscorekaart | 100 | 36.8 | 18.6 | 8.80 | 11 |
| Geschatte gewichten plus relatie | 100 | 39.5 | 20.0 | 9.39 | 11 |
| Genererende kans (niet haalbaar) | 100 | 49.6 | 27.4 | 13.78 | 7 |
MatchPoint-analyse van de geconstrueerde populatie. Modeluitvoer onder expliciete invoer; geen resultaat van een waargenomen cohort. Afgeronde weergave. Verwachtingswaarden uit genererende kansen.
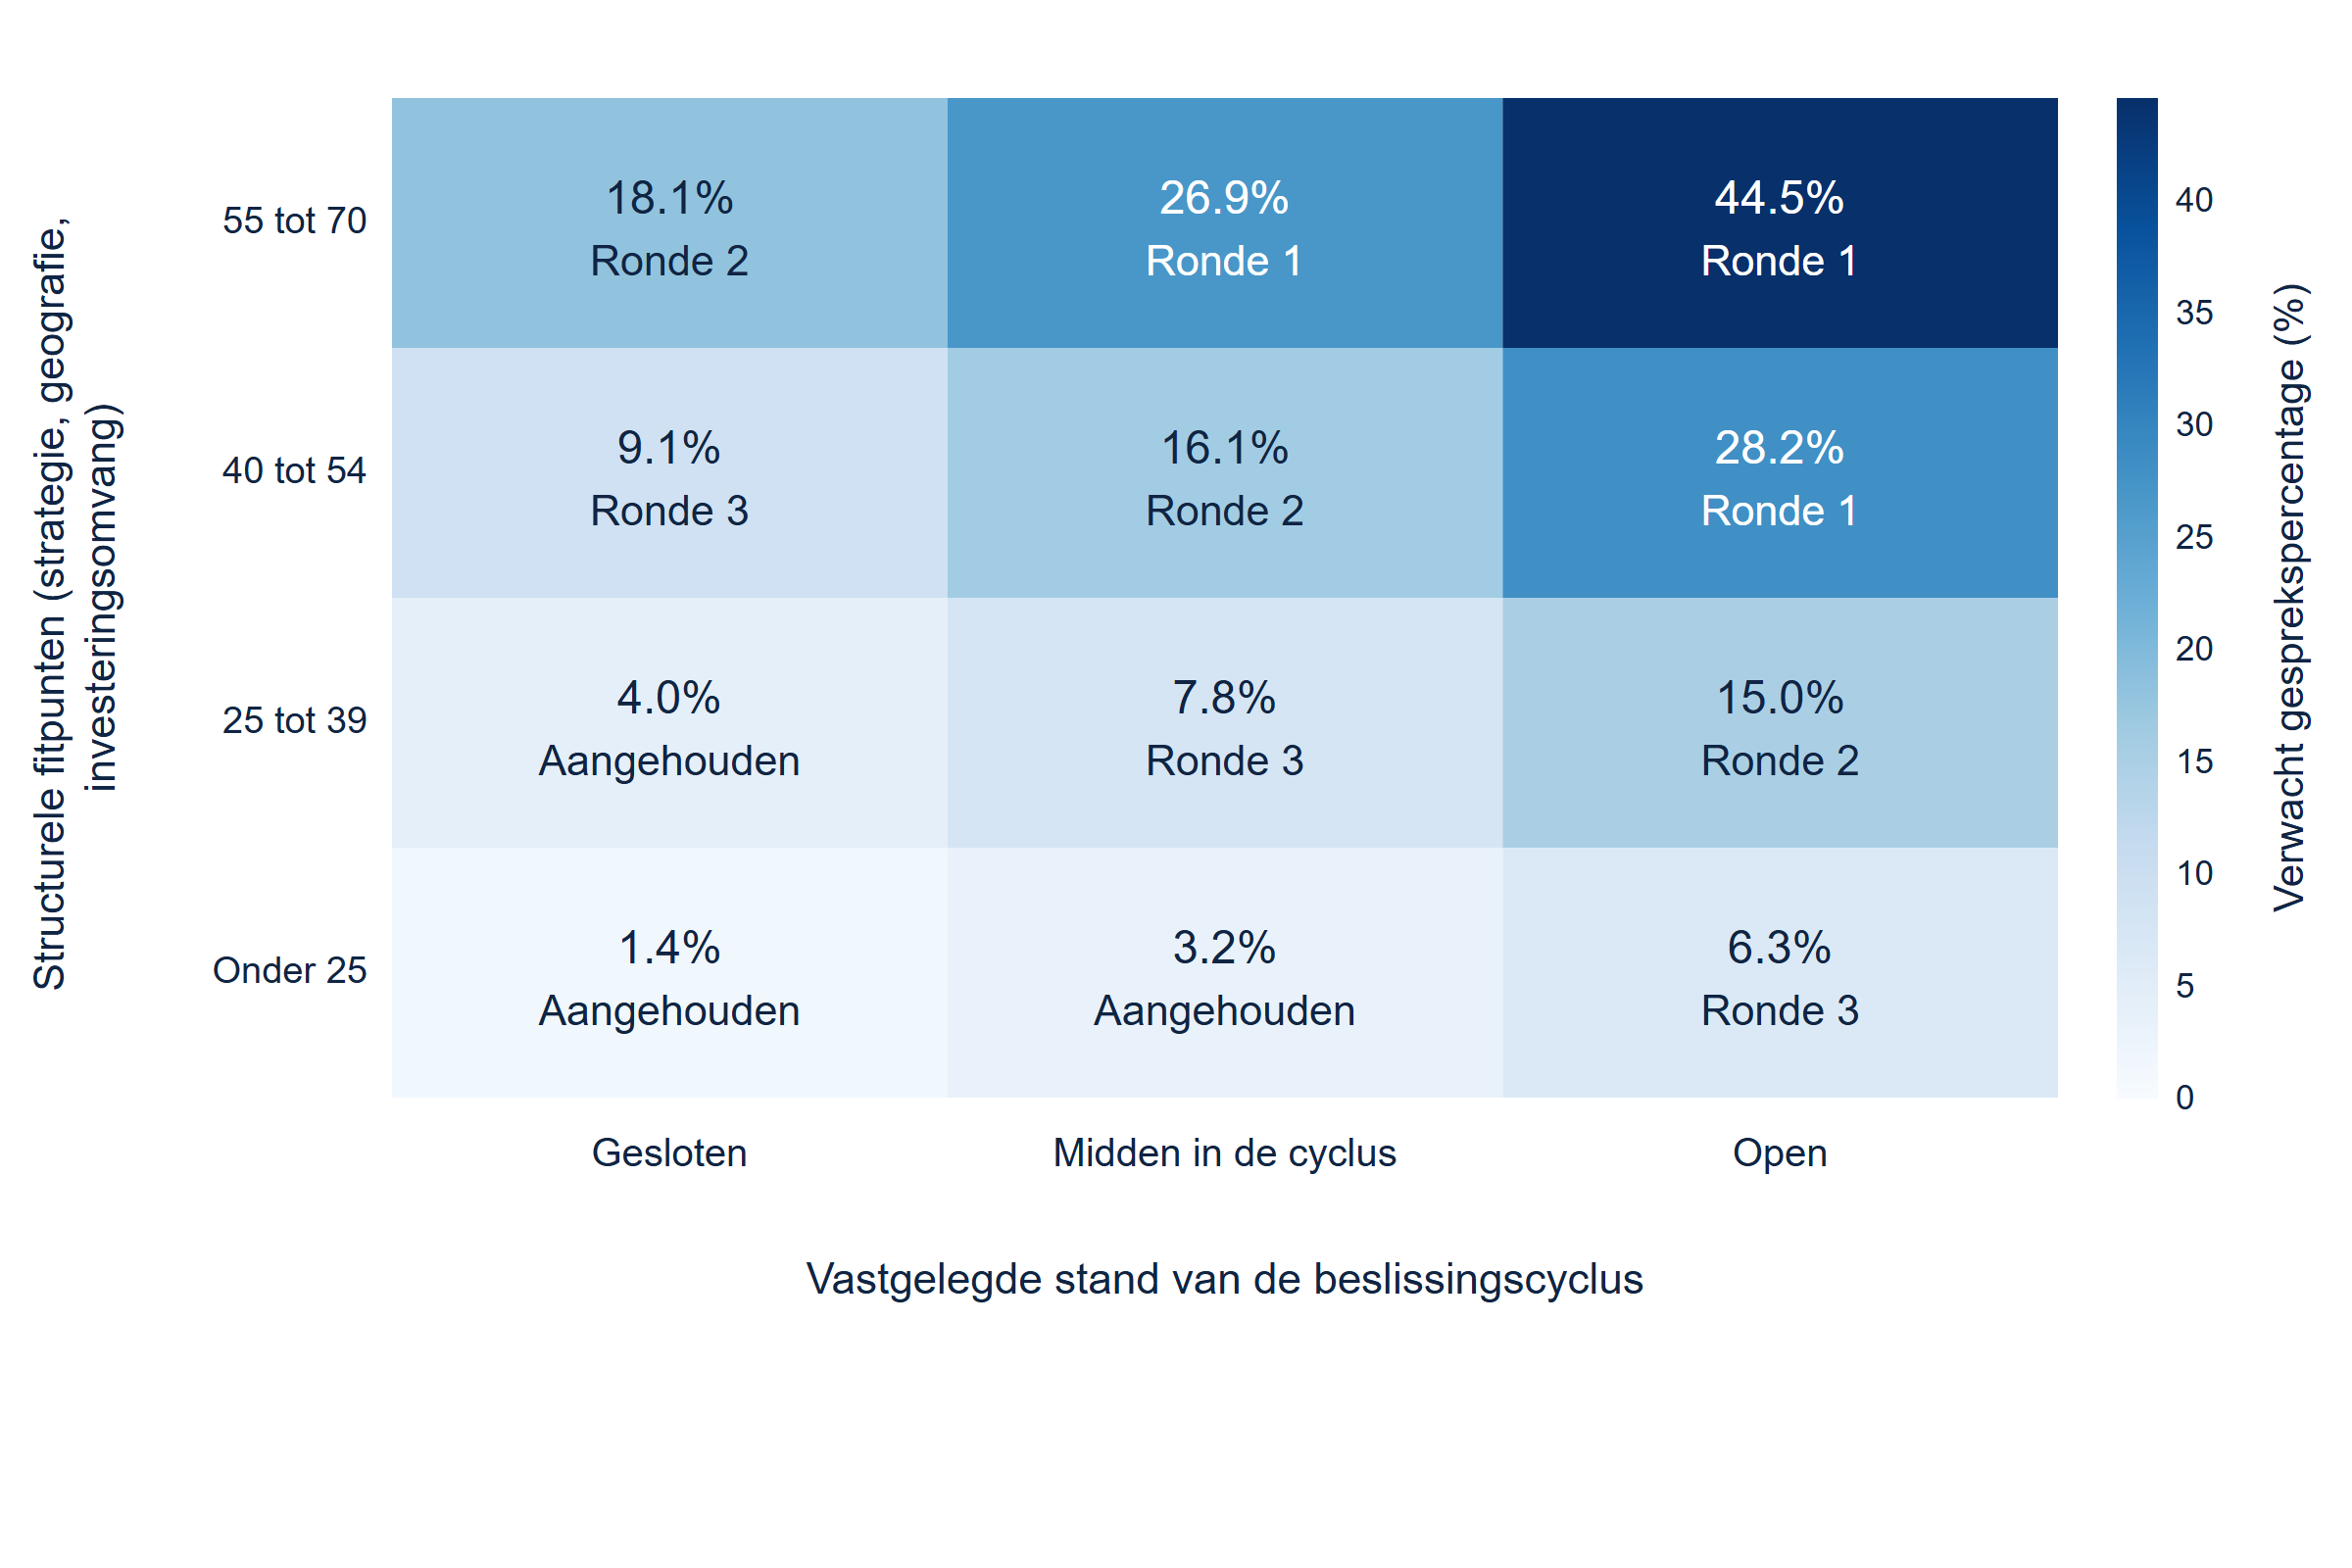
Figuur 4 is de kaart voor de benaderingsvolgorde. Zij scheidt structurele fitpunten, op een maximum van 70, van de vastgelegde stand van de beslissingscyclus. Iedere cel toont het verwachte gesprekspercentage en de ronde waaraan de meeste beleggers in die cel zijn toegewezen. In de hoogste fitband stijgt het percentage van 18.1% bij een als gesloten vastgelegde cyclus naar 44.5% bij een open cyclus, een factor 2.5. Ronden worden bepaald op de totaalscore: 70 of meer, 55 tot 69, 40 tot 54 en een aangehouden groep onder 40. Ronde 1 omvat 16.8% van de lijst en 43.6% van de verwachte gesprekken. Ronden 1 en 2 omvatten samen 40.2% van de lijst en 73.7%.
De aangehouden groep is de minder comfortabele helft van de beslissing. Zij omvat 30.9% van de lijst en 7.5% van de verwachte gesprekken, bij 33.6 benaderingen per gesprek tegenover 3.2 in ronde 1. Deze namen aanhouden beschermt de tijd van eindverantwoordelijken en de reputatie van de kans. Het laat ook werkelijke gesprekken liggen, omdat een ten onrechte als gesloten geregistreerde cyclus nog steeds open is. De kaart heeft daarom een actualiseringsregel nodig: aanhouden is een gedateerde status die tegelijk met de registratie wordt beoordeeld en nooit een permanente uitsluiting.
Schuif horizontaal om de figuur op volledige grootte te lezen. U kunt de figuur ook op volledige grootte openen.
MatchPoint-analyse van de geconstrueerde populatie, validatiehelft. Cellen tonen de gemiddelde genererende kans op een gekwalificeerd gesprek en de meest voorkomende ronde.
15 Niet-willekeurige benadering verandert wat een cohort lijkt te tonen
Tot dusver werd aangenomen dat iedere belegger werd benaderd. Een echte historie is anders: het team koos wie het benaderde en had daarvoor redenen. Heckman karakteriseert steekproefselectiebias als een specificatiefout en stelt een schatter voor die deze corrigeert. [14] Wanneer de toelatingsregel tot de steekproef samenhangt met de uitkomst, zijn schattingen uit de steekproef vertekend tenzij die regel wordt gemodelleerd. Seaman en White bespreken een oplossing, inverse-probabilityweging, waarbij ieder waargenomen geval wordt gewogen met het omgekeerde van zijn waarnemingskans. Ook bespreken zij hoe het model voor die kans wordt gekozen. [15]
In vergelijking (5a) is A gelijk aan één wanneer belegger i werd benaderd; pi is de kans op die benadering, z omvat vastgelegde kenmerken en u is de niet-vastgelegde beleggingsinteresse. In vergelijking (5b) telt het herwogen gesprekspercentage, mu met een dakje, de uitkomsten van benaderde beleggers op, elk gedeeld door een geschatte benaderingskans die alleen vastgelegde kenmerken kan gebruiken. Wij toetsen drie opzetten op de volledige populatie. In de eerste wordt een kwart van de beleggers willekeurig benaderd. In de tweede geeft het team voorrang aan relaties en bekende namen, die beide zijn vastgelegd. In de derde geeft het voorrang aan relaties, werkelijke fit en beleggers wier beleggingsinteresse het aanvoelt; daarvan is alleen het eerste vastgelegd.
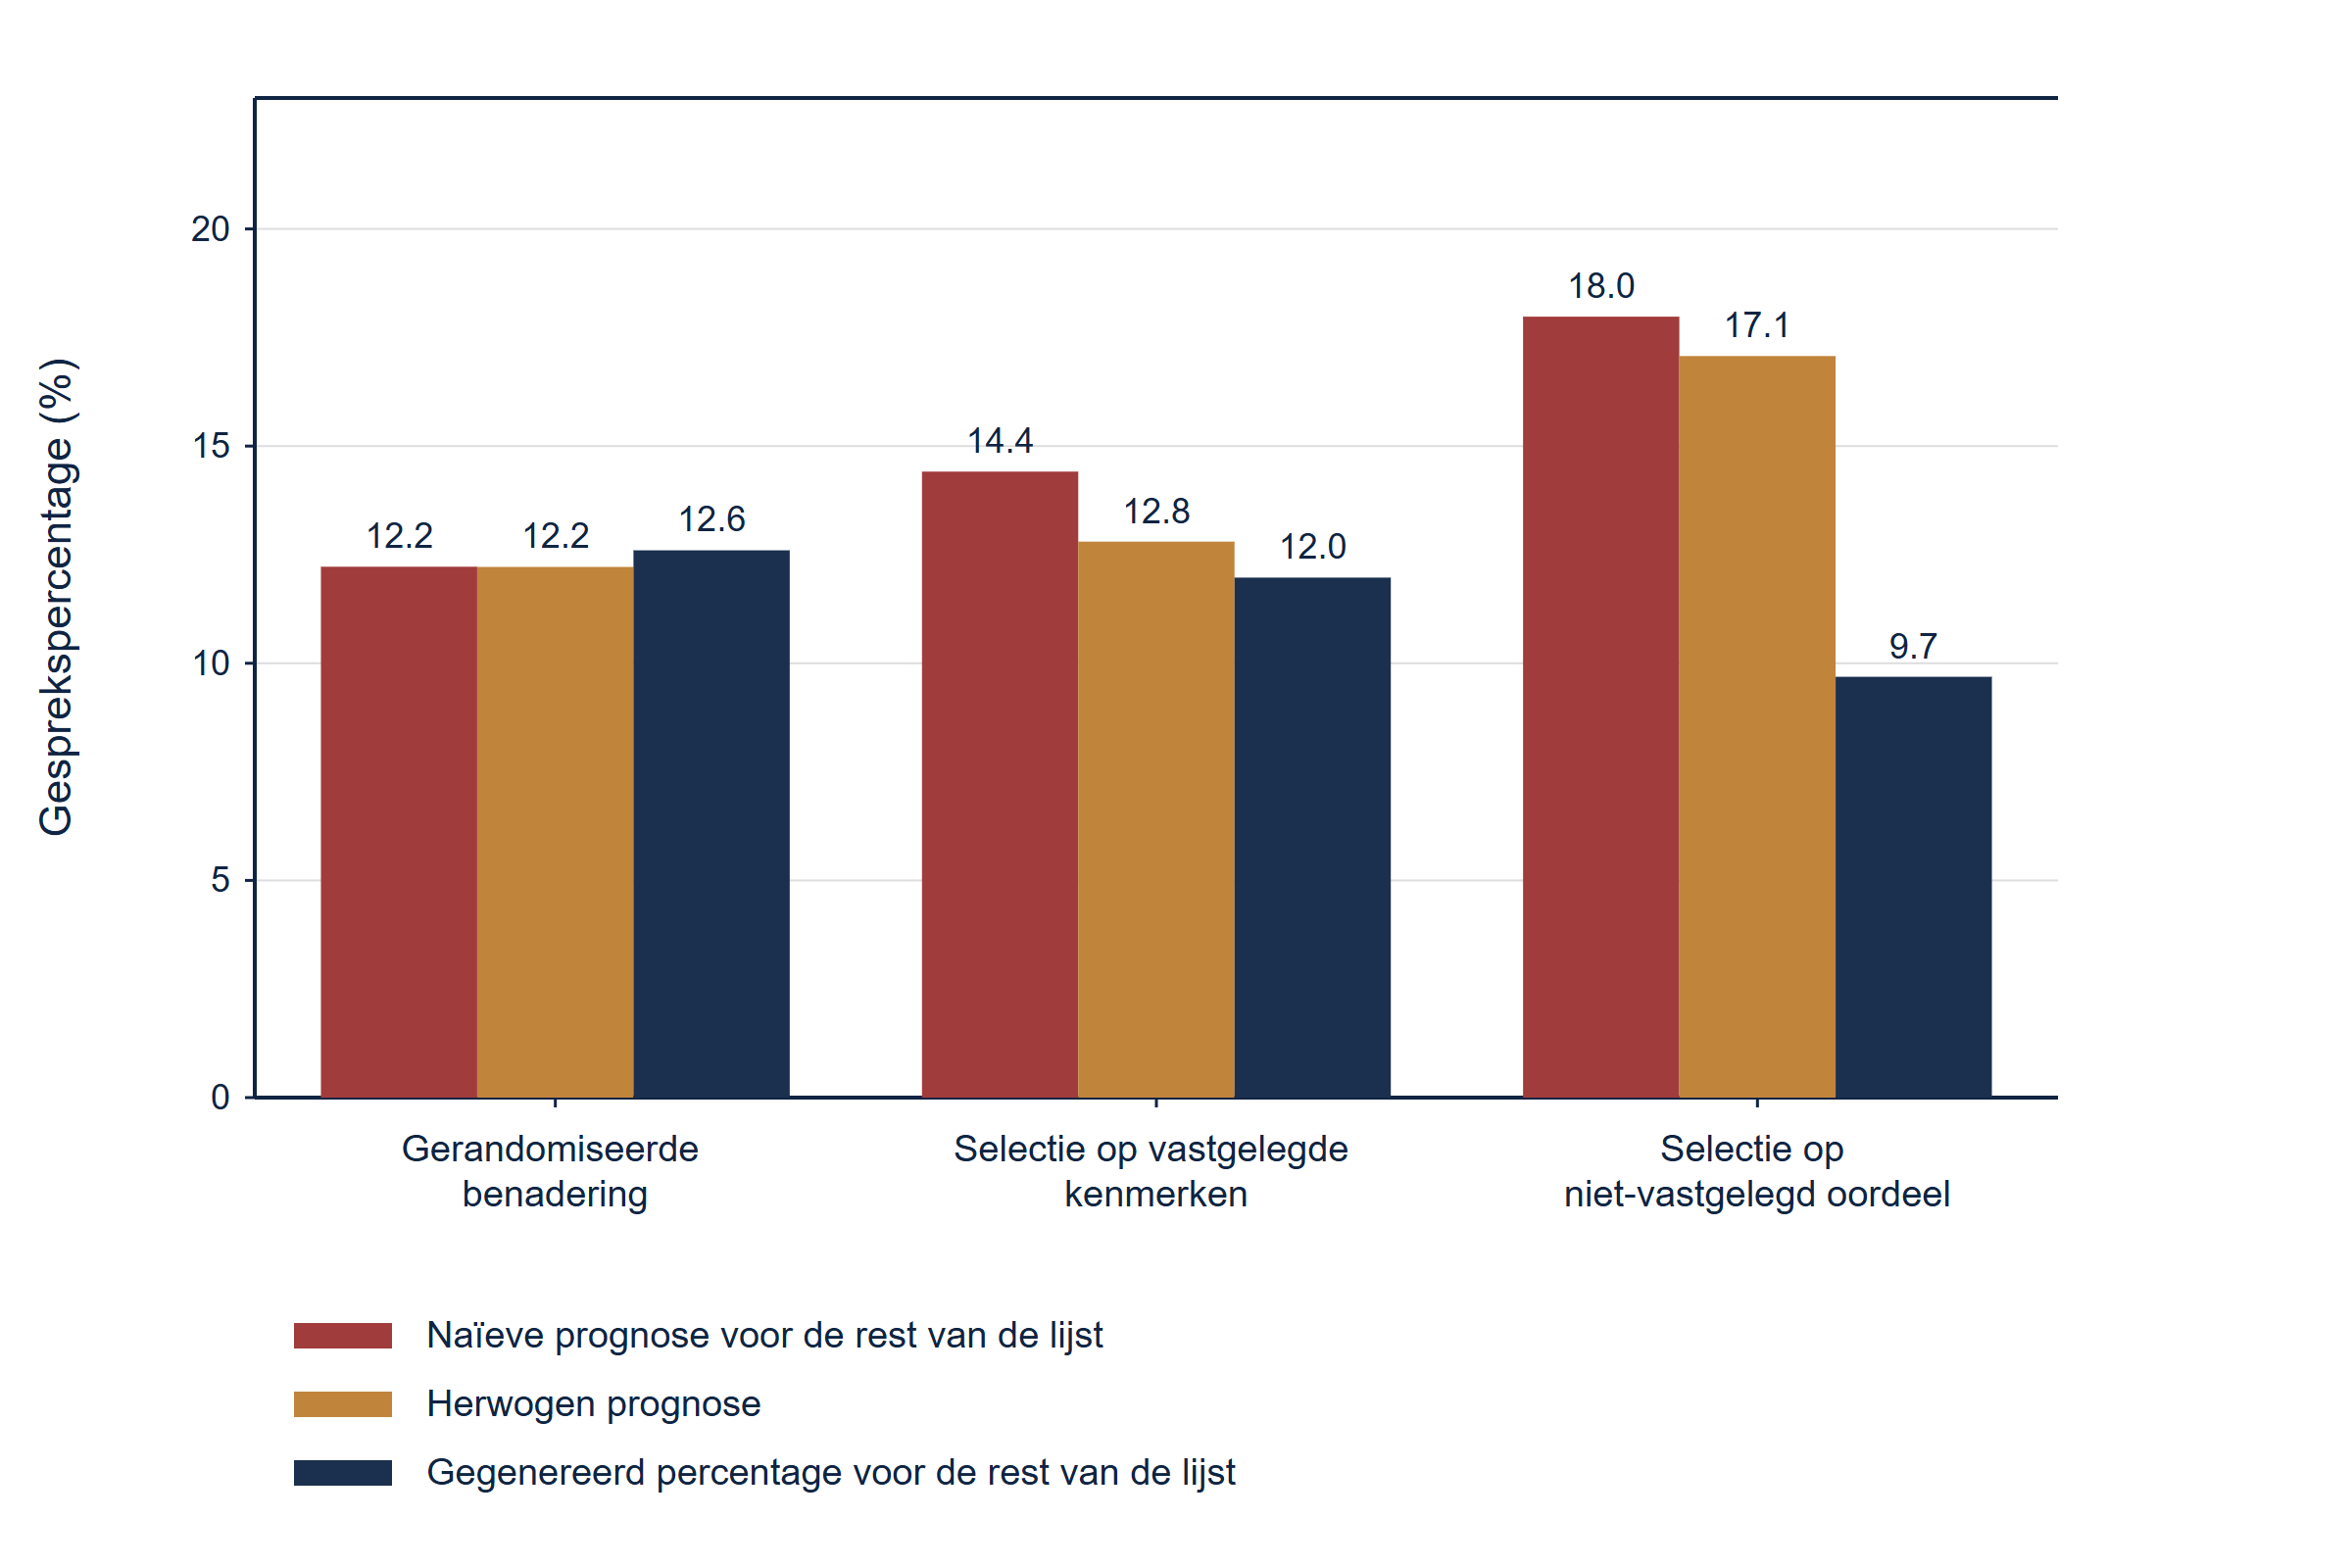
Tabel 8 en figuur 5 geven de resultaten. Gerandomiseerde benadering gedraagt zich zoals verwacht: het cohort behaalt 12.2% gesprekken, de prognose voor nog niet benaderde beleggers is 12.2% en hun gegenereerde percentage is 12.6%. Selectie op vastgelegde kenmerken verhoogt het cohortpercentage tot 14.5%; een naïef op dat cohort geschatte functie voorspelt 14.4% voor de rest van de lijst, tegenover een gegenereerde 12.0%. Herweging brengt de prognose op 12.8%. Wanneer de selectieregel is vastgelegd, is de vertekening bescheiden en grotendeels corrigeerbaar.
Selectie op niet-vastgelegd oordeel werkt anders. Het cohort behaalt 22.5% gesprekken, bijna tweemaal het populatiepercentage, omdat het team goed selecteerde. De naïeve prognose voor de resterende namen is 18.0%; hun gegenereerde percentage is 9.7%. De prognose is een factor 1.86 te hoog en herweging op vastgelegde kenmerken brengt dat slechts terug tot 1.76. Het onderscheidend vermogen wordt minder sterk en in de andere richting beïnvloed: de AUC binnen het cohort is 0.720, tegenover 0.752 in de populatie, omdat een op fit geselecteerd cohort minder slecht passende gevallen bevat om te onderscheiden.
| Benaderingsopzet | Cohortomvang | Gesprekspercentage cohort | Herwogen percentage | AUC in cohort | Naïeve prognose, rest van de lijst | Herwogen prognose, rest van de lijst | Gegenereerd percentage, rest van de lijst |
|---|---|---|---|---|---|---|---|
| Gerandomiseerde benadering | 3,024 | 12.2% | 12.1% | 0.750 | 12.2% | 12.2% | 12.6% |
| Selectie op vastgelegde kenmerken | 2,503 | 14.5% | 13.0% | 0.753 | 14.4% | 12.8% | 12.0% |
| Selectie op niet-vastgelegd oordeel | 2,628 | 22.5% | 18.0% | 0.720 | 18.0% | 17.1% | 9.7% |
MatchPoint-analyse van de geconstrueerde populatie. Modeluitvoer onder expliciete invoer; geen resultaat van een waargenomen cohort. Afgeronde weergave. Gegenereerde percentages voor niet-benaderde beleggers zijn alleen in een geconstrueerde populatie kenbaar.
In deze geconstrueerde selectieopzet verhoogt oordeel het gesprekspercentage in het cohort en verlaagt het het gegenereerde percentage onder niet-benaderde beleggers. Herweging op de gespecificeerde vastgelegde kenmerken laat restvertekening bestaan doordat selectie ook niet-vastgelegde beleggingsinteresse en werkelijke fit gebruikt. Richting en omvang van vertekening in een echte campagne hangen af van het selectiemechanisme. Randomisatie met bekende, positieve selectiekansen over het gehele doelkader ondersteunt ontwerpgebaseerde schatting; aanpassing van observationele gegevens vereist expliciete identificatieaannames en toereikende vastgelegde voorspellers.
Schuif horizontaal om de figuur op volledige grootte te lezen. U kunt de figuur ook op volledige grootte openen.
MatchPoint-analyse van de geconstrueerde populatie. Naïeve en herwogen prognoses worden op ieder benaderd cohort geschat en op de resterende beleggers toegepast.
16 Onjuiste gewichten, verouderde gegevens en een zwakkere markt falen verschillend
Tabel 9 past de basisfunctie zonder herschatting toe op een reeks stressscenario's. Ieder geval laat een eigen patroon zien dat op de remedie wijst. Een scorekaart met onjuiste gewichten, hier 45 punten voor geografie, 40 voor investeringsomvang, 15 voor strategie en geen voor beslissingscyclus, daalt tot een AUC van 0.657 en een lift van het hoogste deciel van 1.90. De kalibratiehelling valt terug tot 0.46 en het intercept tot -0.26. Zowel rangschikking als kansen worden aangetast. De remedie is de gewichten opnieuw bekijken, waarvoor uitkomstgegevens nodig zijn.
Verouderde registraties falen minder opvallend. Wanneer de helft van de beslissingscyclusregistraties, 30% van de registraties van investeringsomvang, 15% van strategie en 10% van geografie verouderd is, daalt de AUC tot 0.705 en de lift van het hoogste deciel tot 2.64. Het intercept blijft 0.00, zodat de gemiddelde prognose nog klopt, terwijl de helling daalt tot 0.72: hoge scores krijgen te hoge en lage scores te lage voorspellingen. Figuur 2 toont de afvlakking. De gewichten zijn niet de oorzaak en moeten niet worden gewijzigd. De remedie is de registraties bijwerken. Bij onjuiste gewichten en verouderde registraties samen is de AUC 0.636.
Een zwakkere markt faalt op een derde manier. Wij verlagen de log-odds van een gesprek voor iedere belegger met 0.7 en trekken nieuwe uitkomsten. De scorevolgorde blijft vast en de AUC tegenover de zwakkemarktuitkomsten is 0.766. Zowel de gewijzigde uitkomstkansen als de nieuwe uitkomsttrekking kunnen het verschil met de basis-AUC beïnvloeden. De helling is 0.99. Het intercept is -0.60: de functie voorspelt 12.4% en de markt levert 7.6%, een overschatting met een factor 1.63. De vaste score behoudt in dit geconstrueerde stressgeval onderscheidend vermogen, terwijl de basiskansfunctie het gesprekspercentage overschat. De remedie is het intercept opnieuw schatten op recente uitkomsten; Van Calster en medeauteurs beschrijven dat als de eerste stap bij modelactualisering. [13]
| Rangschikkingsregel | AUC | Lift hoogste deciel | Aandeel bereikt door hoogste kwintiel | Brier-score | Kalibratie-intercept | Kalibratiehelling |
|---|---|---|---|---|---|---|
| Willekeurige volgorde | 0.505 | 1.07 | 20.2% | 0.1095 | n/a | n/a |
| Alleen bekendheid | 0.524 | 1.11 | 21.8% | 0.1094 | n/a | n/a |
| Relaties eerst | 0.550 | 1.61 | 30.6% | 0.1084 | n/a | n/a |
| Onjuiste gewichten en verouderde registraties | 0.636 | 1.89 | 35.4% | 0.1147 | -0.25 | 0.40 |
| Onjuiste gewichten | 0.657 | 1.90 | 38.7% | 0.1124 | -0.26 | 0.46 |
| Verouderde registraties | 0.705 | 2.64 | 42.5% | 0.1033 | 0.00 | 0.72 |
| Gelijke gewichten | 0.732 | 2.80 | 43.7% | 0.1001 | -0.01 | 0.88 |
| Basisscorekaart | 0.744 | 2.89 | 44.6% | 0.0994 | 0.01 | 0.89 |
| Basisscorekaart, zwakkere markt | 0.766 | 3.39 | 51.9% | 0.0680 | -0.60 | 0.99 |
| Basisgewichten, perfecte registraties | 0.782 | 3.37 | 50.1% | 0.0950 | 0.01 | 1.09 |
| Geschatte gewichten plus relatie | 0.758 | 3.05 | 47.9% | 0.0976 | 0.01 | 0.92 |
| Genererende kans (niet haalbaar) | 0.833 | 3.90 | 60.6% | 0.0890 | -0.02 | 0.97 |
MatchPoint-analyse van de geconstrueerde populatie. Modeluitvoer onder expliciete invoer; geen resultaat van een waargenomen cohort. Afgeronde weergave. Scorekaartrijen gebruiken de basiskansfunctie zonder herschatting. Andere rijen, waaronder de rangschikking op genererende kans als vergelijkingsmaatstaf, gebruiken voor de gerapporteerde kansmaten een logistische functie die op hun rangschikkingsinvoer is geschat. De Brier- en kalibratiewaarden van die vergelijkingsmaatstaf zijn dus niet rechtstreeks uit de genererende kansen berekend. n/a duidt kalibratiematen aan die voor uitsluitend op rangschikking gerichte vergelijkingen bewust zijn weggelaten.
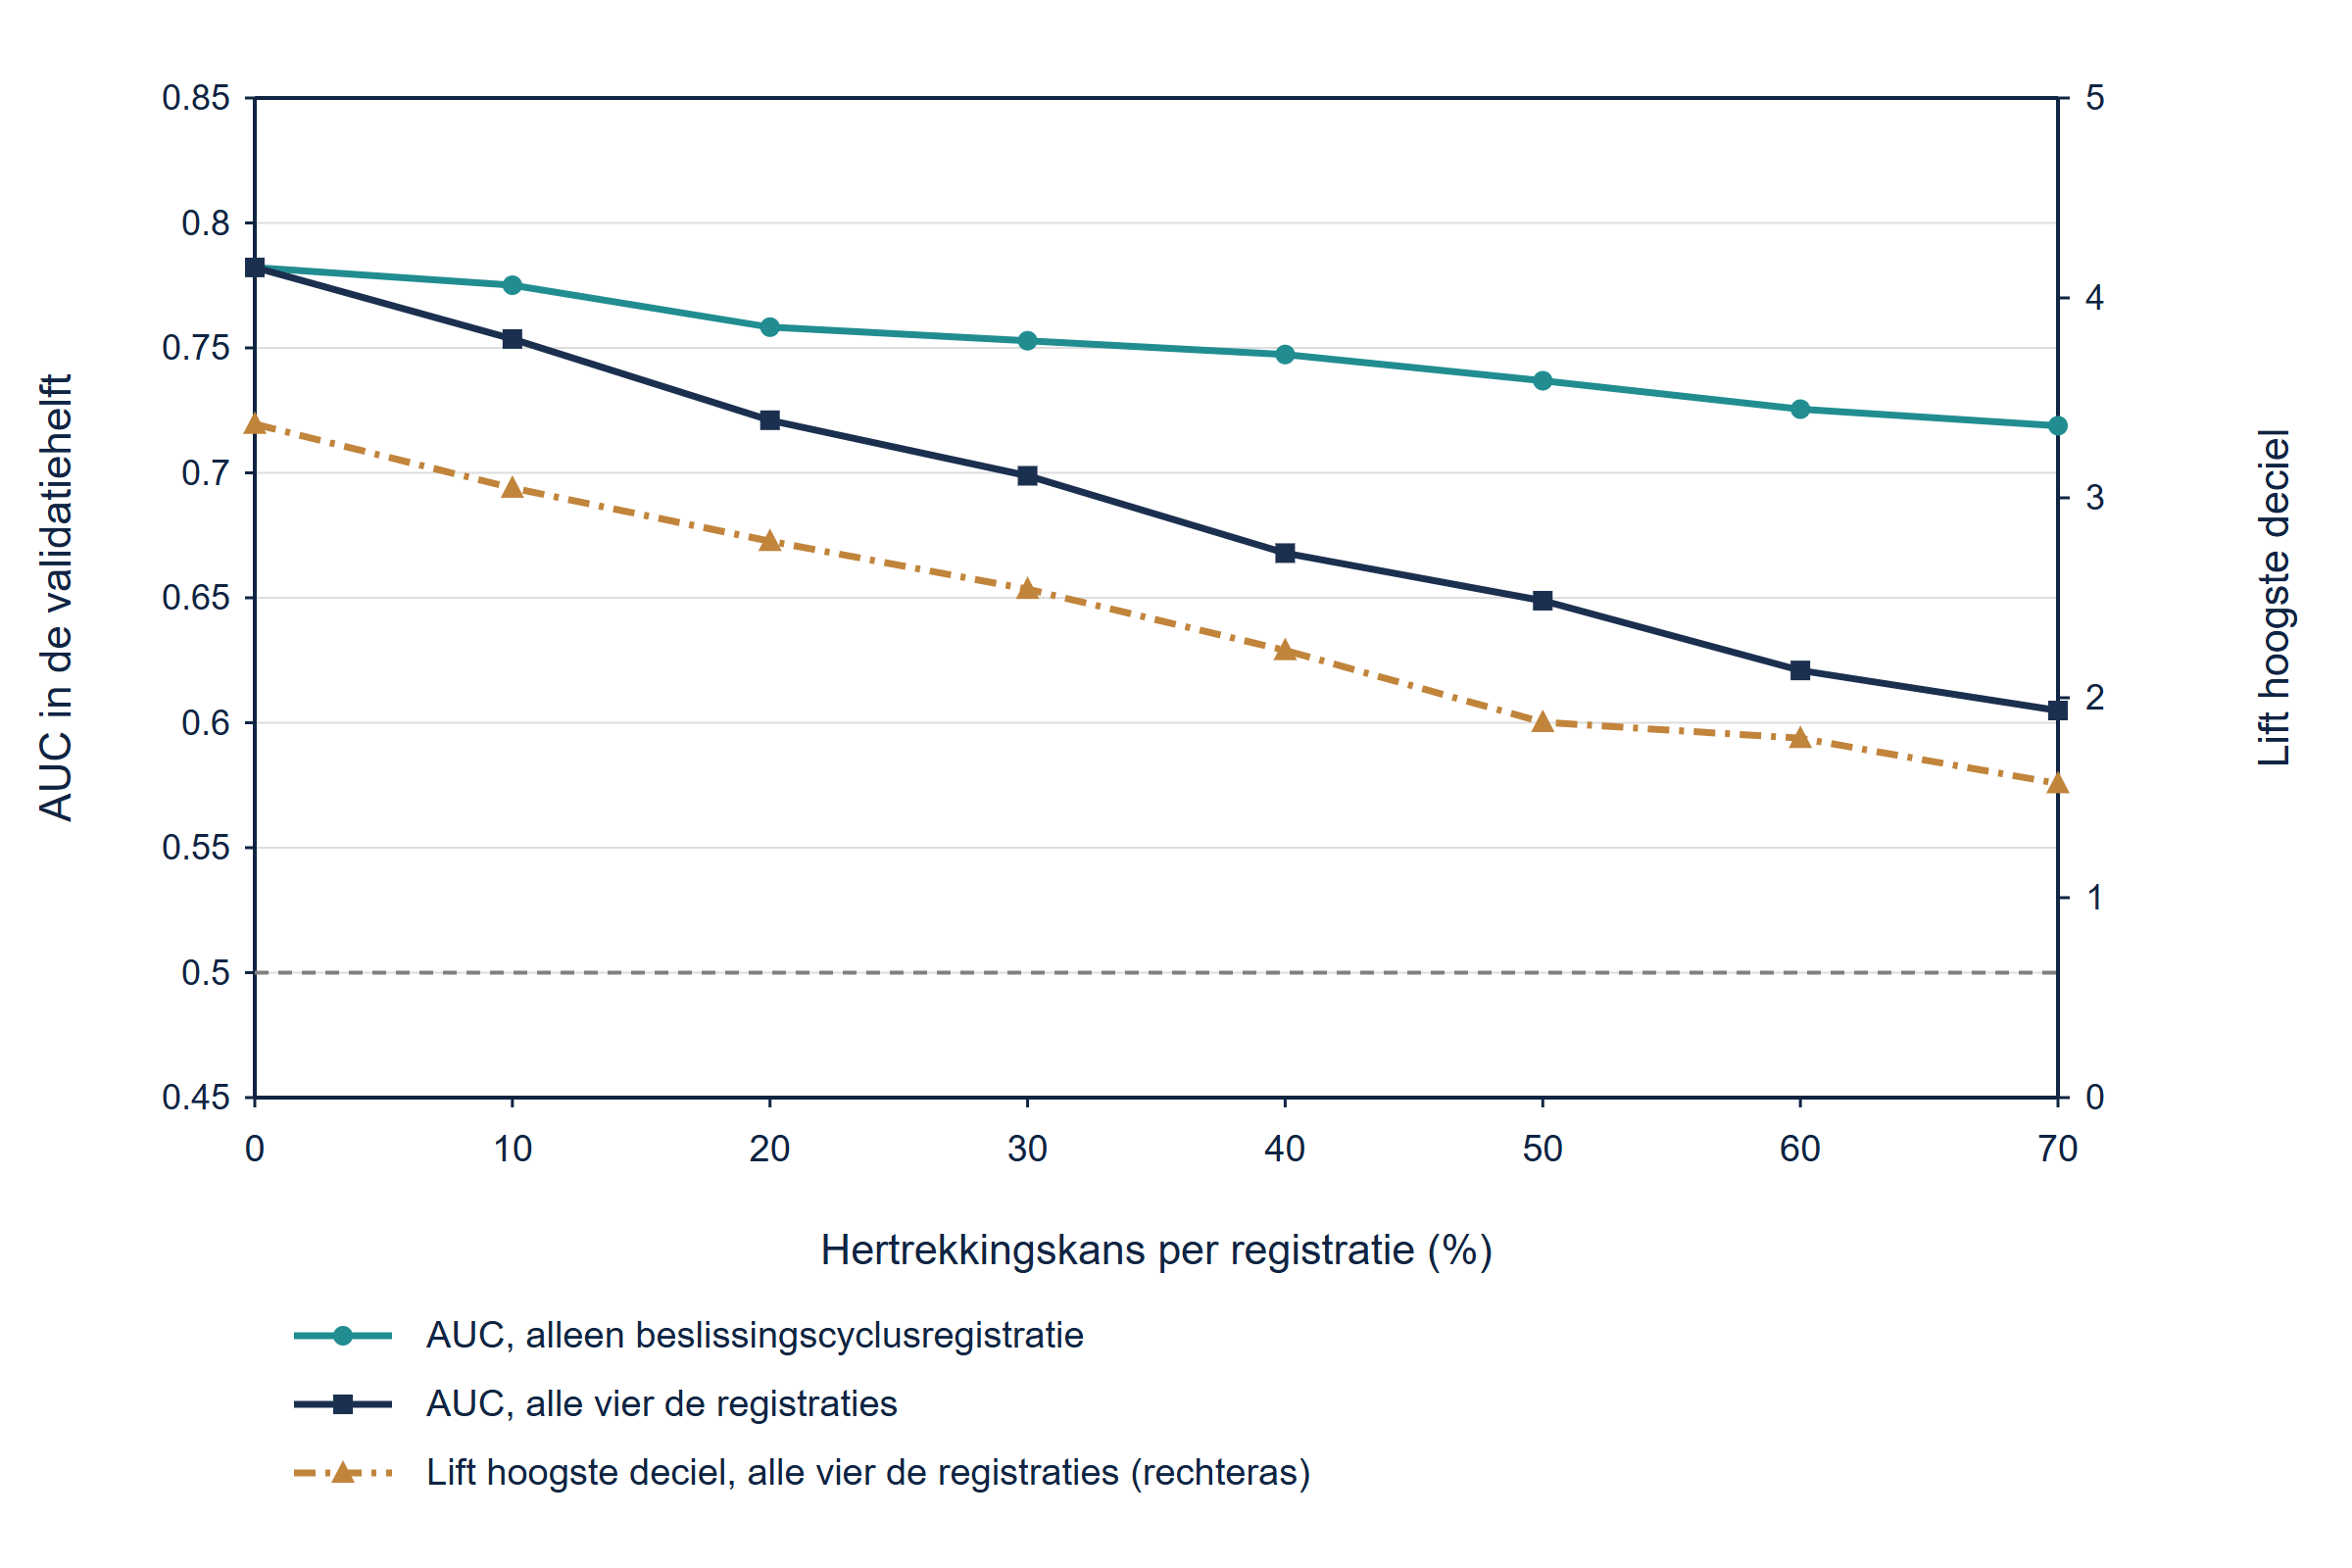
Figuur 6 varieert veroudering continu. Wanneer alle vier de registraties samen verouderen, daalt de AUC van 0.782 bij perfecte gegevens tot 0.699 bij 30% veroudering, 0.649 bij 50% en 0.605 bij 70%; de lift van het hoogste deciel daalt van 3.37 tot 1.88 op het halverwegepunt. Wanneer alleen de beslissingscyclusregistratie veroudert, is de daling gematigder: 0.737 bij 50% en 0.719 bij 70%, omdat structurele fit haar werk blijft doen. Bij een hertrekkingskans van 50% overtreffen de resulterende registraties in deze populatie nog steeds de rangschikkingen op bekendheid en relatie. De planningsprognose verslechtert sneller dan de rangschikking: bij een hertrekkingskans van 50% voor elk van de vier invoervariabelen is de kalibratiehelling 0.52.
Schuif horizontaal om de figuur op volledige grootte te lezen. U kunt de figuur ook op volledige grootte openen.
MatchPoint-analyse van de geconstrueerde populatie, validatiehelft. Verouderde registraties worden opnieuw getrokken uit de populatieaandelen.
17 Steekproefomvang begrenst wat één campagne kan aantonen
Een afzonderlijke kapitaalwerving benadert tientallen of honderden beleggers, geen duizenden. Om te zien wat zo'n campagne kan vaststellen, trekken wij 2 000 willekeurige cohorten van iedere omvang uit de populatie en berekenen voor elk de AUC. Tabel 10 rapporteert de spreiding. Bij 100 willekeurig benaderde beleggers en ongeveer 12.5 gesprekken lopen de middelste 90% van de schattingen van 0.624 tot 0.868. Een team kan met dezelfde scorekaart een AUC van 0.65 of 0.85 waarnemen. Bij 250 benaderingen loopt de bandbreedte van 0.675 tot 0.824; bij 1 000 vernauwt zij tot 0.717 tot 0.787.
Vergelijking (6a) legt vast hoe veroudering is gegenereerd: het geregistreerde niveau is gelijk aan het werkelijke niveau x, behalve wanneer de hertrekkingsindicator d gelijk is aan één. Dat gebeurt met de genoemde kans voor invoervariabele k; dan wordt een niveau x-ster opnieuw uit de populatieaandelen getrokken, dat gelijk kan zijn aan de oorspronkelijke waarde. Vergelijking (6b) gebruikt gepubliceerde richtlijnen voor klinische voorspellingsmodellen als planningsheuristiek: voor een kalibratiecurve zijn ongeveer 200 gevallen met en 200 zonder de uitkomst voorgesteld. [13] Bij het geconstrueerde percentage van 12.5% levert de berekening op basis van verwachte gebeurtenissen ongeveer 1 610 benaderingen op. De gerealiseerde aantallen gebeurtenissen, clustering, modelcomplexiteit en gewenste precisie vergen een studiespecifieke beoordeling; deze berekening is geen universele validatiedrempel. Ook schattingen van intercept en helling hebben onzekerheidsintervallen nodig.
| Willekeurig benaderde beleggers | Verwachte gesprekken | Gemiddelde AUC | Middelste 90% van de AUC-schattingen | Breedte | Basis overtreft onjuiste gewichten | Basis overtreft gelijke gewichten |
|---|---|---|---|---|---|---|
| 100 | 12.5 | 0.752 | 0.624 tot 0.868 | 0.244 | 91% | 75% |
| 250 | 31.2 | 0.752 | 0.675 tot 0.824 | 0.148 | 98% | 88% |
| 500 | 62.4 | 0.752 | 0.700 tot 0.802 | 0.102 | 100% | 94% |
| 1,000 | 124.3 | 0.753 | 0.717 tot 0.787 | 0.070 | 100% | 99% |
| 2,500 | 312.4 | 0.752 | 0.731 tot 0.774 | 0.043 | 100% | 100% |
MatchPoint-analyse van de geconstrueerde populatie. Modeluitvoer onder expliciete invoer; geen resultaat van een waargenomen cohort. Afgeronde weergave. Voor iedere omvang worden 2 000 cohorten zonder teruglegging getrokken.
Vergelijkingen zijn minder veeleisend dan niveaus. De basisscorekaart overtreft de scorekaart met onjuiste gewichten in 91% van de cohorten van 100 en 98% van de cohorten van 250, omdat beide op dezelfde beleggers en uitkomsten worden beoordeeld. Zij overtreft de bijna even goede scorekaart met gelijke gewichten in 88% van de cohorten van 250 en 99% van de cohorten van 1 000. Eén campagne kan laten zien dat een scorekaart beter is dan een slecht alternatief. Zij kan het niveau van onderscheidend vermogen niet vaststellen, geen fijne gewichtsvragen beslechten en geen kalibratiecurve tekenen. Daarvoor zijn samengevoegde cohorten uit meerdere kapitaalwervingen nodig.
18 Reproductie, controles en wat het experiment niet kan aantonen
Het experiment is reproduceerbaar vanuit één bestand. Het model toetst 30 identiteiten en grenstesten en stopt wanneer er een faalt. Een tweede generatie met hetzelfde toevalsstartgetal reproduceert iedere uitkomst exact. De AUC van de basisscorekaart wordt op drie manieren berekend: via rangsom, trapeziumintegratie van de ROC-curve en een gevectoriseerde routine. De drie stemmen tot tien decimalen overeen; een omgekeerde score geeft één min die waarde. Tabel 11 bevat de controles, waaronder de aansluiting van iedere deciel-, band- en rondetabel op de validatietotalen.
| Controle | Verwacht resultaat |
|---|---|
| Vast toevalsstartgetal | Startgetal 1376; een tweede generatie reproduceert iedere uitkomst exact |
| Populatie en helften | 12 000 beleggers; 6 000 ontwikkeling en 6 000 validatie, geen overlap |
| Gegenereerde kansen | In iedere trechterfase strikt tussen nul en één |
| Geneste trechter | Toezeggingen binnen due diligence binnen gesprekken, per belegger en rangschikkingsregel |
| Scorekaartpunten | Iedere scorekaart telt op tot 100; scores liggen tussen 0 en 100 |
| AUC, basisscorekaart | 0.743810 via rangsom, ROC-trapeziumintegratie en de gevectoriseerde routine |
| Omgekeerde score | AUC is gelijk aan één min de basis-AUC |
| Kalibratiefunctie | De gemiddelde geschatte kans is gelijk aan het gesprekspercentage in de ontwikkelhelft |
| Decieltabel | Omvangen en gesprekken sluiten aan; gewogen gemiddelde lift is 1.00; cumulatief aandeel eindigt op 100% |
| Banden en ronden | Rijen sluiten aan op de validatietotalen |
| Vergelijkingsmaatstaven | Willekeurige en bekendheidsrangschikkingen liggen binnen 0.03 van 0.50; genererende kans rangschikt het best |
| Herweging | Inverse-kansgewichten tellen op tot binnen 5% van de populatie |
| Veroudering en precisie | AUC daalt bij veroudering van registraties; schattingen worden nauwkeuriger bij grotere cohorten |
| In model.py getoetste controles | 30 identiteiten en grenstesten geslaagd |
MatchPoint-analyse. Controles zijn vastgelegd als toetsvoorwaarden in model.py; een mislukte toets stopt de opbouw.
De controles stellen vast dat de berekeningen kloppen. Zij stellen niet vast dat de aannames kloppen. De invoervariabelen worden onafhankelijk getrokken, terwijl echte mandaten samenhangen: een belegger met een regionale focus heeft vaak een sectorfocus en een bijpassende investeringsbandbreedte. Het genererende model is additief op de log-oddsschaal, terwijl een werkelijke uitsluiting absoluut kan zijn. Veroudering is willekeurig, terwijl echte registraties in clusters verouderen wanneer een fondsjaargang stopt met investeren. Iedere vereenvoudiging is een begrenzing, opnieuw beschreven in tabel 14.
Eén beperking verdient afzonderlijke vermelding. De uitkomsten zijn gegenereerd door een model waarin de invoervariabelen van de scorekaart ertoe doen. Het experiment kan dus niet aantonen dat mandaatfit beleggersgedrag voorspelt; het neemt dat aan en meet de gevolgen. De bevindingen betreffen de eigenschappen van de toets: hoeveel rangschikkingskracht een documentgebaseerde score kan hebben wanneer zijn uitgangspunt klopt, hoe ieder falen zichtbaar wordt, hoe selectie een historie vertekent en hoe groot een cohort moet zijn. Of het uitgangspunt in een echte markt geldt, is een vraag die alleen waargenomen gegevens kunnen beantwoorden.
19 De bewijsopzet die een cohortstudie met toestemming vereist
Een echte toets vereist vijf eigenschappen, weergegeven in tabel 12. De eerste is toestemming en een rechtsgrond: de contactgegevens en uitkomst van iedere belegger worden voor analyse gebruikt op een grondslag die de belegger en het toepasselijke gegevensbeschermingsregime toestaan; uitkomsten worden samengevoegd zonder een belegger te identificeren. De tweede is een tijdstempel op iedere gebeurtenis, inclusief de scorekaart zelf. Scores moeten vóór de benadering worden vastgezet. Een score die na een gesprek is herzien, is beïnvloed door de uitkomst die hij hoort te voorspellen.
De derde eigenschap is een vastgelegde selectieregel. Voor iedere benadering vermeldt het dossier waarom die belegger is gekozen: op score, relatie, introducerende partij of toeval. De vierde is een gerandomiseerde deelsteekproef. Wij stellen voor een tiende tot een vijfde van de capaciteit van de eerste ronde per loting toe te wijzen. Selectiekansen moeten bekend en positief zijn in het gehele beleggerskader waarop de schattingen betrekking zullen hebben. Wanneer de loting beperkt blijft tot beleggers boven een minimumscore, gelden haar conclusies voor die subgroep; zij schat de respons van uitgesloten namen niet rechtstreeks. Bernstein, Korteweg en Laws randomiseerden informatieverstrekking in plaats van de keuze welke belegger te benaderen. Hun onderzoek is daarom een methodologisch precedent voor randomisatie en geen validatie van deze voorgestelde steekproefopzet. [6]
De vijfde eigenschap is schaal door samenvoeging. Paragraaf 17 laat zien dat één kapitaalwerving geen kalibratiecurve kan dragen. Kapitaalwervingen moeten worden samengevoegd, met de afzonderlijke kapitaalwerving als factor, omdat responspercentages verschillen naar beleggingscategorie, omvang en markt. De toetsen buiten de schattingssteekproef en buiten de schattingsperiode die toezichtsrichtlijnen voor bankmodellen beschrijven zijn rechtstreeks toepasbaar: op eerdere kapitaalwervingen vastgestelde gewichten worden op latere getoetst. [16]
| Ontwerpelement | Vereiste | Beheerste vertekening of fout |
|---|---|---|
| Toestemming en gegevensgrondslag | Gedocumenteerde grondslag voor gebruik van contact- en uitkomstgegevens; samengevoegde, gedeïdentificeerde analyse | Onrechtmatig of niet-herhaalbaar gegevensgebruik |
| Vastgezette scores | Invoer, gewichten en score voorzien van een tijdstempel vóór benadering; latere herzieningen als nieuwe versies bewaard | Kennis achteraf in de voorspeller |
| Uitkomstdefinities | Gekwalificeerd gesprek, due diligence en toezegging vooraf gedefinieerd en gedateerd | Opgeblazen uitkomsten door ruime telling |
| Vastgelegde selectieregel | Reden voor iedere benadering vastgelegd: score, relatie, introducerende partij of loting | Selectie die niet kan worden gemodelleerd |
| Gerandomiseerde deelsteekproef | Een vast capaciteitsaandeel via loting toegewezen aan toelaatbare beleggers | Selectie op niet-vastgelegd oordeel |
| Noemer | Iedere toelaatbare belegger behouden, benaderd of niet, met redenen voor uitsluiting | Overlevingsbias in het cohort |
| Registratiedata | Datum en bron van iedere invoervariabele, vooral de beslissingscyclus | Veroudering aangezien voor onjuiste gewichten |
| Samenvoeging en tijdsplitsing | Kapitaalwervingen samengevoegd met een factor per werving; gewichten getoetst op latere wervingen | Ruis door kleine steekproeven en verandering in de tijd |
| Rapportageset | AUC met interval, lifttabel, kalibratie-intercept en -helling, trechter per band | Selectieve rapportage van één gunstige maatstaf |
Voorgestelde onderzoeksopzet. Een dergelijk cohort is niet beschikbaar en wordt in dit onderzoek niet gerapporteerd. [6, 13, 14, 15, 16]
20 De score rapporteren aan de klant en de beleggingscommissie
Een scorekaart wordt gerapporteerd aan twee doelgroepen met verschillende vragen. De klant vraagt hoeveel gesprekken hij wanneer kan verwachten. De commissie van de belegger vraagt, als zij het proces ooit te zien krijgt, waarom zij is benaderd. De eerste vraag vereist gekalibreerde cijfers met onzekerheid; de tweede een gedocumenteerde basis voor de fit. Wij stellen één rapportagepakket voor dat beide bedient, weergegeven in tabel 13, waarin ieder cijfer als vastgelegd feit, teamoordeel of modelprognose wordt aangeduid.
De prognose moet als bandbreedte worden gepresenteerd en aan haar bewijs worden gekoppeld. In het geconstrueerde geval levert een eerste ronde van 100 benaderingen naar verwachting 36.8 gesprekken op, maar die verwachting berust op een functie die is geschat op een populatie waarin iedereen werd benaderd. Een team waarvan de functie op de eigen historie is geschat moet bij het cijfer de kanttekening uit paragraaf 15 vermelden: de historie is geselecteerd en de prognose voor niet-benaderde namen is waarschijnlijk te hoog. Wanneer de functie niet aan recente uitkomsten is getoetst, moet het pakket dat vermelden en de prognose als aanname presenteren.
Rapportage heeft ook een regelgevingsdimensie wanneer het pakket of de inhoud ervan beleggers bereikt. Onder de Amerikaanse marketingregel moet een materiële claim in een advertentie onderbouwbaar zijn en moeten voordelen met een eerlijke en evenwichtige behandeling van risico's worden gepresenteerd. [7] De uitspraak dat een kans op het mandaat van een belegger is afgestemd is een claim over diens documenten en moet vanuit het dossier onderbouwd kunnen worden. Of een bepaalde mededeling onder de regel valt, is een juridische vraag voor de betrokken onderneming.
| Rapportageonderdeel | Inhoud | Beantwoorde vraag |
|---|---|---|
| Aansluiting van de longlist | Overwogen namen, namen verwijderd bij de juridische toegangstoets, gescoorde en aangehouden namen, met redenen | Of de noemer volledig is |
| Scoreverdeling | Aantal beleggers per scoreband en ronde | Hoeveel capaciteit iedere ronde vereist |
| Prognose en grondslag | Verwachte gesprekken per ronde als bandbreedte, met datum en bron van de omzettingsfunctie | Waarmee de klant mag plannen |
| Realisatie tegenover prognose | Gesprekken, due diligence en toezeggingen per ronde tegenover verwachting | Of de omzettingsfunctie herkalibratie vereist |
| Actualiteit van registraties | Aandeel invoergegevens beoordeeld binnen een genoemde periode, per invoervariabele | Of zwakke resultaten verouderde gegevens weerspiegelen |
| Selectielogboek | Aandeel benaderingen op score, relatie, introducerende partij en loting | Of uitkomsten als bewijs kunnen dienen |
| Afwijkingen van de score | Benaderingen in afwijking van de score, met reden en uitkomst | Of oordeel iets toevoegt aan de score |
| Verstreken tijd | Dagen tussen benadering, gesprek, due diligence en toezegging | Of de cyclusaanname klopt |
Voorgesteld rapportagepakket. De onderdelen zijn te beoordelen resultaten; het onderzoek beweert niet dat een programma ze heeft geproduceerd.
21 Gegevens en AI inzetten om invoer bij te houden, met modelgovernance
Het experiment lokaliseert de waarde van betere gegevens nauwkeurig. Dezelfde gewichten toepassen op perfecte registraties verhoogt de AUC van 0.744 tot 0.782, een winst van 0.038. Gewichten opnieuw schatten en de relatie toevoegen verhoogt haar tot 0.758, een winst van 0.015. In deze populatie is registraties actueel houden meer waard dan gewichten optimaliseren. Die volgorde hangt af van de aangenomen verouderingskansen en zou bij andere invoer verschillen. Zij geeft niettemin aan waar inspanning het eerst moet worden getoetst: bij de data en bronnen van registraties voor beslissingscyclus en investeringsomvang.
Dit is de taak waarvoor taalmodellen en gegevenshulpmiddelen plausibel geschikt zijn: beleidsverklaringen, jaarverslagen, commissiestukken en aankondigingen lezen, genoemde bandbreedtes en limieten extraheren en registraties markeren waarvan de bron is vervangen. De evaluatie moet worden vastgelegd voordat het hulpmiddel wordt ingevoerd. Bruikbare toetsen zijn overeenstemming met een menselijke lezer op een apart gehouden documentenset, het aandeel geëxtraheerde limieten dat niet naar een tekstpassage kan worden herleid en de verandering in verouderde registraties gedurende een kwartaal. Dit zijn voorgestelde criteria. Dit onderzoek rapporteert geen getraind model, geen extractienauwkeurigheid en geen gerealiseerde verbetering.
Een geschat model dat de scorekaart vervangt vereist sterkere controles dan de scorekaart zelf. De richtlijnen voor modelrisico bij banken beschrijven effectieve kritische toetsing als analyse door objectieve partijen met de deskundigheid en positie om verandering te bewerkstelligen. Zij plaatsen generatieve en agentische AI buiten hun toepassingsgebied als nieuw en snel veranderend. [16] Wij ontlenen er naar analogie twee punten aan. Iemand anders dan de auteur van de scorekaart moet de uitkomsten beoordelen. Een hulpmiddel dat documenten leest is een te controleren gegevensbron; de beslissing om een belegger te benaderen blijft bij een bij naam genoemde persoon die verantwoordelijk is voor het juridische kader.
22 Het kader toepassen bij een echte kapitaalwerving of fondsplaatsing
Voor een onderneming of sponsor die kapitaal werft levert het kader een reeks stappen op. Bouw de longlist en pas met juridisch advies de toegangstoets toe. Beoordeel iedere resterende belegger aan de hand van gedateerde documenten en zet de scores vast. Stel de capaciteit van de eerste ronde eerlijk vast in uren van eindverantwoordelijken. Kies de rondegrenzen uit de scoreverdeling, wijs relatiehouders toe aan de namen die de score selecteert en reserveer een gerandomiseerde deelsteekproef. Vergelijk na de eerste ronde gesprekken met de prognose per band voordat de tweede wordt vrijgegeven. De scorekaart bepaalt de volgorde; zij vervangt niet het oordeel of een belegger de juiste eigenaar of kredietverstrekker is.
Voor een beheerder die een fonds werft bij fondsbeleggers verandert de invoer en blijft de logica geldig. Strategiefit wordt afgelezen tegenover de programmabandbreedtes van de kapitaalallocateur, fit van de investeringsomvang tegenover diens limiet voor het aandeel in het fonds en de beoogde fondsomvang, en de beslissingscyclus tegenover het toezeggingstempo en de commissiekalender. [1, 3] De trechter is langer en vervolginvesteringen gedragen zich anders dan nieuwe relaties; bestaande beleggers moeten daarom als een afzonderlijk cohort worden beoordeeld en gerapporteerd. Een lokale voorkeur is bij sommige kapitaalallocateurs een gedocumenteerd patroon. [5] Geografie moet daarom vanuit de kant van de belegger worden beoordeeld.
In de Golfregio vereisen zowel het juridische kader als de cyclus bijzondere aandacht. Een elders gevestigd fonds dat in het Dubai International Financial Centre of Saudi-Arabië wordt aangeboden, bereikt beleggers via de in paragraaf 4 beschreven routes; de route bepaalt wie überhaupt op de lijst mag staan. [10, 11] De Santiago Principles verwachten dat staatsfondsen een beschrijving van hun beleggingsbeleid publiceren, [2] wat structurele beoordeling uit documenten ondersteunt. Hun beslissingscyclus is zelden openbaar. Bij zulke beleggers zal de timingvariabele vaak het onzekere middenniveau scoren en moet de score worden gelezen als een uitspraak over fit.
In alle drie contexten is de beslisregel dezelfde. Orden op score wanneer capaciteit schaars is en gegevens actueel zijn. Werk registraties bij voordat gewichten worden gewijzigd. Kalibreer de prognose opnieuw wanneer de eerste ronde over alle banden van de verwachting afwijkt. Beoordeel selectie in de teamhistorie voordat voor niet-benaderde namen wordt voorspeld. Investeer vroeg in een gerandomiseerde deelsteekproef om een ontwerpgebaseerde vergelijking te verkrijgen binnen het beleggerskader dat de loting bestrijkt.
23 Beperkingen en de volgende beslissing
Het experiment is geconstrueerd en zijn beperkingen volgen uit die constructie. Het bevat één kans en geen concurrentie tussen kansen om de aandacht van dezelfde belegger. Het modelleert de respons van de belegger en niet de kwaliteit van het bedrijf of fonds, die in de praktijk de latere fasen domineert. Het veronderstelt dat een mislukte benadering de relatie niets kost en dat een aangehouden belegger later onder dezelfde voorwaarden kan worden benaderd. Het behandelt iedere belegger als onafhankelijk, hoewel beleggers met elkaar spreken en een ankertoezegging de reactie van de rest verandert.
De statistische resultaten zijn specifiek voor de invoer. Een AUC van 0.744 is wat deze scorekaart in deze populatie bereikt; een andere mix van mandaten, een andere variantie van beleggingsinteresse of een andere verouderingskans zou een ander cijfer opleveren. Het basispercentage van 12.5% en de trechterconversies zijn door de auteur bepaald. Het selectieresultaat hangt af van hoeveel teamoordeel niet is vastgelegd, wat wij per aanname bepalen. Geen cijfer in dit onderzoek mag worden aangehaald als marktconversiepercentage, verwachte uitkomst van een kapitaalwerving of maatstaf voor de toegevoegde waarde van een adviseur. Tabel 14 geeft aan wat iedere begrenzing moet vervangen voordat het kader in een transactie wordt gebruikt.
| Huidige begrenzing | Vereist bewijs voor uitbreiding | Betrokken beslissing |
|---|---|---|
| Geconstrueerde uitkomsten | Cohort met toestemming en tijdstempels volgens de opzet in tabel 12 | Of de scorekaart überhaupt voorspellende waarde heeft |
| Door de auteur vastgestelde gewichten | Voldoende samengevoegde uitkomsten om gewichten te schatten en buiten de schattingsperiode te toetsen | Punten per invoervariabele |
| Aangenomen verouderingskansen | Controle van registratiedata tegenover later bevestigde status | Actualiseringsfrequentie en gegevensbudget |
| Onafhankelijke invoervariabelen | Waargenomen gezamenlijke verdeling van mandaatkenmerken | Omvang van iedere ronde en de aangehouden groep |
| Eén omzettingsfunctie van score naar kans | Recente uitkomsten naar beleggingscategorie, omvang en markt | Klantprognose voor gesprekken en timing |
| Relatie buiten de score | Uitkomsten naar kanaal en introducerende partij | Wie iedere benadering uitvoert |
| Eén kans, geen concurrentie | Registratie van gelijktijdige benaderingen op beleggersniveau | Startmoment |
| Juridisch kader als toegangstoets | Juridisch advies over vehikel, route en beleggerscategorie | Wie op de lijst mag staan |
Voorgestelde uitbreiding van het door de auteur opgezette experiment. Iedere uitbreiding vereist waargenomen bewijs; geen ervan wordt in dit onderzoek als waargenomen resultaat behandeld.
De volgende beslissing gaat daarom evenzeer over bewijs als over benadering. Een team dat beleggers al rangschikt kan de definities van paragraaf 2 overnemen, de scores vastzetten en beginnen vast te leggen waarom iedere benadering plaatsvond. Een gerandomiseerde deelsteekproef gebruikt capaciteit van de eerste ronde; de opportuniteitskosten hangen af van het steekproefkader en de alternatieve rangschikking. Het experiment suggereert wat dat waard is: een evaluatie op waargenomen gegevens moet het selectiemechanisme behandelen voordat zij prognoses voor niet-benaderde namen of vergelijkingen tussen score en oordeel ondersteunt. Dit experiment toont voorspellend gedrag onder zijn expliciete aannames. Binnen de hier onderzochte bronnen hebben wij geen validatie van deze scorekaart op een waargenomen cohort geverifieerd.
Bronnen
- Institutional Limited Partners Association. Due Diligence Questionnaire 2.0. Updated November 2021. Overview and section 4, Investment Strategy. Industry standard questionnaire; not a required document. https://ilpa.org/wp-content/uploads/2021/11/ILPA-DDQ-2.0.pdf
- International Working Group of Sovereign Wealth Funds. Sovereign Wealth Funds: Generally Accepted Principles and Practices (Santiago Principles). October 2008. GAPP 18 and sub-principles 18.1 to 18.3. Voluntary principles. https://www.ifswf.org/sites/default/files/santiagoprinciples_0_0.pdf
- California Public Employees' Retirement System. Investment Policy for Private Equity Program, Investment Committee agenda item 10a, attachment 2, November 2019. Appendix 3, strategy targets, ranges and investment limitations. Dated committee paper showing proposed revisions; not evidence of current limits. https://www.calpers.ca.gov/docs/board-agendas/201911/invest/item10a-02_a.pdf
- Gompers, P., Gornall, W., Kaplan, S. N. and Strebulaev, I. A. How Do Venture Capitalists Make Decisions? NBER Working Paper 22587, September 2016. Survey of 885 venture capitalists at 681 firms; deal sourcing, funnel and selection sections. https://www.nber.org/papers/w22587
- Hochberg, Y. V. and Rauh, J. D. Local Overweighting and Underperformance: Evidence from Limited Partner Private Equity Investments. NBER Working Paper 17122, June 2011. United States limited partners. https://www.nber.org/papers/w17122
- Bernstein, S., Korteweg, A. and Laws, K. Attracting Early Stage Investors: Evidence from a Randomized Field Experiment. Stanford Graduate School of Business Research Paper 3006, 2014. Randomised emails on one online platform. https://ideas.repec.org/p/ecl/stabus/3006.html
- U.S. Securities and Exchange Commission. Investment adviser marketing, 17 CFR 275.206(4)-1. Text as published by the Legal Information Institute, accessed 13 October 2026. https://www.law.cornell.edu/cfr/text/17/275.206(4)-1
- U.S. Securities and Exchange Commission. General Solicitation: Rule 506(c). Exempt offerings resource page, last reviewed or updated 17 March 2026. https://www.sec.gov/resources-small-businesses/exempt-offerings/general-solicitation-rule-506c
- Financial Conduct Authority. FCA Handbook, COBS 4.12B, Promotion of non-mass market investments. Text as accessed 13 October 2026. https://www.handbook.fca.org.uk/handbook/COBS/4/12B.html The original made-rules instrument is reproduced in FCA Policy Statement PS22/10, Appendix 1, FCA 2022/33, August 2022, with the relevant rules effective from February 2023. This is a dated regulatory example; current application requires checking the consolidated Handbook. https://www.fca.org.uk/publication/policy/ps22-10.pdf
- Dubai Financial Services Authority. The DFSA Rulebook, Collective Investment Rules (CIR), version CIR/VER40/01-26. Chapter 15, Marketing of Foreign Funds, guidance and rule 15.1.1A. https://dfsaen.thomsonreuters.com/sites/default/files/net_file_store/DFSA1547_11821_VER400126.pdf
- Capital Market Authority, Kingdom of Saudi Arabia. Investment Funds Regulations, as amended by Board Resolution 1-54-2025 dated 21 May 2025. Part 6, Foreign Funds, Articles 99 to 103. Unofficial English translation; the Arabic text is official. https://cma.gov.sa/en/RulesRegulations/Regulations/Documents/Investment_Funds_Regulations_2025_EN.pdf
- Fawcett, T. An introduction to ROC analysis. Pattern Recognition Letters 27 (2006), 861 to 874. Section on the area under the ROC curve. Copy accessed at https://www2.cs.uh.edu/~acl/cs6397/Doc/2006-PRL-An%20Intro%20to%20ROC%20analysis.pdf
- Van Calster, B., McLernon, D. J., van Smeden, M., Wynants, L. and Steyerberg, E. W. Calibration: the Achilles heel of predictive analytics. BMC Medicine 17, 230 (2019). Open-access text via Europe PMC. https://www.ebi.ac.uk/europepmc/webservices/rest/PMC6912996/fullTextXML
- Heckman, J. J. Sample Selection Bias as a Specification Error (with an Application to the Estimation of Labor Supply Functions). NBER Working Paper 172, March 1977. https://www.nber.org/papers/w0172
- Seaman, S. R. and White, I. R. Review of inverse probability weighting for dealing with missing data. Statistical Methods in Medical Research 22(3), 2013, 278 to 295. Abstract record via Europe PMC. https://www.ebi.ac.uk/europepmc/webservices/rest/search?query=%22Review%20of%20inverse%20probability%20weighting%20for%20dealing%20with%20missing%20data%22&resultType=core&format=json
- Board of Governors of the Federal Reserve System, Federal Deposit Insurance Corporation and Office of the Comptroller of the Currency. Supervisory Guidance on Model Risk Management, attachment to SR Letter 26-2, 17 April 2026. Guidance for banking organisations; not enforceable standards. https://www.federalreserve.gov/supervisionreg/srletters/SR2602a1.pdf
Over de auteur
Chennakeshav (CK) is een bestuurder in corporate finance en investment banking met 25+ jaar wereldwijde ervaring in het initiëren, structureren en uitvoeren van transacties op het gebied van M&A, groeikapitaal en ondernemingsstrategie. Hij heeft waardecreatiemandaten geleid voor oprichters, ondernemingen en fondsen; daarbij verbindt hij het bestuurskamerperspectief met praktische uitvoering en afronding.
Zijn loopbaan omvat Morgan Stanley, HSBC, Lloyds Banking Group, EWEC, portefeuillebedrijven van ADQ en Emirates Growth Fund, met ervaring in TMT, vastgoed, fintech, deeptech, cleantech, infrastructuur en energie. Hij heeft samengewerkt met bestuurders, private-equity- en venturecapitalfondsen, staatsinvesteringsfondsen en family offices om complexe kapitaalrondes en opschalende ondernemingen te financieren, en heeft M&A-due diligence, integratie na overnames en bedrijfstransformaties geleid om waarde te creëren.
Bij Matchpoint Partners is hij Managing Partner en leidt hij de praktijken voor corporate finance, M&A en kapitaalwerving. Hij heeft een MBA van London Business School, een ingenieursdiploma van VTU en volgt een Master of Laws (LLM) aan UCL London.
CK is een actieve mentor voor start-ups bij Techstars, DIFC FinTech Hive, Startup Grind, Founder Institute en IN5, is Entrepreneur Mentor in Residence (EMiR) aan London Business School en jureert de Entrepreneurship World Cup.
https://www.linkedin.com/in/ckadya/
https://www.matchpoint-partners.com/team/ck-adya.html
Disclaimer
Dit artikel maakt deel uit van een doorlopende reeks over de structuur van private en alternatieve markten. De weergegeven opvattingen zijn die van de auteur. Het artikel dient uitsluitend ter informatie, beschrijft marktstructuren in algemene zin en vormt geen beleggings-, juridisch, fiscaal of regelgevingsadvies en geen aanbeveling met betrekking tot effecten, vehikels of tegenpartijen.
