
1 Tester si une mise en relation modifie le résultat avant d’utiliser les relations disponibles en nombre limité
Un fondateur, un directeur financier ou un responsable de levée de capitaux privés, ainsi qu’un gestionnaire de fonds recherchant des capitaux auprès de souscripteurs, disposent chacun d’un nombre limité de mises en relation privilégiées. Chaque mise en relation mobilise une relation qui ne peut être sollicitée qu’un nombre limité de fois. La décision consiste à utiliser cette ressource pour les investisseurs les plus prometteurs, à la conserver pour plus tard ou à solliciter ces investisseurs directement afin de préserver la relation. La réponse dépend d’une grandeur causale : la progression supplémentaire d’une cible donnée attribuable à la mise en relation, par comparaison avec la même cible sollicitée directement.
Les deux publics rencontrent la même structure, avec des contraintes de disponibilité différentes. Une entreprise recherchant du capital de croissance auprès d’une liste définie d’investisseurs peut disposer d’une poignée de relations de haut niveau capables de lui ouvrir l’accès aux plus grandes institutions. Un gestionnaire de fonds recherchant des souscripteurs peut s’appuyer sur un réseau plus large d’anciens investisseurs, de conseillers et d’intermédiaires, mais chaque souscripteur ne peut être sollicité que quelques fois. Dans les deux cas, les mises en relation sont disponibles en nombre limité, les investisseurs les plus importants peuvent aussi être les plus difficiles à atteindre directement, et le responsable doit choisir l’ordre dans lequel il mobilise ses relations.
Les enquêtes montrent que la plupart des opérations de capital-risque proviennent de réseaux et de recommandations. Les praticiens y voient souvent la preuve que les cibles mises en relation progressent davantage. Cette lecture ne suffit pas à trancher la décision, car les intermédiaires choisissent les personnes qu’ils mettent en relation. Le responsable tend à demander une mise en relation lorsque l’investisseur paraît déjà intéressé ; cet intérêt aurait également accru la probabilité d’une réponse en l’absence de mise en relation. Cet article demande si les cibles mises en relation progressent davantage que les cibles sollicitées directement, après prise en compte de l’adéquation de l’investisseur, et quelle part de l’écart visible subsiste après application de l’ajustement habituel. [1, 3]
Cet article ne contient aucun jeu de données observées de prospection. Il construit le cadre à partir de règles issues de sources primaires et de travaux publiés, puis réalise une expérience construite dans laquelle l’effet réel d’une mise en relation est connu, puisque chaque cible possède un résultat sous les deux modes d’approche. L’expérience présente les résultats que produiraient les méthodes de comparaison dans cet univers et précise qu’elle ne rapporte aucun résultat observé. Une dernière section définit l’étude réalisée avec les consentements nécessaires qui permettrait de la remplacer.
2 Définir la progression par des étapes datées, rapportées à toutes les cibles sollicitées
Le résultat doit être défini avant toute comparaison. Nous retenons quatre étapes qu’un responsable de levée peut consigner à partir de sa correspondance et de son calendrier : une réponse substantielle, un premier entretien qualifié, l’entrée en audit préalable et un engagement signé. Une réponse est un écrit qui traite de la proposition ; un accusé de réception automatique ne suffit pas. Un entretien qualifié est un entretien effectivement tenu avec une personne capable de faire avancer le mandat, à l’issue duquel l’investisseur confirme que celui-ci relève de son périmètre déclaré. L’audit préalable commence lorsque l’investisseur demande ou reçoit des informations confidentielles. Un engagement signé est un engagement d’investissement ou de financement conclu et juridiquement contraignant ; les conditions suspensives et l’état du financement sont enregistrés séparément. Une lettre d’intention indicative ou non contraignante est exclue. Le tableau 1 présente les étapes, leurs délais et les justificatifs correspondants.
Chaque étape est assortie d’un délai courant à partir du premier contact : 30 jours pour une réponse, 90 jours pour un entretien qualifié, 180 jours pour l’audit préalable et 365 jours pour un engagement signé. Ces délais sont des choix de conception fixés avant la première approche et identiques dans chaque groupe. À chaque étape, le dénominateur est le nombre de cibles sollicitées ; il ne se limite pas aux cibles ayant atteint l’étape précédente. Comparer des taux conditionnels, par exemple les entretiens parmi les cibles ayant répondu, mêle l’effet de la mise en relation à une modification de la composition des répondants. La section 11 mesure cette distorsion.
| Étape | Événement comptabilisé | Délai depuis le premier contact | Justificatif enregistré |
|---|---|---|---|
| Réponse | Réponse écrite traitant de la proposition | 30 jours | Message daté ou compte rendu d’appel |
| Entretien qualifié | Entretien tenu avec une personne capable de faire avancer le mandat, dont le périmètre est confirmé | 90 jours | Entrée d’agenda et compte rendu d’entretien |
| Audit préalable | L’investisseur demande ou reçoit des informations confidentielles | 180 jours | Journal d’accès à la salle de données ou liste des demandes |
| Engagement signé | Engagement d’investissement ou de financement conclu et juridiquement contraignant ; lettres d’intention indicatives ou non contraignantes exclues | 365 jours | Engagement contraignant conclu, date, conditions suspensives et état du financement enregistré séparément |
| Dénominateur | Toutes les cibles sollicitées, quel que soit le groupe | Identique pour toutes les étapes | Journal des approches indiquant le groupe et la date |
Registre proposé. Les délais sont des choix de conception fixés avant la première approche ; ils ne constituent pas des résultats. Les rubriques décrivent les informations à recueillir.
La simulation impose des étapes emboîtées : la signature exige un audit préalable, lequel exige un entretien. Cette convention de modélisation est choisie pour l’expérience. Les dossiers réels nécessitent une règle préétablie pour les cas qui sautent une étape. Le modèle génère des indicateurs d’étape sans date d’événement ni censure ; les délais de 30, 90, 180 et 365 jours appartiennent à l’étude opérationnelle proposée. Les comparaisons nécessitent la même durée de suivi écoulée pour chaque cible. Une date commune de fin de campagne peut laisser les contacts plus tardifs avec un suivi incomplet ; les analyses devraient donc utiliser des cohortes arrivées au terme du suivi ou une méthode de censure explicitement définie.
3 Classer chaque approche selon la personne qui recommande, le destinataire et ce que reçoit l’investisseur
Le terme de mise en relation recouvre plusieurs actes distincts ; une étude qui les mélange ne peut pas être interprétée. Nous distinguons cinq approches selon ce que reçoit l’investisseur, comme les travaux sur les recommandations distinguent l’information de l’accès. [3] Une approche directe atteint l’investisseur sans tiers. Une mise en relation par transmission fait passer les documents du responsable par un tiers qui n’ajoute aucun avis. Une mise en relation assortie d’une recommandation comprend une déclaration du tiers sur la relation et son avis sur la proposition. Une approche conjointe fait participer le tiers au premier entretien. Une demande entrante est initiée par l’investisseur et reste hors de la comparaison. Le tableau 2 présente les définitions.
| Approche | Personne qui recommande | Ce que reçoit l’investisseur | Justificatif enregistré |
|---|---|---|---|
| Directe | Aucun tiers | Message propre du responsable de la levée | Message et date d’envoi |
| Mise en relation par transmission | Un tiers transmet les documents | Message du responsable transmis par un tiers | Date de transmission et identité de l’intermédiaire |
| Mise en relation assortie d’une recommandation | Un tiers décrit la relation et donne son avis | Note du tiers accompagnant la proposition | Note de l’intermédiaire et description du lien |
| Approche conjointe | Un tiers participe au premier entretien | Présence du tiers | Liste des participants à l’entretien |
| Entrante | L’investisseur prend l’initiative | Demande propre de l’investisseur | Exclue de la comparaison |
Définitions proposées. Il s’agit de catégories analytiques à fixer dans le protocole de l’étude ; elles ne constituent pas des constats sur un marché.
Cette classification distingue aussi deux mécanismes qu’un écart unique confond. Une mise en relation assortie d’une recommandation peut transmettre des informations sur le responsable de la levée, comme une recommandation sur le marché du travail, et donner accès à un décideur qui n’aurait autrement pas lu le message. L’expérience présentée ensuite ne les distingue pas ; elle traite la mise en relation comme un ensemble unique doté d’un effet spécifié à chaque étape. Une étude réelle devrait enregistrer la description du lien afin de pouvoir dissocier ces mécanismes ultérieurement.
4 Les enquêtes montrent la prépondérance des réseaux dans l’origination des opérations, sans établir que les mises en relation causent la progression
La description la plus proche de la manière dont les investisseurs privés trouvent des opérations provient d’une enquête auprès de sociétés de capital-risque. Le document de travail de Gompers, Gornall, Kaplan et Strebulaev recense 885 répondants appartenant à 681 sociétés. Plus de 30 % des opérations provenaient de réseaux professionnels, 20 % supplémentaires étaient recommandées par d’autres investisseurs et 8 % par des sociétés en portefeuille. Près de 30 % étaient identifiées à l’initiative de l’investisseur et seulement environ 10 % provenaient de sollicitations entrantes des dirigeants d’entreprise. Le même document indique que les sociétés examinent environ 100 opportunités pour chaque opération conclue et qu’une opportunité sur quatre conduit à un entretien avec la direction. [1]
Ces chiffres d’origination des opérations sont déclarés par les sociétés de capital-risque elles-mêmes. Ils motivent un cadre de résultats par étapes ; ils ne calibrent pas les taux choisis dans cet article et n’estiment pas l’effet d’une mise en relation. L’enquête ne porte pas sur un échantillon d’investisseurs du Golfe. Son tableau 5 indique que les opérations entrantes provenant des dirigeants représentent 12 % chez les investisseurs en phase initiale et 7 % chez ceux intervenant à des stades plus avancés. [1]
Shane et Cable ont étudié l’influence des liens directs et indirects entre 50 entreprises de haute technologie et 202 investisseurs d’amorçage sur les décisions de financement. Ils indiquent que ces liens influencent les entreprises financées par le transfert d’informations. Nous avons lu uniquement le résumé, le texte intégral n’étant pas librement accessible. Il étaye l’idée que les liens comptent pour le financement dans un échantillon d’investisseurs d’amorçage. Le résumé ne donne aucune taille d’effet et ne précise pas si la sélection est séparée de l’effet du lien ; l’étude concerne l’investissement d’amorçage, plutôt que le placement de parts de fonds ou les levées à des stades plus avancés. [2] Ces sources justifient le cadre comme un ensemble de questions. Aucune ne fournit l’effet d’une mise en relation.
5 Les expériences de terrain montrent que les recommandations transmettent des informations et que la sélection des personnes recommandées est importante
Pallais et Sands ont mené trois expériences de terrain sur un marché du travail en ligne. Ils indiquent que les recommandations apportent des informations sur la performance et la persévérance au-delà des caractéristiques observées, et que les travailleurs recommandés ont particulièrement bien réussi lorsqu’ils travaillaient avec les personnes les ayant recommandés. Leur expérience sur l’influence des pairs n’a pas étayé le mécanisme proposé d’un effort induit par la personne qui recommande. Les résultats concernent le travail et le recrutement. [3]
Dans le dispositif de recrutement, 68 % des travailleurs recommandés ont candidaté au poste, contre 6 % des travailleurs non recommandés. Cette sélection compte lorsque la performance n’est observable que chez les personnes recrutées. Le résultat illustre un problème de mesure sur un marché de recommandations ; il ne fournit aucun effet sur l’engagement des investisseurs ou la levée de capitaux. [3]
L’étude la plus proche concernant les investisseurs est une expérience de terrain randomisée sur des courriels de présentation non sollicités. Gornall et Strebulaev ont envoyé 80 000 courriels présentant des jeunes entreprises fictives à 28 000 investisseurs en capital-risque et investisseurs providentiels. Ils indiquent que les entrepreneuses ont reçu 9 % de réponses intéressées de plus que les entrepreneurs présentant des projets identiques. Les auteurs concluent que les investisseurs n’ont pas pratiqué de discrimination lors de l’évaluation de ces courriels non sollicités et suggèrent que les recherches futures sur les biais des investisseurs portent sur les réseaux et les interactions en personne. Nous avons lu le résumé publié et le texte intégral de la version d’août 2019 du document de travail, qui précise que les courriels portent sur la toute première étape du processus d’investissement. L’étude montre qu’une prospection à froid peut être randomisée à grande échelle et qu’elle s’est arrêtée à la première réponse. [4] Une seconde étude randomisée de Zhang, que nous avons lue en partie, a envoyé des courriels de présentation à plus de 17 000 investisseurs en capital-risque. Elle indique un taux de réponse à ces courriels de 1,5 % en 2020, contre les 6 % qu’elle attribue à Gornall et Strebulaev en décembre 2018. [5] Ces sources étayent la faisabilité d’une composante randomisée. Elles ne donnent aucune estimation de l’effet d’une mise en relation.
6 La prise en compte de l’adéquation laisse subsister des facteurs de confusion lorsque les intermédiaires choisissent les mises en relation
L’ajustement selon l’adéquation enregistrée de l’investisseur est la correction naturelle, et celle que désigne la question de recherche. Les méthodes de score de propension permettent à une étude observationnelle de reproduire certaines caractéristiques d’une étude randomisée en équilibrant les caractéristiques initiales observées entre les personnes traitées et non traitées. La présentation de ces méthodes par Austin précise la condition dont elles dépendent : l’affectation au traitement doit satisfaire l’hypothèse d’ignorabilité forte, également décrite comme l’hypothèse selon laquelle toutes les variables influençant à la fois l’affectation et le résultat ont été mesurées. Elle indique aussi qu’une différence standardisée inférieure à 0,1 est considérée, selon une convention, comme un déséquilibre négligeable. [6]
Pour les mises en relation, cette hypothèse est exigeante. Un intermédiaire sait des choses absentes des dossiers du responsable : si l’investisseur déploie actuellement des capitaux, si une conversation récente s’est bien déroulée et si le contact au sein de la relation joindrait un avis personnel. Nous appelons cela la proximité relationnelle latente. Elle influe sur le choix des cibles mises en relation et sur la probabilité d’une réponse sans mise en relation. L’équilibre des variables enregistrées ne peut pas la révéler. La source établit la condition d’un ajustement valide et une convention d’équilibrage. Elle ne dit pas si cette condition est satisfaite pour une campagne de prospection donnée ; il s’agit d’un exposé statistique, et non d’une étude d’investisseurs. [6]
VanderWeele et Ding définissent la valeur E par rapport à l’hypothèse nulle comme la force conjointe minimale des associations avec un facteur de confusion, sur l’échelle des rapports de risques et conditionnellement aux covariables mesurées, suffisante pour ramener une association à l’hypothèse nulle. Leur cadre traite aussi de rapports de risques cibles spécifiés et non nuls. Ces calculs de sensibilité quantifient les forces de confusion nécessaires ; ils n’estiment pas les facteurs de confusion réellement présents. [7]
7 Le droit des valeurs mobilières, la rémunération des intermédiaires et la protection des données délimitent tout test
Une mise en relation peut relever des règles sur les valeurs mobilières et les promotions financières. Les interprétations du personnel de la SEC décrivent une relation substantielle préexistante comme l’une des voies permettant d’éviter la sollicitation générale pour les offres concernées relevant de la Regulation D. Elles distinguent l’évaluation de la compétence financière à partir d’informations suffisantes d’un simple exercice de cases à cocher, examinent à quel moment une relation doit précéder une offre ou la participation d’un intermédiaire et traitent les mises en relation informelles dans des réseaux d’investisseurs providentiels au cas par cas. Les interprétations citées n’autorisent pas une approche particulière et ne règlent pas les obligations d’enregistrement des intermédiaires. [8]
Au Royaume-Uni, l’article 15 du Financial Promotion Order vise les mises en relation avec des personnes autorisées ou exemptées qui remplissent les conditions requises. Il comporte une restriction relative à la relation, interdit toute rémunération provenant d’une personne autre que le destinataire et impose une condition relative au conseil, qui couvre aussi le conseil décliné avec recommandation de consulter une personne autorisée. Le paragraphe 1A exclut certaines catégories d’activités. Une mise en relation rémunérée par son destinataire n’est donc pas exclue par la seule condition de rémunération ; chaque condition applicable reste à vérifier. Dans le DIFC, l’alerte de 2023 de la DFSA décrit les interdictions relatives aux services financiers et aux promotions financières, y compris les communications par courriel, téléphone et entretien. Les exceptions du Rulebook et les exigences de la SCA ou de la CMA sont hors du périmètre examiné. [9, 14]
| Question | Source et statut | Ce qu’elle établit | Ce qui reste à vérifier |
|---|---|---|---|
| La relation précède-t-elle l’offre ? | Interprétations du personnel de la SEC, 2015 et 2025 [8] | Une relation substantielle préexistante est l’une des voies permettant d’éviter la sollicitation générale | Règles de commercialisation dans le Golfe et offres hors des États-Unis |
| L’intermédiaire est-il rémunéré ? | Financial Promotion Order britannique, article 15 [9] | Une rémunération provenant d’une personne autre que le destinataire fait échouer la condition de rémunération ; les autres conditions et exclusions d’activités s’appliquent aussi | Éligibilité complète à l’exemption et autres régimes réglementaires applicables |
| L’approche constitue-t-elle une promotion dans le DIFC ou depuis celui-ci ? | Alerte de la DFSA relative à l’article 41A de la Regulatory Law 2004 [14] | Une personne non autorisée ne peut effectuer de promotion financière, notamment par courriel, appel ou entretien, sauf dans les cas permis par les règles | Exemptions du Rulebook et règles de la SCA et de la CMA, non examinées |
| Le consentement est-il valable ? | Règlement général de l’Union européenne sur la protection des données, article 7 [10] | Consentement démontrable, distinct et révocable | Pertinence du consentement comme fondement pour une liste donnée |
| La norme de l’ADGM est-elle satisfaite ? | Orientations de l’Office de protection des données de l’ADGM, mai 2025 [11] | Le consentement doit être libre, spécifique, éclairé et consigné | Texte des Regulations non examiné |
| La loi fédérale des Émirats arabes unis est-elle applicable ? | Résumé du portail gouvernemental des Émirats arabes unis [12] | Le traitement sans consentement est interdit, sous réserve des exceptions indiquées | Texte fédéral intégral et droit du DIFC non examinés |
| Que dit l’investisseur des prises de contact non sollicitées ? | Page de contact de Mubadala [13] | Avertissement contre la fraude ; les demandes non sollicitées de financement de projets ne sont pas acceptées | Modalités d’évaluation des propositions d’investissement ou des mises en relation |
Questions de revue proposées. Statut des sources : interprétations administratives, texte réglementaire britannique, règlement, orientations d’un régulateur et alerte réglementaire, comme indiqué dans le texte. Aucune ne constitue un constat sur une juridiction du Golfe non examinée. [8, 9, 10, 11, 12, 13, 14]
Pour traiter les données, le responsable du traitement doit disposer d’une base juridique applicable. Lorsque le consentement est utilisé, l’article 7 du RGPD exige un consentement démontrable, distinct et révocable ; l’article 21 traite de l’opposition à la prospection directe. Les orientations de l’ADGM expliquent six bases juridiques et excluent le silence ou les cases précochées comme formes de consentement. Le portail gouvernemental des Émirats arabes unis résume les exigences fédérales de consentement et leurs exceptions ; cet article s’appuie sur ce résumé plutôt que sur le texte fédéral intégral. La page de contact de Mubadala avertit séparément des demandes de financement non sollicitées et des comportements inappropriés. Cet avertissement ne décrit pas l’évaluation des propositions d’investissement. [10, 11, 12, 13]
8 Énoncer le paramètre causal visé et l’identité de sélection avant toute estimation
La grandeur à estimer est l’effet moyen d’une mise en relation sur la proportion de cibles sollicitées qui atteignent chaque étape. Pour une cible i et une étape k, écrivons l’indicateur d’atteinte de l’étape sous chacun des deux modes d’approche. Leur différence moyenne est l’effet recherché. La différence observable dans une campagne est l’écart entre les groupes mis en relation et sollicités directement ; il s’agit d’une autre grandeur. L’équation 1b montre exactement leur différence, et le modèle vérifie cette identité à chaque étape.
Dans les équations, Y(i,k,a) vaut un si la cible i atteint l’étape k lorsqu’elle est sollicitée selon la méthode a ; a vaut un pour une mise en relation et zéro pour une approche directe, tandis que A(i) désigne l’approche effectivement utilisée. La première équation définit l’effet moyen tau(k) sur toutes les cibles éligibles. La seconde décompose l’écart observé Delta(k) entre l’effet sur les cibles effectivement mises en relation, appelé effet sur les traités, et, entre accolades, un terme de sélection comparant ce que les groupes mis en relation et sollicités directement auraient obtenu sans aucune mise en relation. Un terme de sélection positif signifie que le groupe mis en relation avait déjà davantage de chances de progresser.
Deux propriétés en découlent. Premièrement, le terme de sélection n’est pas une erreur d’échantillonnage. Il ne diminue pas lorsque la campagne grandit ; un échantillon plus grand rend donc l’écart biaisé plus précis sans le rendre plus exact. Deuxièmement, l’effet sur les traités et l’effet moyen peuvent différer lorsque les intermédiaires choisissent les cibles pour lesquelles la mise en relation fonctionne le mieux ; un résultat devrait donc toujours préciser lequel il rapporte. La composante randomisée présentée ensuite estime l’effet moyen parmi les cibles éligibles.
Le paramètre causal visé est défini pour les cibles éligibles, c’est-à-dire celles pour lesquelles un chemin crédible de mise en relation existe avant l’approche. Les cibles dépourvues d’un tel chemin sont hors de la comparaison des traitements de cette étude. L’éligibilité devrait être consignée avant l’affectation ; cette seule restriction ne supprime pas les différences entre les réseaux des responsables de levée et n’identifie pas un effet. Généraliser le résultat de la composante à toutes les cibles éligibles exige une sélection aléatoire dans cette composante ou un ajustement de transportabilité justifié, en plus de l’affectation aléatoire en son sein.
9 Construire une population dans laquelle l’effet réel d’une mise en relation est connu
La population comprend 400 000 cibles éligibles, pour lesquelles un chemin crédible de mise en relation existe. Chacune possède un score d’adéquation et un indicateur de catégorie enregistrés ; 30 % appartiennent à la première catégorie, plus difficile à atteindre. Chacune possède aussi une valeur de proximité relationnelle jamais enregistrée, corrélée à 0,3 avec l’adéquation enregistrée, et un indice enregistré d’engagement antérieur dont le coefficient de chargement sur cette proximité vaut 0,6. Cet indice représente une information que le responsable pourrait consigner avant l’approche : l’investisseur a-t-il ouvert ou répondu à une correspondance antérieure de l’entreprise ? Le tableau 4 énumère toutes les données d’entrée.
| Donnée d’entrée | Valeur | Statut |
|---|---|---|
| Cibles éligibles dans la population construite | 400 000 | Construite |
| Taux de chaque étape sous l’approche directe | 9 % de réponses ; 55 % d’entretiens parmi les réponses ; 30 % d’audits préalables parmi les entretiens ; 18 % d’engagements signés parmi les audits préalables | Choisi pour l’expérience |
| Effet réel d’une mise en relation sur les log-cotes | 1,50 pour la réponse ; 0,20 pour l’entretien ; 0,30 pour l’audit préalable ; 0,15 pour l’engagement signé | Choisi pour l’expérience |
| Proximité relationnelle latente : corrélation avec l’adéquation enregistrée | 0,3 ; loi normale centrée réduite, jamais enregistrée | Choisie pour l’expérience |
| Indice d’engagement antérieur, indicateur indirect enregistré | Coefficient de chargement de 0,6 sur la proximité relationnelle | Choisi pour l’expérience |
| Choix des mises en relation par le responsable, en log-cotes | 0,5 pour l’adéquation ; 0,5 pour la catégorie 1 ; 0,9 pour la proximité relationnelle latente ; 30 % de cibles mises en relation | Choisi pour l’expérience |
| Composante randomisée ; répétitions | 25 % d’une campagne ; 600 campagnes par taille | Choix de conception |
| Paramètres des scénarios de tension | Proximité relationnelle à 1,8 ; gains augmentant de 0,5 par unité de proximité ; log-cotes de réponse diminuées de 0,8 ; 15 % et 10 % de classifications erronées | Choisis pour l’expérience |
Analyse MatchPoint de la population construite. Résultat du modèle avec les paramètres indiqués ; aucun résultat observé. Les effets sur les log-cotes s’appliquent à chaque étape conditionnellement à la précédente.
Ici, F(i) est l’adéquation enregistrée, T(i) l’indicateur de catégorie et W(i) la proximité relationnelle latente ; le responsable choisit une mise en relation avec la probabilité logistique de l’équation 2a. L’ordonnée à l’origine a(0) est déterminée de sorte que 30 % des cibles soient mises en relation ; beta(F) et beta(T) valent tous deux 0,5, et lambda, fixé à 0,9 dans le scénario de base, représente le poids accordé par le responsable à la proximité qu’il perçoit sans pouvoir l’enregistrer. Dans l’équation 2b, les c(k) sont des ordonnées à l’origine déterminées pour que les taux des étapes sous approche directe égalent 9 %, 55 %, 30 % et 18 % ; les termes b sont des coefficients propres aux étapes, et theta(k) est l’effet réel d’une mise en relation sur les log-cotes de l’étape k, fixé à 1,50, 0,20, 0,30 et 0,15.
Les deux ensembles de résultats potentiels sont générés à partir des mêmes tirages aléatoires ; leur différence moyenne est donc connue pour chaque population finie générée. Ce contraste approche l’espérance sous la distribution génératrice commune ; les scénarios et points de comparaison générés indépendamment comportent une variation de Monte-Carlo. Toutes ces valeurs sont choisies pour l’expérience. Les taux directs sont fixés pour que l’entonnoir se resserre de la manière décrite par l’enquête, sans être calibrés sur celle-ci. La taille de l’effet de mise en relation est une hypothèse choisie assez grande pour être visible ; ce n’est pas une estimation. Le sens et l’ampleur des biais rapportés décrivent les mécanismes spécifiés et les paramètres testés. La proximité relationnelle latente varie sur la grille annoncée ; l’expérience n’établit pas ces conclusions pour toute taille d’effet ou tout mécanisme d’affectation. [1]
10 Dans la population construite, une mise en relation accroît la progression à chaque étape, avec des effets proportionnellement plus élevés aux étapes tardives
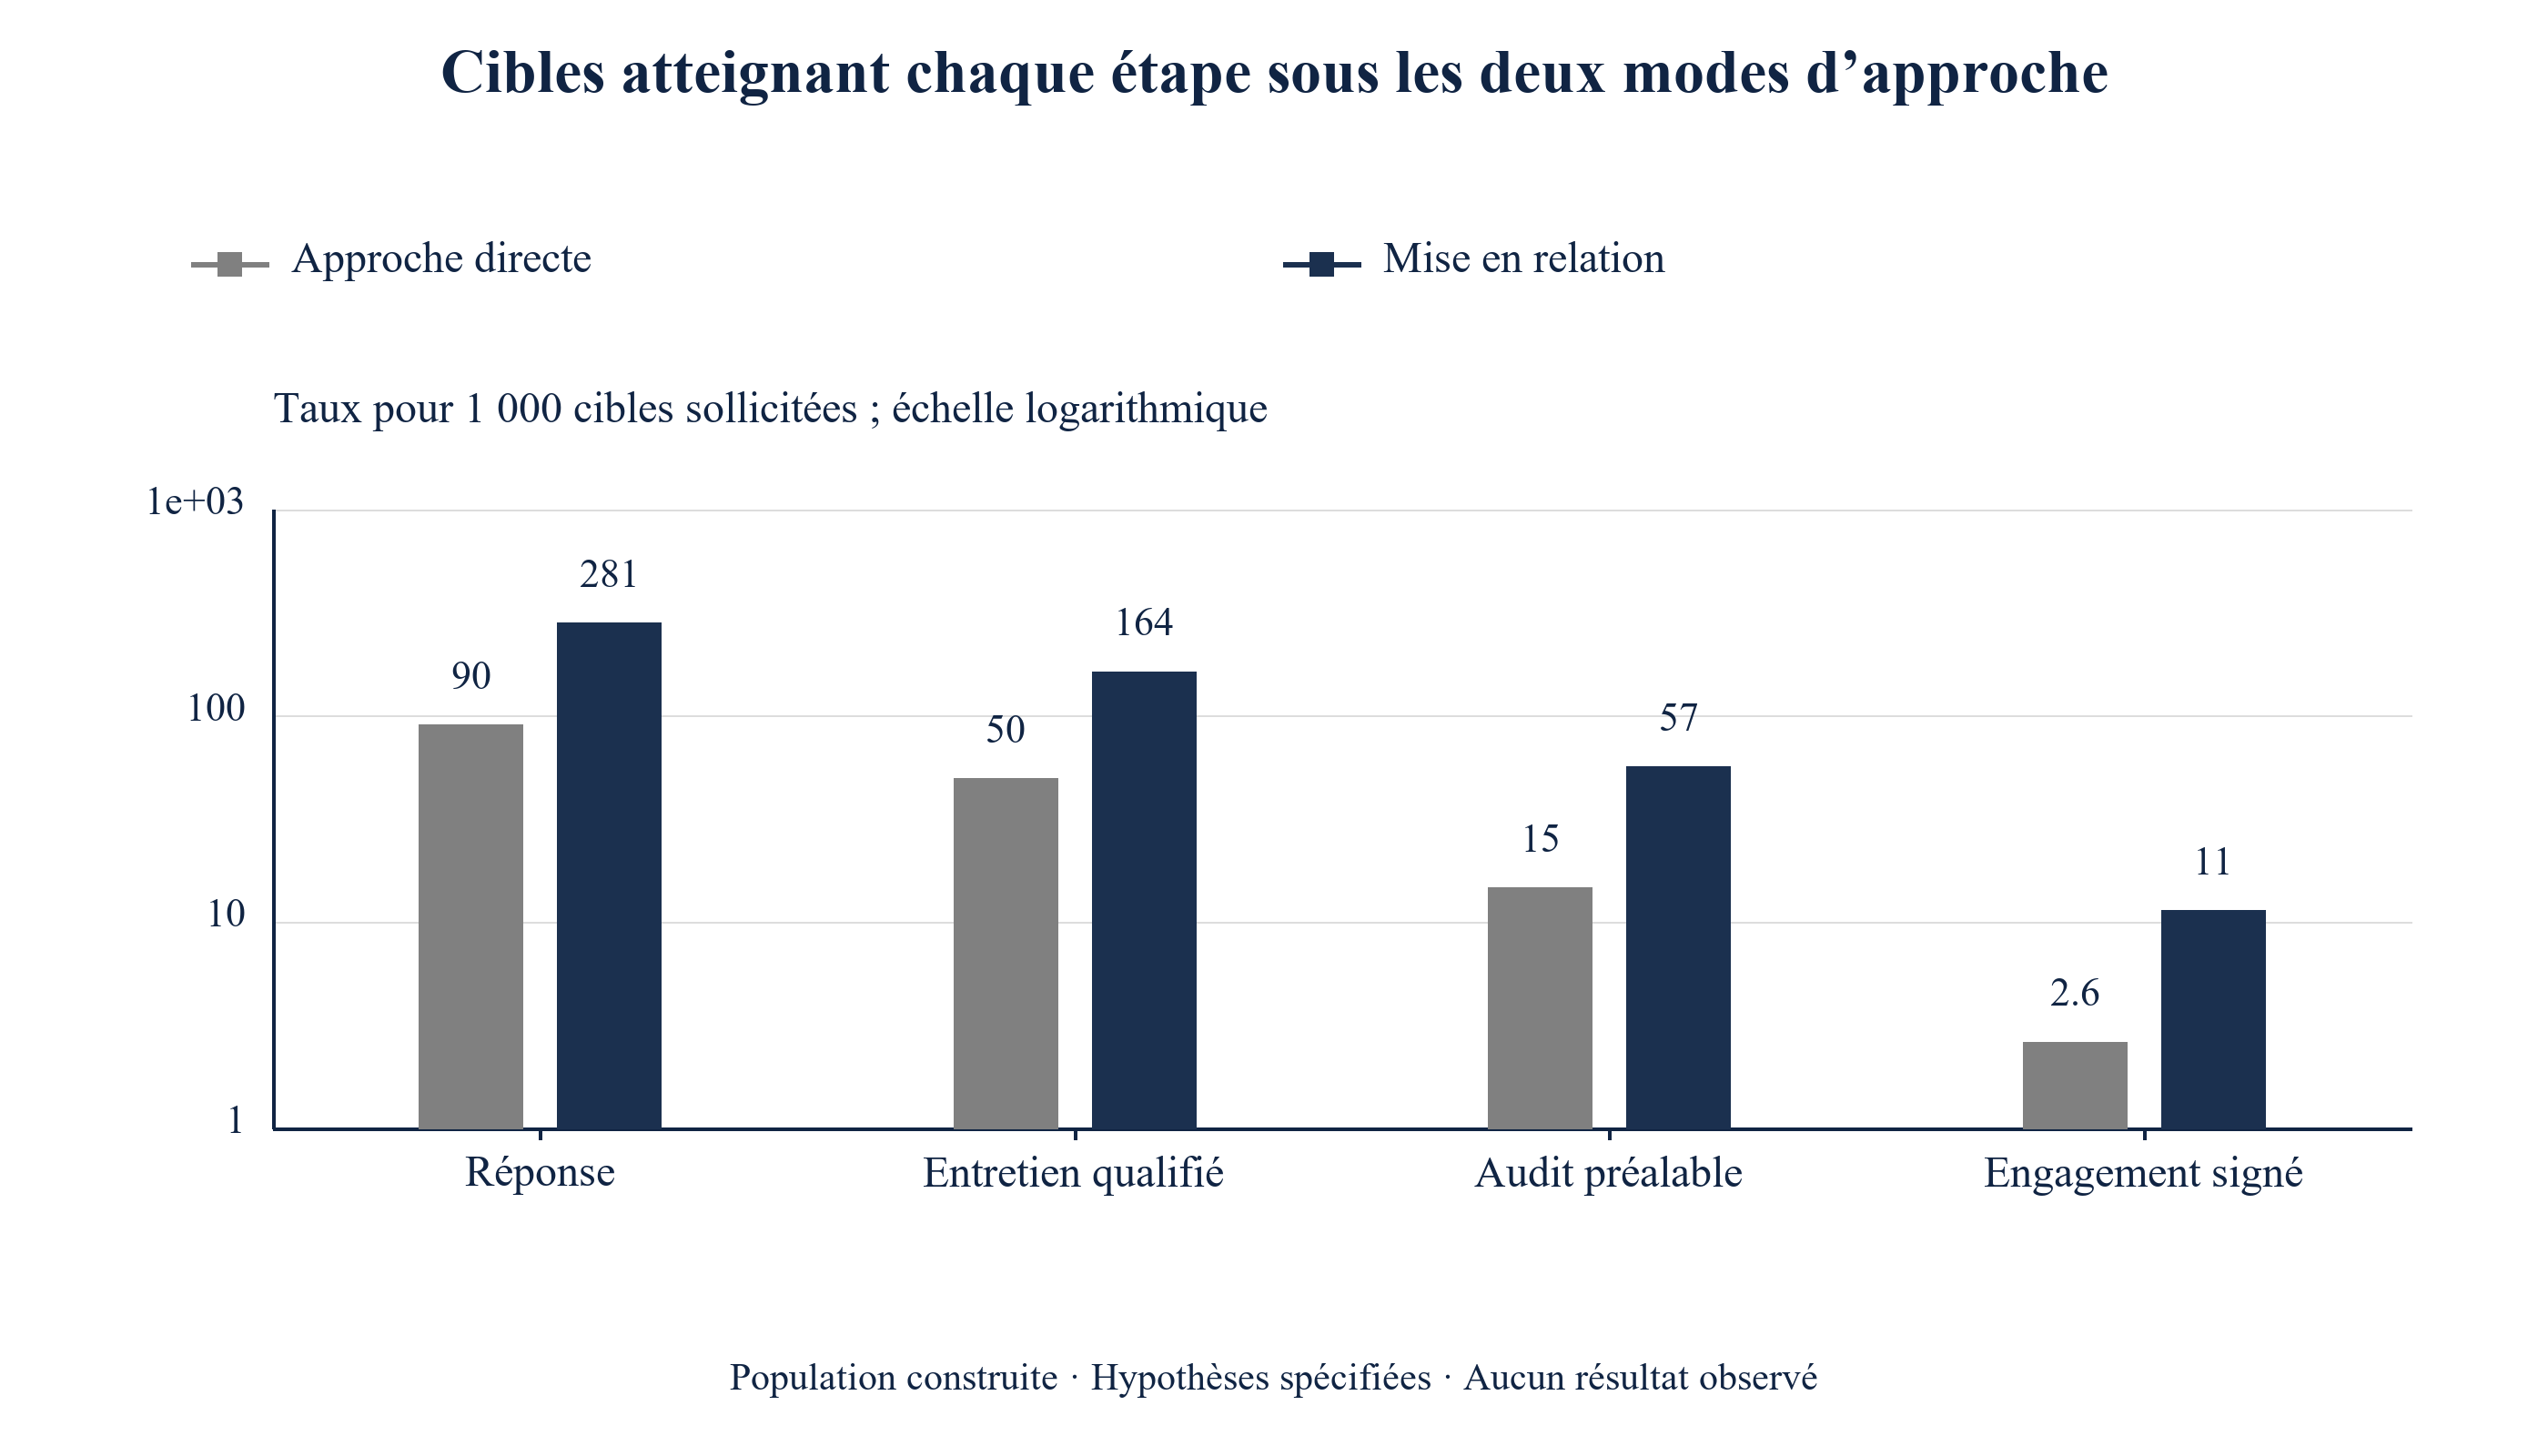
Le tableau 5 présente l’entonnoir réel sous chaque approche. L’approche directe obtient une réponse pour 9,0 % des cibles et un engagement signé pour 0,26 %. La mise en relation obtient une réponse pour 28,1 % et un engagement signé pour 1,13 %. L’effet réel est de 19,12 points de pourcentage pour la réponse, 11,39 pour l’entretien qualifié, 4,20 pour l’audit préalable et 0,87 pour la signature. Le rapport des taux augmente au fil des étapes, de 3,12 pour la réponse à 4,33 pour la signature, car les effets sur les log-cotes s’accumulent entre les étapes.
| Étape | Approche directe | Mise en relation | Effet en points | Rapport des taux | Effet parmi les cibles mises en relation, en points |
|---|---|---|---|---|---|
| Réponse | 9.0 | 28.1 | 19.12 | 3.12 | 24.18 |
| Entretien qualifié | 5.0 | 16.4 | 11.39 | 3.30 | 15.49 |
| Audit préalable | 1.5 | 5.7 | 4.20 | 3.87 | 6.30 |
| Engagement signé | 0.26 | 1.13 | 0.87 | 4.33 | 1.42 |
Analyse MatchPoint de la population construite. Résultat du modèle avec les paramètres indiqués ; aucun résultat observé. Pourcentage des cibles éligibles sollicitées atteignant chaque étape ; effets en points de pourcentage.
Faites défiler horizontalement pour lire la figure en taille réelle. Vous pouvez aussi ouvrir sa version en taille réelle.
Analyse MatchPoint de la population construite. Résultat du modèle avec les paramètres indiqués ; aucun résultat observé. Échelle logarithmique ; taux pour 1 000 cibles sollicitées.
L’effet sur le groupe mis en relation est supérieur à l’effet moyen, par exemple 24,18 points contre 19,12 pour la réponse. Le mécanisme est le même. Le responsable choisit des cibles présentant davantage de proximité relationnelle et une meilleure adéquation, dont les taux initiaux sont plus élevés ; des effets égaux sur les log-cotes produisent des variations plus grandes en points de pourcentage lorsque le taux initial est plus élevé. La première leçon pour la décision est que le choix des destinataires des mises en relation fait déjà partie de l’explication de leur effet. La figure 1 présente le même entonnoir sur une échelle logarithmique.
11 L’écart brut entre les cibles mises en relation et les cibles sollicitées directement surestime l’effet à chaque étape
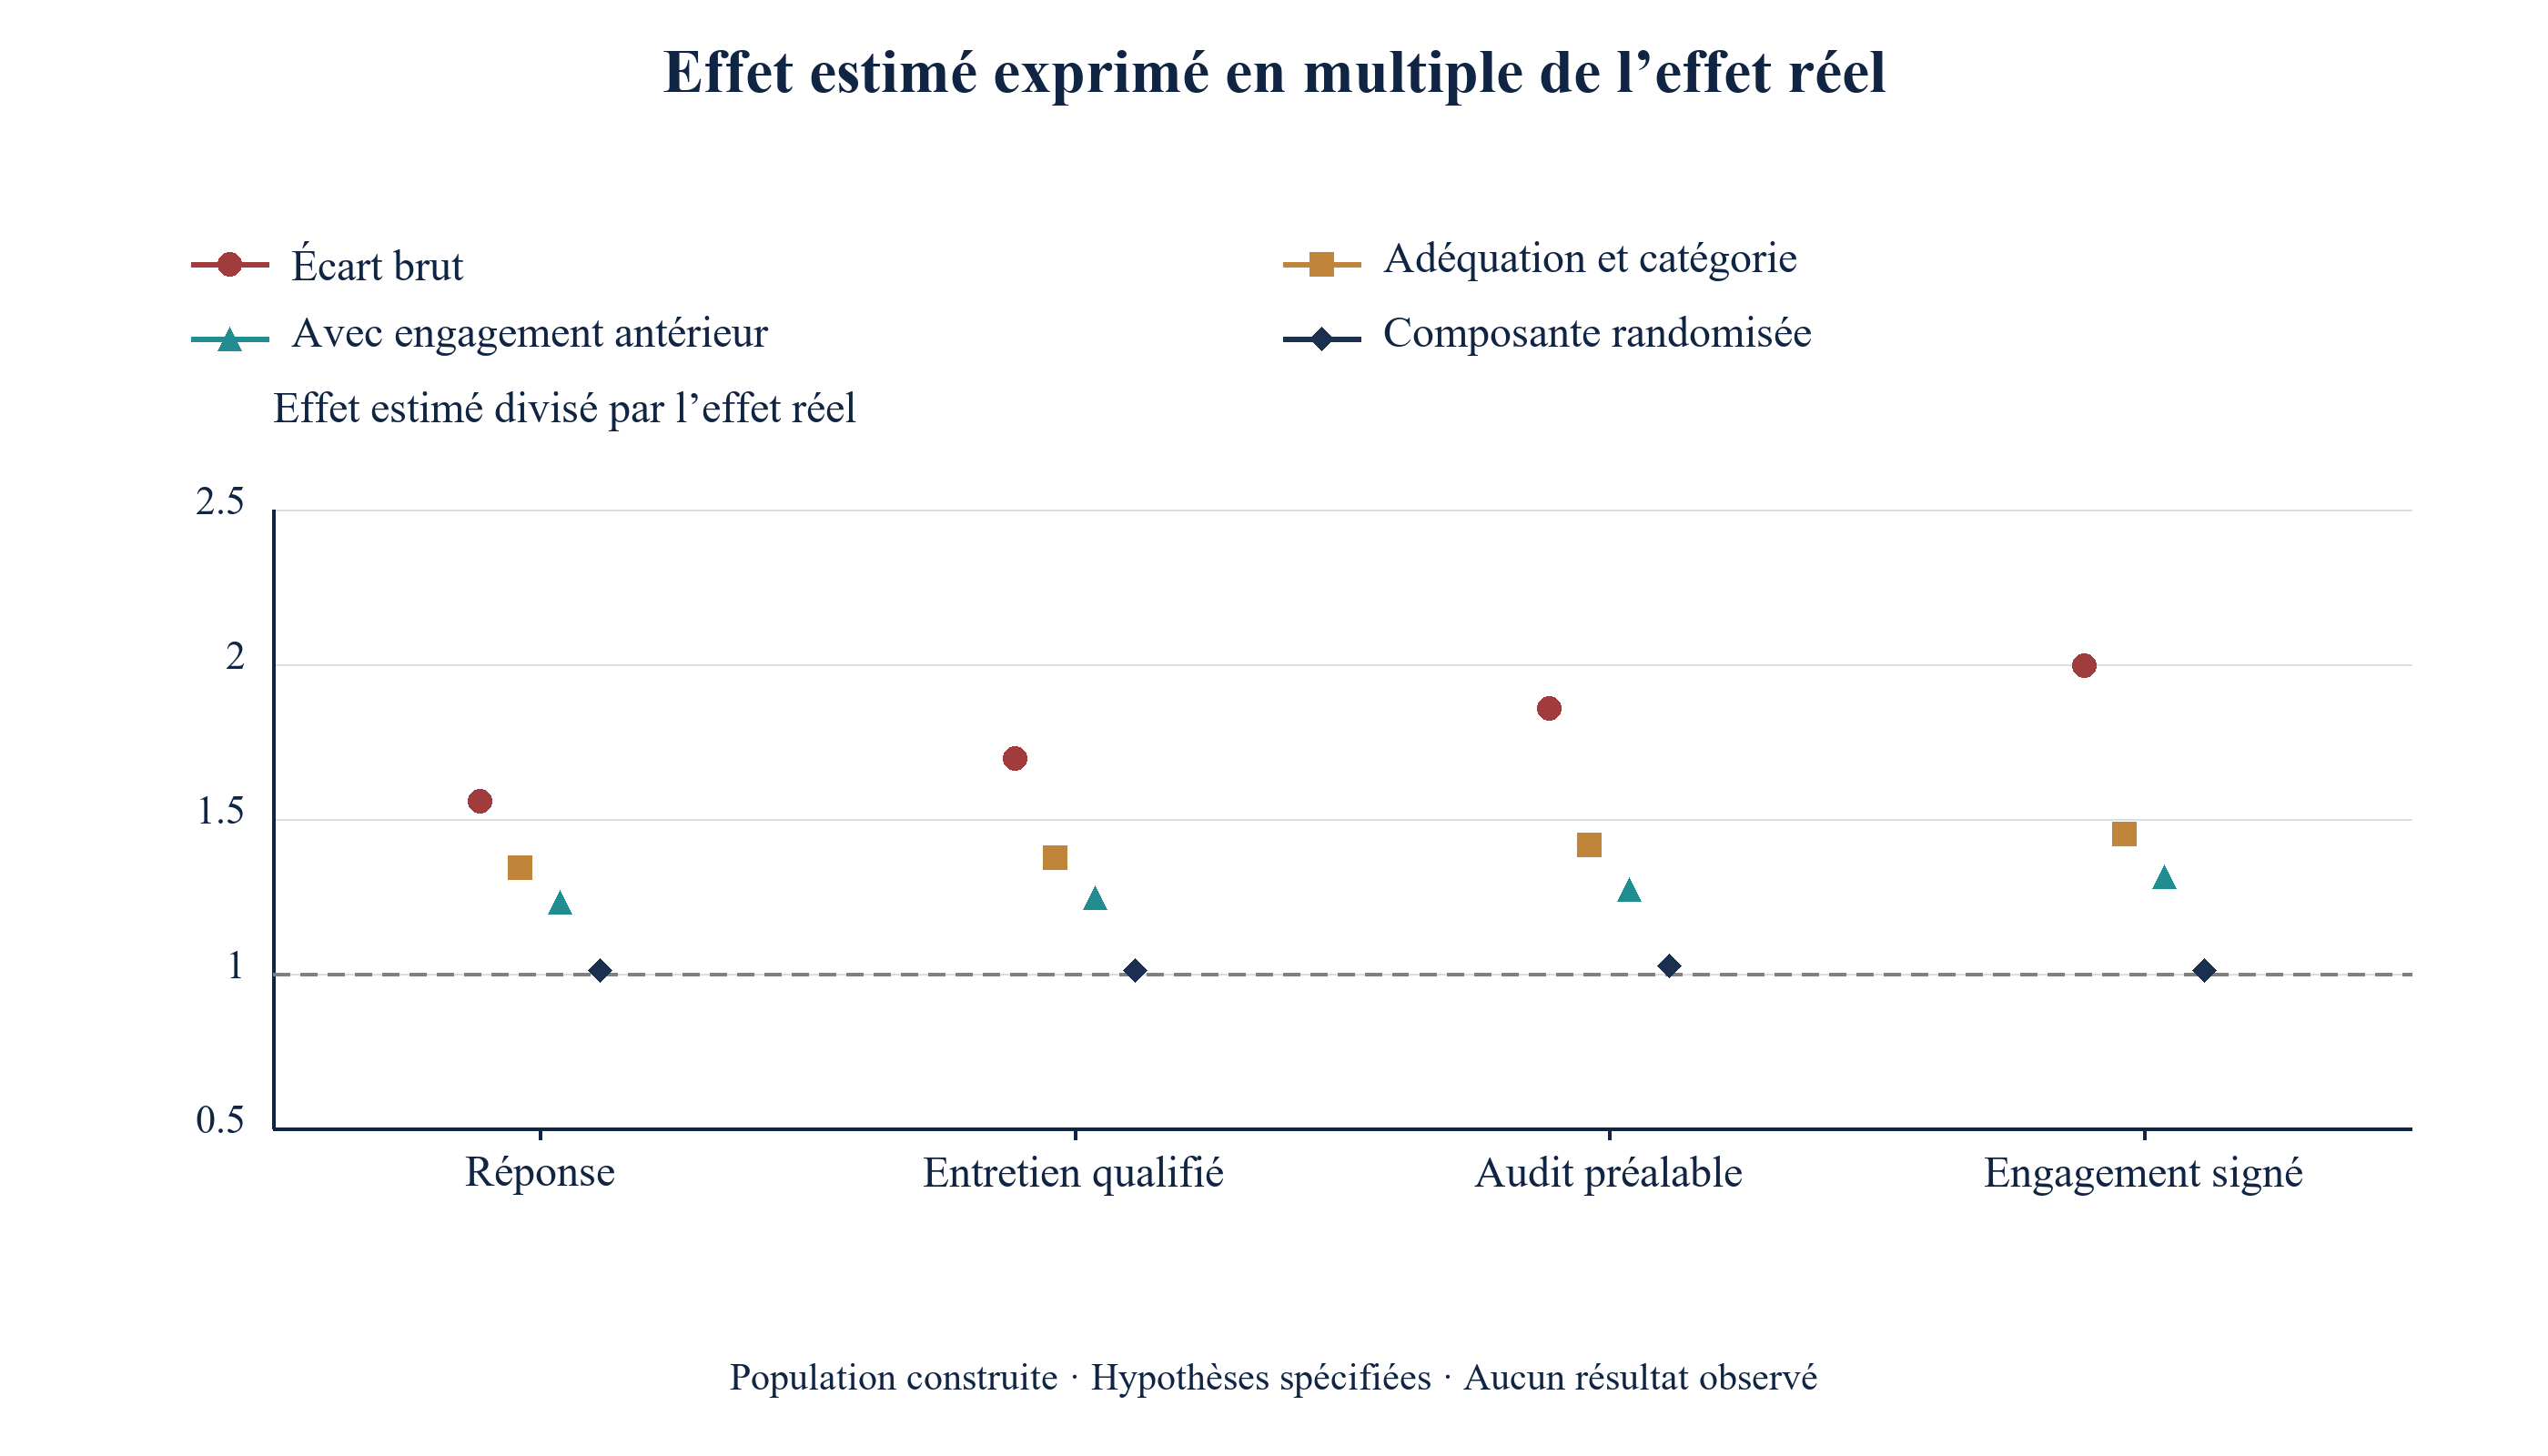
Un responsable lisant son propre journal comparerait les deux groupes. Le tableau 6 présente le résultat de cette comparaison. Pour la réponse, l’écart brut est de 29,76 points contre un effet réel de 19,12, soit un rapport de 1,56. Pour l’entretien qualifié, l’écart brut est de 19,32 contre 11,39. Appliqué à 100 cibles éligibles passant de l’approche directe à la mise en relation, l’écart brut suggérerait 19,3 entretiens qualifiés supplémentaires ; le contraste moyen de la population construite est de 11,4. Cette moyenne diffère de l’effet parmi les cibles sélectionnées pour une mise en relation. Pour la signature, l’écart brut représente 2,00 fois l’effet réel.
| Estimateur | Réponse | Entretien qualifié | Audit préalable | Engagement signé |
|---|---|---|---|---|
| Effet réel connu par construction | 19.12 | 11.39 | 4.20 | 0.87 |
| Écart brut entre les groupes | 29.76 | 19.32 | 7.80 | 1.74 |
| Ajustement selon l’adéquation et la catégorie par régression | 25.65 | 15.65 | 5.94 | 1.27 |
| Ajustement selon l’adéquation et la catégorie par pondération | 25.68 | 15.76 | 5.97 | 1.27 |
| Ajustement intégrant aussi l’engagement antérieur | 23.55 | 14.21 | 5.34 | 1.14 |
| Composante randomisée | 19.29 | 11.52 | 4.31 | 0.88 |
Analyse MatchPoint de la population construite. Résultat du modèle avec les paramètres indiqués ; aucun résultat observé. Points de pourcentage des cibles éligibles sollicitées ; les estimations utilisent de grands échantillons générés, avec une variation finie de Monte-Carlo.
Faites défiler horizontalement pour lire la figure en taille réelle. Vous pouvez aussi ouvrir sa version en taille réelle.
Analyse MatchPoint de la population construite. Résultat du modèle avec les paramètres indiqués ; aucun résultat observé. La ligne en pointillés indique une estimation correcte.
La surestimation apparaît à chaque étape. Conditionner sur une étape ultérieure aggrave le problème. Parmi les cibles ayant répondu, les taux réels d’entretien sont de 58,1 % avec mise en relation et de 55,1 % sous approche directe, soit un écart de 3,1 points ; la comparaison des réponses observées après mise en relation et approche directe indique pourtant 10,4 points. Cela tient au fait que les groupes de répondants sont composés de personnes différentes sous chaque approche. Une comparaison partant de l’étape atteinte plutôt que de la cible sollicitée répond à une autre question que celle du responsable. La figure 2 représente chaque estimation en multiple de l’effet réel aux quatre étapes.
12 L’ajustement selon l’adéquation et la catégorie retire 39 % du biais de réponse ; l’équilibre des variables enregistrées ne révèle pas le reste
La correction habituelle ajuste selon l’adéquation et la catégorie enregistrées. Le tableau 6 montre que la standardisation par régression donne 25,65 points pour la réponse et la pondération par le score de propension estimé 25,68, contre un effet réel de 19,12. L’ajustement retire 39 % du biais brut de 10,64 points et laisse 6,53 points. Pour l’engagement signé, l’estimation ajustée représente 1,45 fois l’effet réel. L’ajustement améliore l’estimation tout en indiquant encore au responsable que les mises en relation valent 25,7 réponses pour 100 cibles, alors que la valeur réelle est de 19,1.
Dans l’équation 3a, X(i) contient l’adéquation et la catégorie enregistrées. La probabilité ajustée p(k)(a, X(i)) provient d’une régression logistique de l’atteinte de l’étape sur le mode d’approche et X(i), puis d’une moyenne sur toutes les cibles en fixant l’approche successivement à chaque valeur. Dans l’équation 3b, e(i) est la probabilité estimée de mise en relation conditionnellement à X(i), bornée entre 0,01 et 0,99 ; les deux moyennes pondérées sont normalisées par leurs poids. Les deux estimateurs donnent des valeurs proches, 25,65 et 25,68 points, car ils utilisent les mêmes informations.
Faites défiler horizontalement pour lire la figure en taille réelle. Vous pouvez aussi ouvrir sa version en taille réelle.
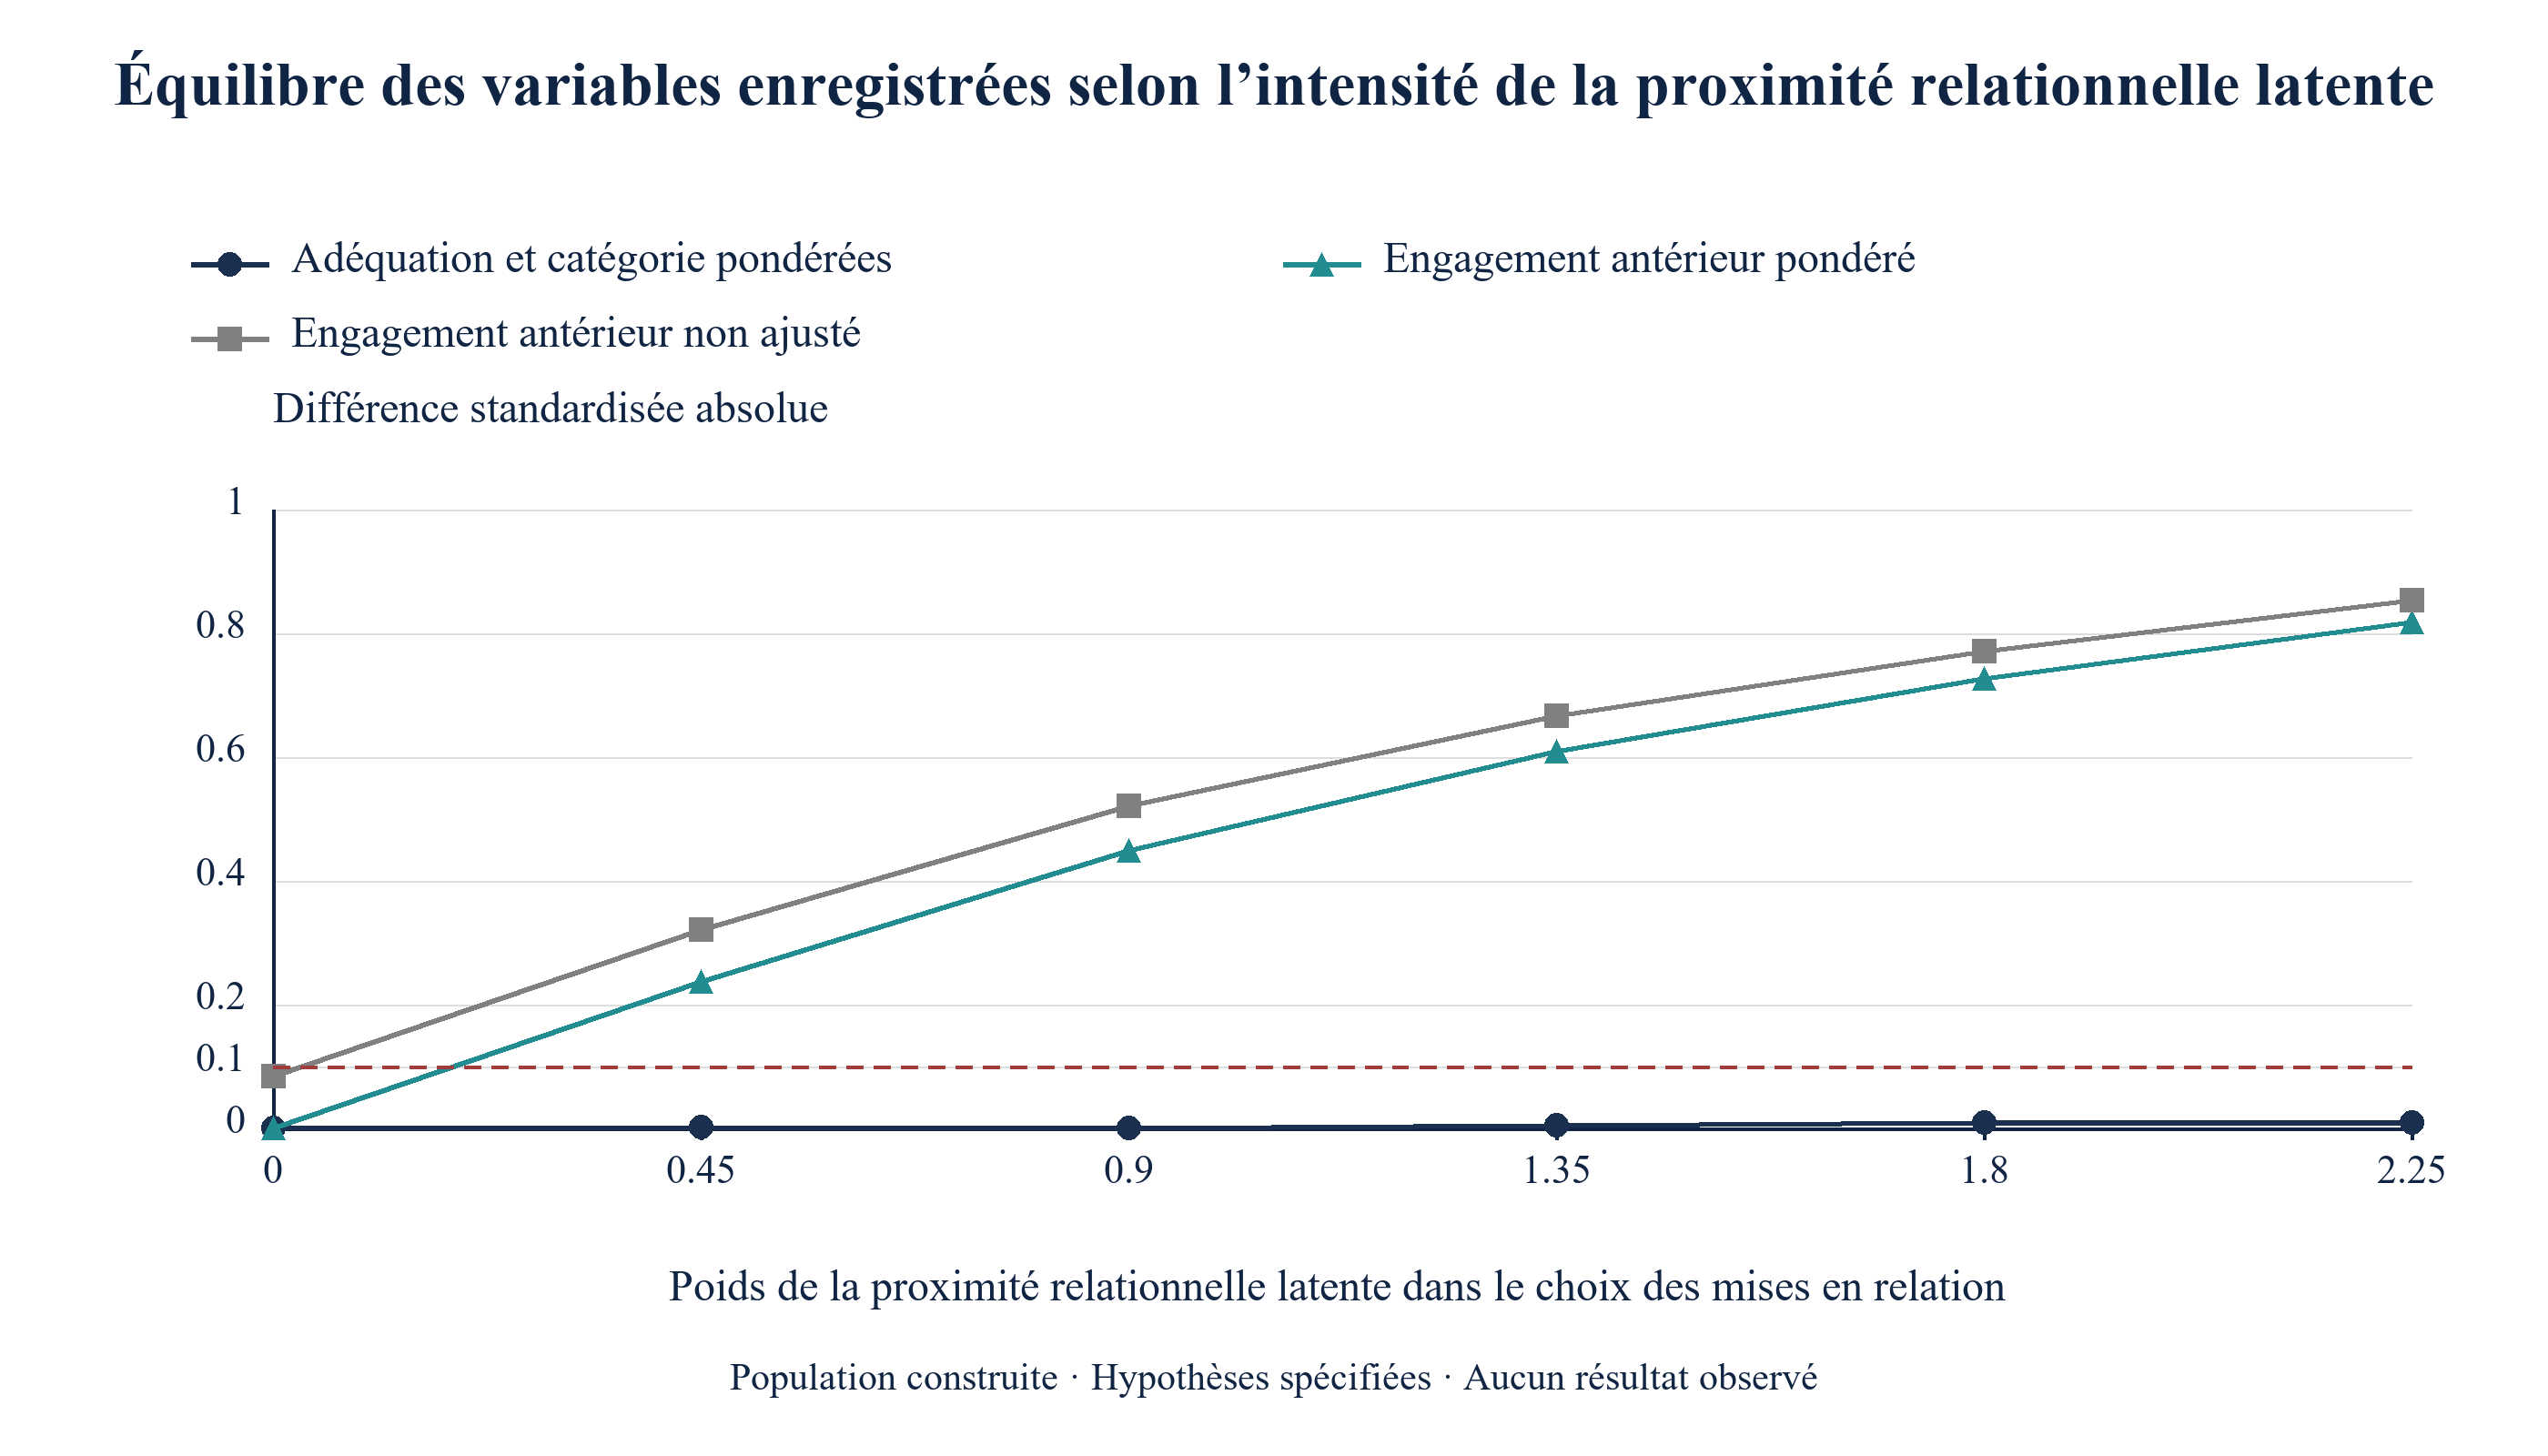
Analyse MatchPoint de la population construite. Résultat du modèle avec les paramètres indiqués ; aucun résultat observé. Différences standardisées absolues entre les cibles mises en relation et sollicitées directement ; la ligne en pointillés représente le seuil conventionnel de 0,1.
La figure 3 montre pourquoi un contrôle habituel de l’équilibre ne protège pas le responsable. Après pondération, la différence standardisée maximale pour l’adéquation et la catégorie enregistrées ne dépasse jamais 0,010, quelle que soit l’intensité de proximité relationnelle latente testée, et reste très inférieure à la convention de 0,1. [6] L’indice d’engagement antérieur, qui réagit à cette proximité, présente une différence standardisée de 0,442 après la même pondération dans le scénario de base, contre 0,513 avant tout ajustement. Le tableau d’équilibrage des variables enregistrées est satisfaisant dans tous les cas ; cela ne prouve donc pas l’absence de biais dans la comparaison.
13 L’indicateur d’engagement réduit le biais dans le scénario de base ; le point de comparaison randomisé est proche de l’effet construit
L’ajout de l’indice d’engagement antérieur aux variables d’ajustement fait passer l’estimation de réponse de 25,65 à 23,55 points et retire 58 % du biais brut. Le biais restant est de 4,42 points. Cet indicateur mesure imparfaitement la proximité relationnelle et n’en saisit donc qu’une partie. Pour une étude réelle, il est recommandé de consigner tout signal d’intérêt de l’investisseur antérieur au contact, comme l’ouverture d’une correspondance précédente ou une réponse à celle-ci, car c’est le moyen disponible le plus direct de réduire les facteurs de confusion que le responsable ne peut autrement enregistrer.
Sous affectation aléatoire, la proximité relationnelle est équilibrée en espérance entre les groupes. Le point de comparaison de population utilise un échantillon généré séparément de 400 000 cibles affectées à pile ou face ; il ne correspond pas littéralement à un quart de la population observationnelle. Dans la comparaison de campagnes répétées, les estimateurs observationnels utilisent n cibles et l’estimateur randomisé un échantillon généré séparément de round(25 % de n) cibles issu du même mécanisme. Ce point de comparaison estime 19,29 points pour la réponse, 11,52 pour l’entretien, 4,31 pour l’audit préalable et 0,88 pour la signature, proches des contrastes de la population finie. Une composante réellement intégrée exige une sélection aléatoire dans cette composante, le respect de l’affectation et un suivi compatible ; le choix discrétionnaire est abandonné en son sein.
Dans l’équation 4a, R vaut un pour les cibles de la composante randomisée et chaque terme est la moyenne de l’indicateur d’étape au sein d’un groupe de cette composante. Dans l’équation 4b, la racine de l’erreur quadratique moyenne d’un estimateur sur les campagnes répétées combine son biais au carré et sa variance. Avec des groupes non vides et le mécanisme d’affectation spécifié, la différence randomisée est sans biais en espérance pour la population échantillonnée ; sa valeur réalisée reste bruitée. Le code fini renvoie zéro si un groupe est vide. Dans le scénario de base testé, les estimateurs ajustés conservent un biais lorsque la taille de l’échantillon augmente, tandis que la variance de l’estimateur randomisé diminue. La section 16 montre où les deux courbes se croisent.
14 La proximité relationnelle latente gonfle les estimations ajustées dans les paramètres testés ; les calculs de sensibilité exigent des paramètres de confusion correctement définis
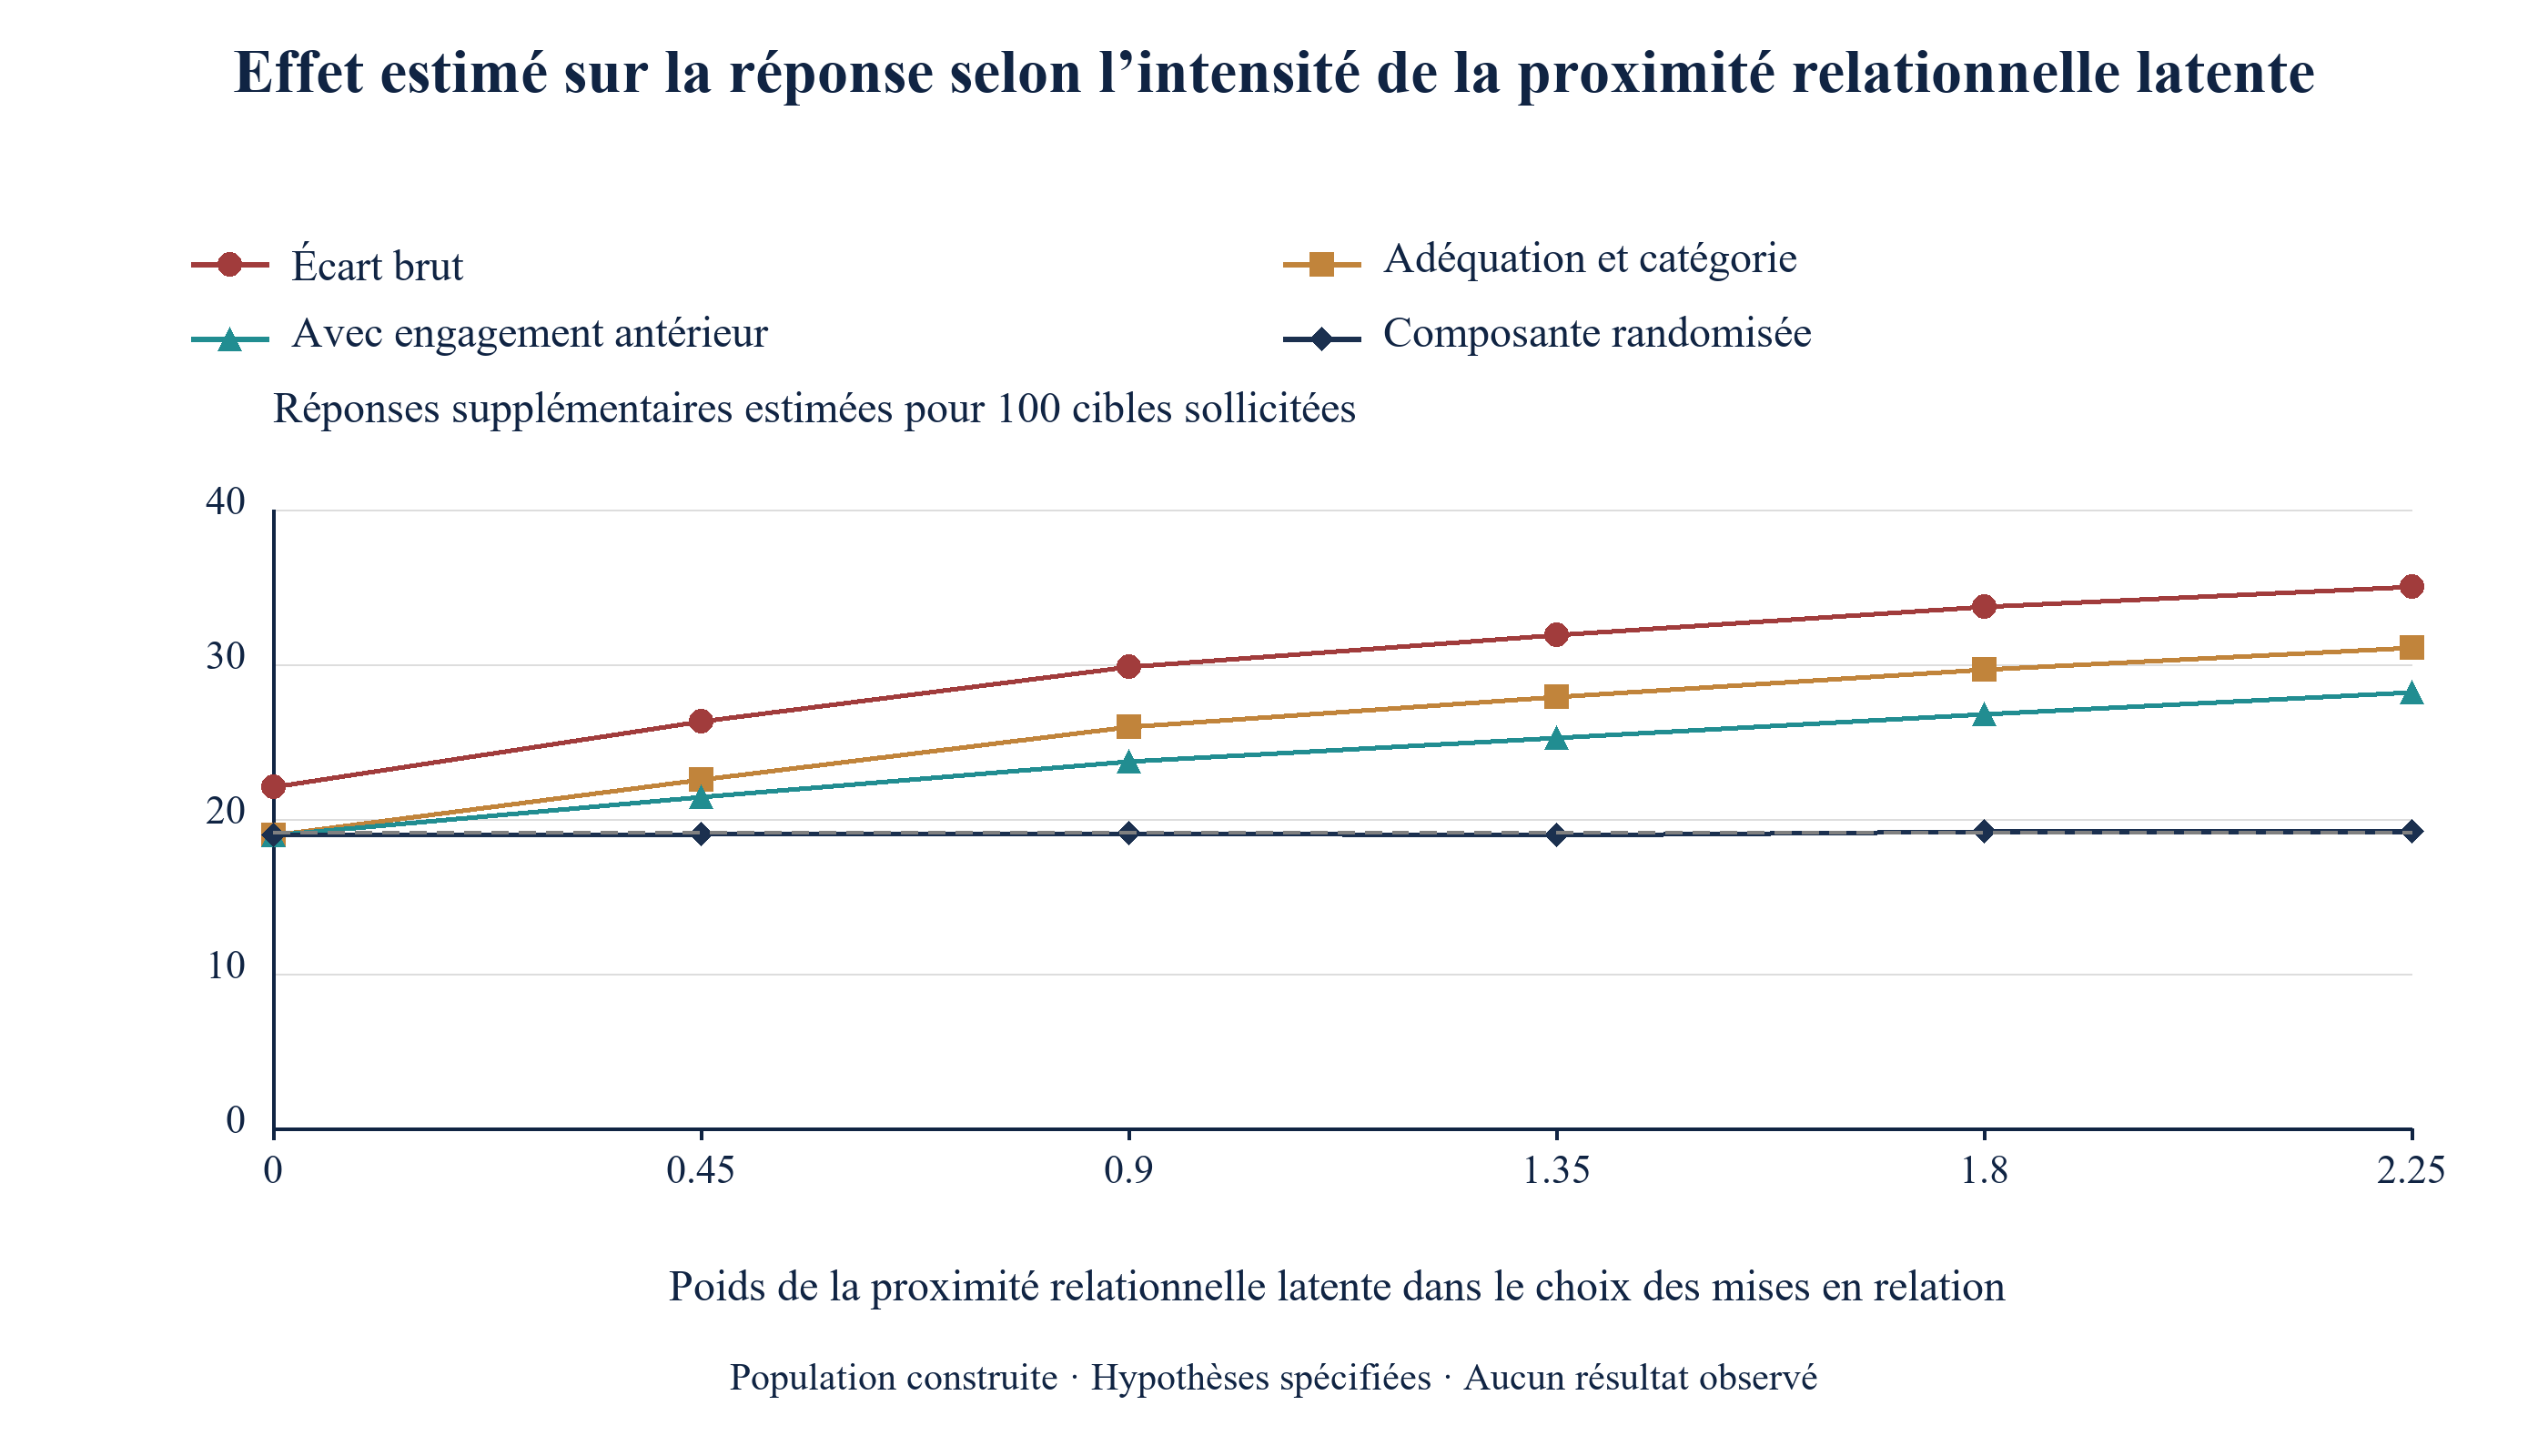
Faites défiler horizontalement pour lire la figure en taille réelle. Vous pouvez aussi ouvrir sa version en taille réelle.
Analyse MatchPoint de la population construite. Résultat du modèle avec les paramètres indiqués ; aucun résultat observé. Points de pourcentage des cibles sollicitées ; la ligne en pointillés représente l’effet réel.
La figure 4 fait varier le poids de la proximité relationnelle latente dans le choix du responsable, de zéro à 2,25, contre une valeur de base de 0,9. Avec un poids nul, l’estimation ajustée selon l’adéquation est de 18,96 points contre un effet réel de 19,12, et l’écart brut est de 22,07 : seules l’adéquation et la catégorie enregistrées confondent alors la comparaison, et l’ajustement y remédie. Au poids maximal testé, 2,25, l’écart brut monte à 35,04, l’estimation ajustée selon l’adéquation à 31,09 et celle intégrant l’indicateur indirect à 28,21. Les points de comparaison randomisés simulés indépendamment restent proches des effets générés, avec une variation finie de Monte-Carlo. L’expérience montre le comportement de la méthode lorsque sa condition est satisfaite, ici en l’absence de proximité relationnelle latente, et l’ampleur de son échec lorsque cette condition se dégrade.
L’équation 5a donne la valeur E relative à l’hypothèse nulle lorsque RR est supérieur à un. Dans l’équation 5b, les paramètres définis par la source bornent la variation du risque de résultat et la variation de la prévalence du facteur de confusion sous le conditionnement spécifié. Leurs définitions font intervenir des maxima appropriés. Séparément, le rapport de réponse standardisé par régression dans le modèle est de 4,26, contre un rapport de contraste généré de 3,12, soit un gonflement réalisé de 1,36. [7]
La valeur E relative à l’hypothèse nulle est de 7,98 pour l’estimation ajustée et de 9,58 pour l’estimation brute. Le code calcule aussi des extrema entre quartiles de proximité relationnelle au sein de chaque tercile d’adéquation et catégorie, puis des moyennes pondérées par la population : 4,16 pour le risque de résultat dans le groupe direct et 2,66 pour la prévalence des niveaux de proximité. L’application de l’équation 5b à ces moyennes donne le nombre descriptif de 1,90, comparé au gonflement réalisé du rapport de 1,36. Une partition à la médiane donne 2,43, 1,79 et 1,35. Il s’agit de résumés par regroupements, et non des paramètres uniformément majorants du théorème : moyenner des extrema ne revient pas à prendre leur maximum, et regrouper l’adéquation et la proximité continues laisse subsister une variation résiduelle. Leur comparaison numérique ne prouve ni une borne formelle du biais de confusion ni que la proximité est trop faible pour expliquer l’association. L’effet connu dans la population finie provient des résultats potentiels choisis pour l’expérience. La source décrit aussi des valeurs E non nulles pour déplacer une estimation vers un rapport de risques non nul spécifié ; une valeur E relative à l’hypothèse nulle ne mesure pas à elle seule le gonflement réalisé. [7]
Le responsable peut utiliser l’équilibre d’un indicateur indirect antérieur au contact comme diagnostic et examiner la sensibilité à des associations avec les facteurs de confusion explicitement énoncées. Une différence standardisée d’un indicateur bruité n’est ni une borne inférieure démontrée du déséquilibre de proximité relationnelle latente ni le paramètre de rapport de risques de l’équation 5b. Une borne formelle de sensibilité exige des paramètres et des conditions d’ajustement adaptés au paramètre causal visé et au théorème de la source. La comparaison construite illustre un gonflement sous ses hypothèses ; elle ne fait pas des estimations ajustées des bornes supérieures dans une campagne non observée.
15 Chaque scénario de tension présente une signature d’échec propre, vérifiable dans le journal du responsable
Le tableau 7 présente les estimations de réponse sur de grands échantillons construits dans le scénario de base et cinq scénarios de tension. Chaque scénario utilise 400 000 cibles générées. Les colonnes de diagnostic mesurent l’équilibre de l’adéquation, de la catégorie et de l’engagement antérieur enregistrés après pondération selon l’approche enregistrée. Le scénario de classification erronée utilise donc la même classification enregistrée des approches que ses estimateurs de résultat. Ces diagnostics décrivent les dossiers générés.
| Scénario | Effet réel | Écart brut | Ajustement selon l’adéquation | Avec l’engagement | Randomisation | Équilibre de l’adéquation et de la catégorie | Équilibre de l’engagement |
|---|---|---|---|---|---|---|---|
| Scénario de base | 19.12 | 29.76 | 25.65 | 23.55 | 19.29 | 0.002 | 0.442 |
| Absence de proximité relationnelle latente | 19.10 | 22.36 | 19.25 | 19.24 | 19.34 | 0.001 | 0.005 |
| Forte proximité relationnelle latente | 19.23 | 34.27 | 30.24 | 27.19 | 19.28 | 0.008 | 0.738 |
| Gains croissants avec la proximité relationnelle | 21.56 | 36.74 | 32.27 | 29.10 | 21.68 | 0.002 | 0.447 |
| Marché moins réceptif | 11.57 | 18.52 | 15.73 | 14.34 | 11.49 | 0.005 | 0.440 |
| Mises en relation mal classées | 19.09 | 21.11 | 17.60 | 15.91 | 19.03 | 0.008 | 0.292 |
Analyse MatchPoint de la population construite. Résultat du modèle avec les paramètres indiqués ; aucun résultat observé. Points de pourcentage des cibles éligibles sollicitées ; les colonnes d’équilibre sont des différences standardisées absolues après pondération selon l’adéquation et la catégorie enregistrées.
Sans proximité relationnelle latente, l’estimation ajustée selon l’adéquation est de 19,25 contre 19,10, l’équilibre de l’indicateur indirect vaut 0,005 et les estimations ajustée et randomisée concordent. C’est la signature d’une campagne interprétable à partir de l’ajustement. Avec une forte proximité relationnelle latente, l’estimation ajustée est de 30,24 contre 19,23, l’estimation randomisée reste à 19,28 et l’équilibre de l’indicateur vaut 0,738. La signature est un écart important et persistant entre les estimations ajustée et randomisée, malgré un équilibre satisfaisant des variables enregistrées.
Lorsque les gains augmentent avec la proximité relationnelle, l’effet moyen réel est de 21,56, mais l’effet sur le groupe mis en relation atteint 30,99. L’estimation ajustée de 32,27 dépasse les deux, avec un biais de 10,72 points contre 6,53 dans le scénario de base, tandis que la composante randomisée retrouve l’effet moyen à 21,68. La signature est une estimation ajustée supérieure même à l’effet sur les cibles mises en relation. Dans un marché moins réceptif, le taux de réponse directe descend à 4,4 % et l’effet à 11,57 points, tandis que le rapport entre l’estimation ajustée et l’effet réel reste proche de 1,36 ; la signature est une baisse des taux à chaque étape avec un biais proportionnel similaire. Lorsque 15 % des mises en relation sont enregistrées comme des approches directes et 10 % des approches directes comme des mises en relation, l’estimation ajustée tombe à 17,60, sous l’effet réel de 19,09. Les erreurs se compensent, la réponse paraît correcte et l’explication est erronée ; l’audit du marquage de la section 22 constitue donc un contrôle distinct.
Les diagnostics peuvent être interprétés ensemble. L’équilibre des variables enregistrées ne contrôle que le déséquilibre mesuré ; celui de l’indicateur indirect peut signaler une différence résiduelle dans la mesure enregistrée de l’engagement. L’écart entre les estimations ajustée et randomisée, assorti de son incertitude et rapporté à une population cible commune, peut révéler une divergence entre les stratégies d’estimation. Il peut aussi refléter une erreur d’échantillonnage, une mauvaise spécification du modèle, une classification erronée, un non-respect du traitement assigné ou une sélection dans la composante randomisée. Le profil des étapes peut aider à orienter des vérifications supplémentaires. Aucune de ces observations n’identifie à elle seule la proximité relationnelle latente ni n’établit qu’une comparaison observationnelle est sans biais.
16 Dans le scénario de base construit, une campagne de 400 cibles présente encore une erreur d’estimation importante
Un responsable réel observe une campagne, et non la limite de population. Le modèle tire 600 campagnes à chacune de six tailles et applique chaque estimateur. Pour 400 cibles, l’estimation de réponse ajustée selon l’adéquation a une médiane de 25,59 points et un intervalle central de 80 % allant de 19,8 à 31,8 ; 92 % des campagnes surestiment l’effet réel de 19,12 points. La composante randomisée, qui comporte ici 100 cibles, a une médiane de 18,42 et une plage de 10,0 à 27,9. Elle est correcte en moyenne et peu fiable dans une campagne isolée.
| Estimateur | Étape | Effet réel | Médiane | 80 % centraux des campagnes | Estimation inférieure ou égale à zéro | RMSE |
|---|---|---|---|---|---|---|
| Écart brut | Réponse | 19.12 | 29.69 | 23,7 à 35,6 | 0% | 11.53 |
| Écart brut | Audit préalable | 4.20 | 7.79 | 4,5 à 11,4 | 0% | 4.60 |
| Ajustement selon l’adéquation et la catégorie | Réponse | 19.12 | 25.59 | 19,8 à 31,8 | 0% | 8.13 |
| Ajustement selon l’adéquation et la catégorie | Audit préalable | 4.20 | 5.89 | 2,9 à 9,5 | 0% | 3.13 |
| Avec l’engagement | Réponse | 19.12 | 23.50 | 17,6 à 29,6 | 0% | 6.45 |
| Avec l’engagement | Audit préalable | 4.20 | 5.33 | 2,4 à 8,7 | 0% | 2.74 |
| Composante randomisée, 100 cibles | Réponse | 19.12 | 18.42 | 10,0 à 27,9 | 0% | 7.15 |
| Composante randomisée, 100 cibles | Audit préalable | 4.20 | 4.00 | 0,0 à 8,7 | 14% | 3.66 |
Analyse MatchPoint de la population construite. Résultat du modèle avec les paramètres indiqués ; aucun résultat observé. Points de pourcentage ; l’intervalle central de 80 % va du 10e au 90e centile sur 600 campagnes ; RMSE désigne la racine de l’erreur quadratique moyenne par rapport à l’effet réel.
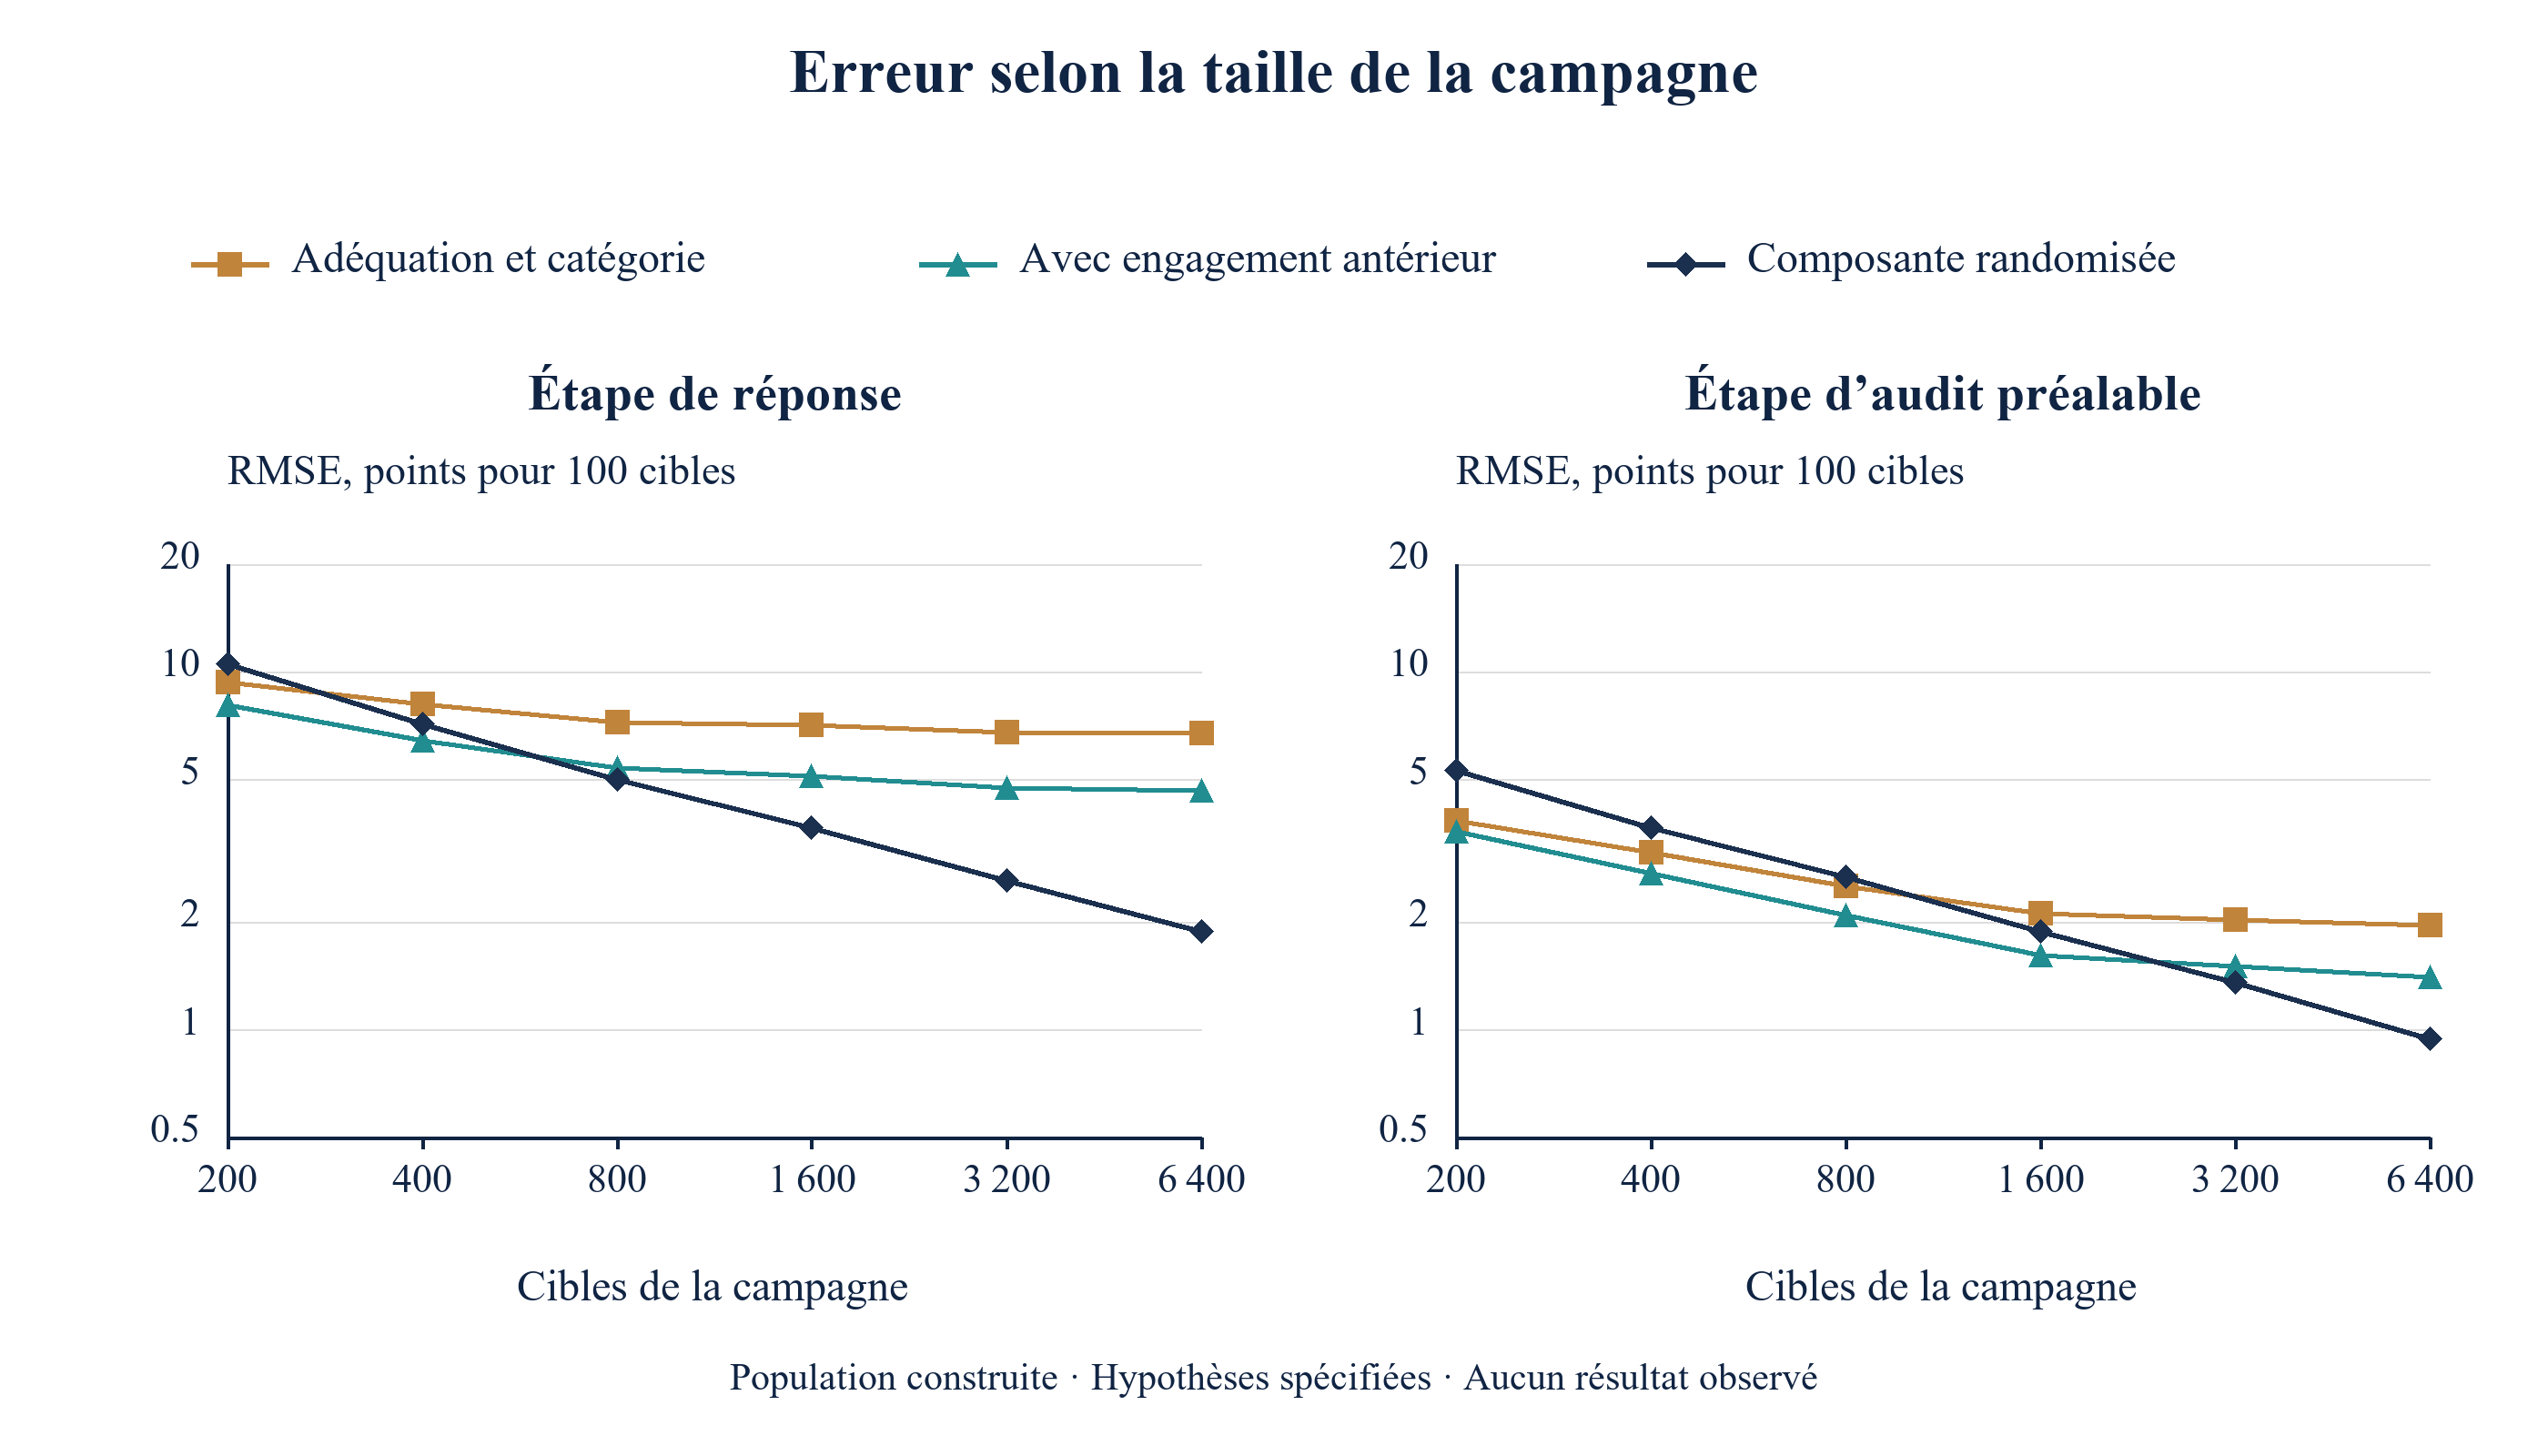
Faites défiler horizontalement pour lire la figure en taille réelle. Vous pouvez aussi ouvrir sa version en taille réelle.
Analyse MatchPoint de la population construite. Résultat du modèle avec les paramètres indiqués ; aucun résultat observé. Racine de l’erreur quadratique moyenne en points de pourcentage pour 100 cibles sollicitées ; deux axes logarithmiques ; la composante randomisée représente 25 % de la campagne.
Le tableau 8 et la figure 5 présentent l’arbitrage entre biais et bruit. Pour 400 cibles, l’erreur ajustée selon l’adéquation à l’étape de réponse est de 8,13 points contre 7,15 pour la composante randomisée ; celle-ci fournit donc déjà la meilleure estimation à 400 cibles. Pour 6 400 cibles, l’erreur ajustée selon l’adéquation a à peine diminué, à 6,74, tandis que celle de la composante est descendue à 1,88. Lorsque l’indicateur indirect est ajouté, la composante prend l’avantage à 800 cibles. Pour l’audit préalable, le croisement se produit à 1 600 cibles. Il s’agit des premiers croisements parmi les six tailles de campagne testées dans cette construction ; ce ne sont ni des seuils continus estimés ni une règle générale pour un responsable. Un choix réel dépend du mécanisme d’affectation, des tailles d’effet, de la précision et de l’échantillon randomisé disponible.
17 Sous les taux choisis, les résultats tardifs exigent des échantillons randomisés plus grands
Dans l’équation 6a, p(1) et p(0) sont les taux réels des étapes sous mise en relation et approche directe ; les z sont les quantiles de la loi normale centrée réduite pour un test bilatéral au seuil de 5 % et une puissance de 80 %, et n(arm) est le nombre de cibles nécessaire dans chaque groupe de la composante. Dans l’équation 6b, s est la part randomisée de la campagne, fixée à 25 %, et N(campaign) est le nombre de cibles que l’ensemble de la campagne doit solliciter. La formule est une approximation normale pour des cibles indépendantes ; la simulation dimensionnée à partir de cette formule ne vérifie que l’étape de réponse. L’affectation à pile ou face donne des effectifs de groupe attendus plutôt que fixes. La règle simulée de rejet de Wald utilise les deux queues, traite une erreur standard estimée nulle comme un non-rejet et peut être mal calibrée pour des résultats rares ; ces tailles d’échantillon nécessitent une validation propre à chaque résultat avant utilisation.
| Résultat mesuré | Approche directe (%) | Mise en relation (%) | Cibles par groupe pour une puissance de 80 % | Taille de campagne avec la part randomisée indiquée | Campagnes de 400 cibles | Puissance simulée, n = 400 | Puissance simulée, n = 6 400 |
|---|---|---|---|---|---|---|---|
| Réponse | 9.0 | 28.1 | 62 | 496 | 1.2 | 73% | 100% |
| Entretien qualifié | 5.0 | 16.4 | 112 | 896 | 2.2 | 46% | 100% |
| Audit préalable | 1.5 | 5.7 | 302 | 2 416 | 6.0 | 16% | 100% |
| Engagement signé | 0.26 | 1.13 | 1 428 | 11 424 | 28.6 | 0% | 55% |
Analyse MatchPoint de la population construite ; aucun résultat observé. Tailles approximatives issues de la formule normale pour des cibles indépendantes, au seuil bilatéral de 5 % et avec une puissance cible de 80 % ; les taux de rejet de Wald simulés utilisent les tailles de campagne indiquées et peuvent être mal calibrés pour des résultats rares.
L’étape de réponse exige 62 cibles par groupe, qu’une campagne de 496 sollicitations fournit avec la part randomisée indiquée. L’entretien qualifié exige 112 cibles par groupe et 896 sollicitations, l’audit préalable 302 par groupe et 2 416 sollicitations, soit environ 6 campagnes de 400. Un engagement signé exige 1 428 cibles par groupe et 11 424 sollicitations, soit environ 29 campagnes de 400. Pour 400 cibles, la puissance simulée est de 73 % pour la réponse, de 46 % pour l’entretien qualifié et de 16 % pour l’audit préalable. Sous ces taux choisis pour l’expérience, les résultats précoces exigent moins de cibles que les résultats tardifs. Une inférence réelle exige l’intervalle et l’effectif effectivement obtenu. Regrouper les mandats exige aussi des définitions comparables, une attention à l’hétérogénéité des mandats et aux corrélations entre cibles, ainsi qu’une analyse appropriée ; la formule pour cibles indépendantes ne tient pas compte de ces éléments.
18 Lorsque les mises en relation sont rares, l’effet construit est le plus élevé pour les cibles bien adaptées hors de la catégorie la plus difficile à atteindre
Un responsable disposant d’un nombre fixe de mises en relation doit savoir où chacune apporte le plus. Le tableau 10 présente l’effet réel d’une mise en relation par tercile d’adéquation et catégorie. Dans l’univers construit, l’effet sur la réponse va de 10,0 réponses supplémentaires pour 100 cibles peu adaptées de la première catégorie à 26,7 pour les cibles très adaptées des autres catégories. L’effet sur l’entretien qualifié va de 7,0 à 17,9 entretiens supplémentaires pour 100 mises en relation dans les autres catégories.
| Tercile d’adéquation | Autres catégories : réponses supplémentaires | Autres catégories : entretiens supplémentaires | Catégorie 1 : réponses supplémentaires | Catégorie 1 : entretiens supplémentaires |
|---|---|---|---|---|
| Faible adéquation | 14.5 | 7.0 | 10.0 | 4.9 |
| Adéquation moyenne | 20.7 | 12.0 | 15.1 | 8.6 |
| Forte adéquation | 26.7 | 17.9 | 21.6 | 14.4 |
Analyse MatchPoint de la population construite. Résultat du modèle avec les paramètres indiqués ; aucun résultat observé. Effets réels en points de pourcentage par tercile d’adéquation et catégorie ; les cellules se réconcilient avec l’effet de population. Gabarit d’un résultat de composante randomisée : le profil découle d’effets égaux sur les log-cotes et ne constitue pas un constat empirique.
Ce profil découle de la construction. Les effets sont égaux sur l’échelle des log-cotes et les taux initiaux sont faibles ; l’effet en points de pourcentage est donc plus élevé là où le taux initial est plus élevé : chez les cibles mieux adaptées et hors de la première catégorie. Une matrice réelle pourrait être différente, par exemple si les mises en relation comptaient surtout pour les investisseurs difficiles à atteindre. Le tableau est donc un gabarit de résultat que la composante randomisée pourrait produire, et non un résultat empirique. Le responsable a besoin d’une composante assez grande pour estimer les effets par cellule, ce qui exige davantage de cibles que l’estimation de l’effet global.
19 Reproduction, contrôles et limites de ce que l’expérience peut montrer
Le modèle numérique utilise la graine fixe 1377 et vérifie 47 contrôles, résumés dans le tableau 11. Ils portent sur l’identité de sélection, l’emboîtement des étapes, les tolérances de calibration indiquées, les erreurs des points de comparaison randomisés finis, l’arithmétique des valeurs E, la réconciliation des cellules de la matrice et un contrôle de puissance par formule normale pour la réponse. Les contrôles des résumés de sensibilité vérifient l’arithmétique et une comparaison réalisée dans cette construction ; ils ne certifient pas une borne formelle du biais de confusion.
| Contrôle | Résultat attendu |
|---|---|
| Graine fixe | Graine 1377 ; répéter une campagne avec la même clé reproduit exactement chaque estimation |
| Probabilités générées | Strictement comprises entre zéro et un à chaque étape de chaque scénario |
| Emboîtement des étapes | Signature incluse dans l’audit préalable, lui-même inclus dans l’entretien puis la réponse, pour les deux résultats potentiels de chaque cible |
| Calibration | Taux des étapes du groupe direct égaux aux paramètres indiqués à quatre erreurs standards près |
| Part mise en relation | 30 % dans la population, à 0,003 près |
| Identité de sélection | Écart brut égal à l’effet sur les cibles mises en relation augmenté du terme de sélection, à 1e-12 près, aux quatre étapes |
| Absence de proximité relationnelle latente | Estimations ajustées selon l’adéquation à moins de 0,004 de l’effet réel à chaque étape |
| Composante randomisée | À moins de 0,004 de l’effet construit dans les points de comparaison de population ; erreur moyenne simulée de réponse inférieure à 0,005 pour n = 6 400 |
| Règle d’équilibre | Différences standardisées pondérées pour l’adéquation et la catégorie inférieures à 0,1 dans chaque scénario |
| Arithmétique des valeurs E | La valeur E de 1 est 1 ; celle de 2 est 2 + sqrt(2) ; invariance par inversion ; arithmétique du facteur descriptif résumé vérifiée |
| Matrice de scores | Les effectifs des cellules totalisent la population ; les effets pondérés des cellules se réconcilient avec l’effet de population |
| Formule de puissance | La composante dimensionnée par la formule donne une puissance simulée à moins de 0,08 de 0,80 |
| Contrôles vérifiés dans model.py | 47 identités et tests de limites réussis |
Analyse MatchPoint de la population construite. Résultat du modèle avec les paramètres indiqués ; aucun résultat observé.
L’expérience ne peut pas montrer si les mises en relation fonctionnent sur un marché réel. Les résultats potentiels sont générés à partir des mêmes variables que celles utilisées par les méthodes ; elle montre donc le comportement des méthodes lorsque les hypothèses génératrices sont satisfaites, sans établir que ces hypothèses le sont dans la réalité. L’effet réel, l’intensité de la proximité relationnelle latente, le coefficient de chargement de l’indicateur indirect et les taux de progression sont choisis pour l’expérience. Le lecteur devrait en retenir le sens et l’ampleur relative des biais ainsi que les tailles d’échantillon en jeu, et ne devrait pas interpréter les pourcentages comme des estimations de ce qu’accomplissent les mises en relation dans les marchés privés du Golfe ou du monde.
Deux limites des contrôles méritent d’être explicitées. Une identité vérifiée montre que le code met en œuvre les équations indiquées ; elle ne prouve pas que celles-ci décrivent le comportement des investisseurs. Les répétitions utilisent 600 campagnes par taille ; les plages rapportées comportent donc une erreur de Monte-Carlo, faible par rapport aux écarts examinés mais non négligeable pour les plus petits échantillons.
20 Une étude menée avec les consentements nécessaires exige une composante consignée, des mises en relation marquées, des dates d’étape et un plan d’analyse explicite
Une étude réelle se déroulerait au sein des campagnes en cours d’un responsable, avec son autorisation, celle des intermédiaires et, lorsque cela est requis, celle des investisseurs dont les données sont consignées. L’unité est le couple formé d’une cible et d’un mandat. L’étude n’est pas une enquête auprès des investisseurs et ne leur demande pas de modifier leur comportement ; le responsable devrait néanmoins confirmer la base licite de l’enregistrement de l’engagement et de la prise de contact avec chaque cible. Zhang indique que son expérience avec consentement, dans laquelle les investisseurs étaient informés de l’objectif de recherche, sous-estime probablement le biais en raison d’un effet du formulaire de consentement. Il précise aussi qu’il n’a pas recruté d’investisseurs de l’Union européenne pour son expérience par courriels de présentation en raison du Règlement général sur la protection des données. [5]
| Élément | Spécification | Justification |
|---|---|---|
| Unité | Une cible pour un mandat | Les délais des étapes diffèrent selon le mandat |
| Éligibilité | Un chemin de mise en relation identifié existe avant l’affectation | Limite la comparaison aux cibles pouvant être mises en relation |
| Affectation | Tirage à pile ou face consigné pour une part des cibles éligibles ; reste au choix du responsable | Écarte la proximité relationnelle du choix d’affectation dans la composante ; conserve le jugement du responsable ailleurs |
| Horodatages | Premier contact et chaque étape, à partir des enregistrements des systèmes | Même délai pour chaque groupe |
| Marquages | Mode d’approche et lien avec l’intermédiaire enregistrés à la source | Facilite la vérification du mode d’approche et l’audit des erreurs de classification |
| Signaux antérieurs au contact | Engagement antérieur et adéquation enregistrée, fixés avant l’affectation | Permet les diagnostics et l’ajustement avec l’indicateur indirect |
| Consentement et données | Base juridique consignée pour chaque cible ; opposition respectée | Normes de consentement des sources examinées |
| Taille d’échantillon et analyse | Composante dimensionnée par l’équation 6 ; effets avec intervalles ; estimation ajustée uniquement en analyse secondaire | Facilite l’interprétation à partir des estimations et des intervalles |
Spécification proposée. Les rubriques décrivent des choix de conception à fixer à l’avance ; elles ne constituent pas des résultats.
Le tableau 12 énumère les éléments du dispositif. Le plan d’analyse est enregistré avant la première approche. Il précise les résultats des quatre étapes, les délais, l’estimateur principal, soit la différence dans la composante randomisée, l’estimateur secondaire, soit l’ajustement avec l’indicateur indirect, les tests d’erreurs de classification et la règle de regroupement des campagnes. L’étude de Zhang a été enregistrée dans l’AEA RCT Registry ; un responsable peut s’inspirer de cette pratique en datant son plan. [5] Une étude ne trouvant pas d’effet aux étapes tardives devrait présenter l’intervalle et la taille d’échantillon ; un intervalle comprenant à la fois zéro et un effet substantiel justifie de regrouper les données plutôt que de conclure.
21 Présenter au conseil ou au comité d’investissement l’effet randomisé, l’effet ajusté et l’écart entre les deux
Le rapport au comité devrait présenter l’effet de la composante randomisée avec son intervalle, l’effet ajusté et leur différence avec son incertitude, pour une population cible et un résultat communs. Dans le scénario de base, l’estimation ajustée de réponse représente 1,34 fois l’effet connu, tandis que le point de comparaison randomisé en est proche. Dans une étude réelle, l’écart peut refléter la variation d’échantillonnage, la spécification du modèle, le respect de l’affectation, la mesure ou la sélection dans la composante, ainsi que des facteurs de confusion non mesurés. Une concordance sur les réponses ne valide pas l’ajustement des résultats ultérieurs ; ceux-ci exigent leur propre évaluation de l’identification et de la précision.
| Rubrique | Contenu | Décision éclairée |
|---|---|---|
| Effet de la composante randomisée | Différence avec intervalle à chaque étape atteinte | Les mises en relation modifient-elles la progression initiale ? |
| Effet ajusté | Estimation avec adéquation, catégorie et engagement ; méthode explicitée | Association propre au résultat mesuré, sauf si ses hypothèses d’identification sont étayées |
| Écart | Estimation ajustée moins estimation randomisée, avec diagnostic d’engagement | Divergence éventuelle entre stratégies, évaluée avec l’incertitude et des populations comparables |
| Profil des étapes | Effets par étape et par cellule | Où les mises en relation ouvrent l’accès et où elles permettent de conclure les mandats |
| Audit du marquage | Part des mises en relation accompagnées d’un lien consigné et vérifié | Les groupes sont-ils correctement définis ? |
| Capacité | Mises en relation disponibles et utilisées, par catégorie | Peut-on obtenir davantage de mises en relation ? |
Contenu de rapport proposé. Les rubriques décrivent les informations à présenter ; elles ne constituent pas des résultats.
Le tableau 13 en présente le contenu. Le rapport devrait préciser les conclusions que le comité ne devrait pas tirer. Un effet positif sur la réponse ne prouve pas un effet positif sur les engagements signés, dont la mesure exige bien davantage de cibles. Un effet moyen positif ne prouve pas qu’une mise en relation particulière fonctionnera. Omettre l’intervalle dans un rapport incite à interpréter l’estimation ponctuelle comme une preuve. Chacune de ces limites est visible dans l’expérience construite, où les tailles d’échantillon du tableau 9 montrent combien une seule levée permet peu de conclusions.
22 Utiliser les données et l’IA pour tenir les liens et les diagnostics à jour, tout en conservant le contrôle humain des cibles sollicitées
Les données d’entrée de ce test sont des enregistrements : qui connaît qui, quand l’approche a eu lieu, ce qu’a fait l’investisseur et à quelle date. Des logiciels peuvent tenir ces dossiers à jour en extrayant les dates et expéditeurs de la correspondance, en marquant le mode d’approche et en signalant les lacunes. Il s’agit de propositions ; cet article ne présente aucun outil, aucune mesure de précision ni aucun avantage de l’IA. Un système de marquage devrait être testé sur un échantillon vérifié manuellement, car le scénario de classification erronée montre que des erreurs de 10 % à 15 % peuvent faire passer une estimation ajustée sous l’effet réel et la faire paraître correcte.
Un score de proximité relationnelle dérivé de la correspondance pourrait être évalué comme indicateur indirect antérieur au contact. Sa fenêtre de variables et la version du modèle devraient être fixées avant l’affectation. Les messages postérieurs à l’approche ne doivent pas entrer dans une variable d’ajustement initiale. Si le score éclaire aussi les mises en relation discrétionnaires, son rôle relève du mécanisme d’affectation consigné. La composante randomisée proposée reste affectée et auditée séparément. L’article ne mesure aucune précision de l’IA ni aucun avantage commercial.
Les droits de décision humains restent explicites. Le responsable détermine les cibles éligibles et les personnes qui les sollicitent. L’intermédiaire décide de procéder ou non à une mise en relation et de sa formulation. La conformité confirme la base juridique de chaque approche. Un modèle peut préparer les dossiers et les diagnostics ; aucune de ces décisions ne devrait lui être déléguée.
L’audit de marquage proposé compare le dossier du responsable au message conservé par l’intermédiaire sur un échantillon prédéfini, et consigne les concordances et le sens des erreurs. Dans le scénario de tension construit, 15 % des approches par mise en relation et 10 % des approches directes sont mal classées, ce qui modifie substantiellement l’estimation ajustée. Un audit réel nécessite son propre échantillon et sa propre évaluation de l’incertitude. Son coût n’est pas estimé ici.
23 Appliquer une règle de décision pendant une levée : randomiser tôt, regrouper ensuite et mobiliser les mises en relation là où la composante indique leur utilité
La séquence opérationnelle proposée commence par des cibles éligibles, des caractéristiques initiales enregistrées, des bases licites de contact et de traitement, ainsi que des résultats définis. La sélection aléatoire dans la composante expérimentale et l’affectation aléatoire en son sein devraient être consignées avant les approches. Les approches discrétionnaires restent marquées séparément. Le suivi utilise des durées écoulées comparables, avec conservation pour l’analyse des écarts, des cibles récurrentes et des dossiers manquants. La figure 6 présente la séquence. La validité dépend du respect de l’affectation, de la mesure des résultats et des hypothèses exposées plus haut.
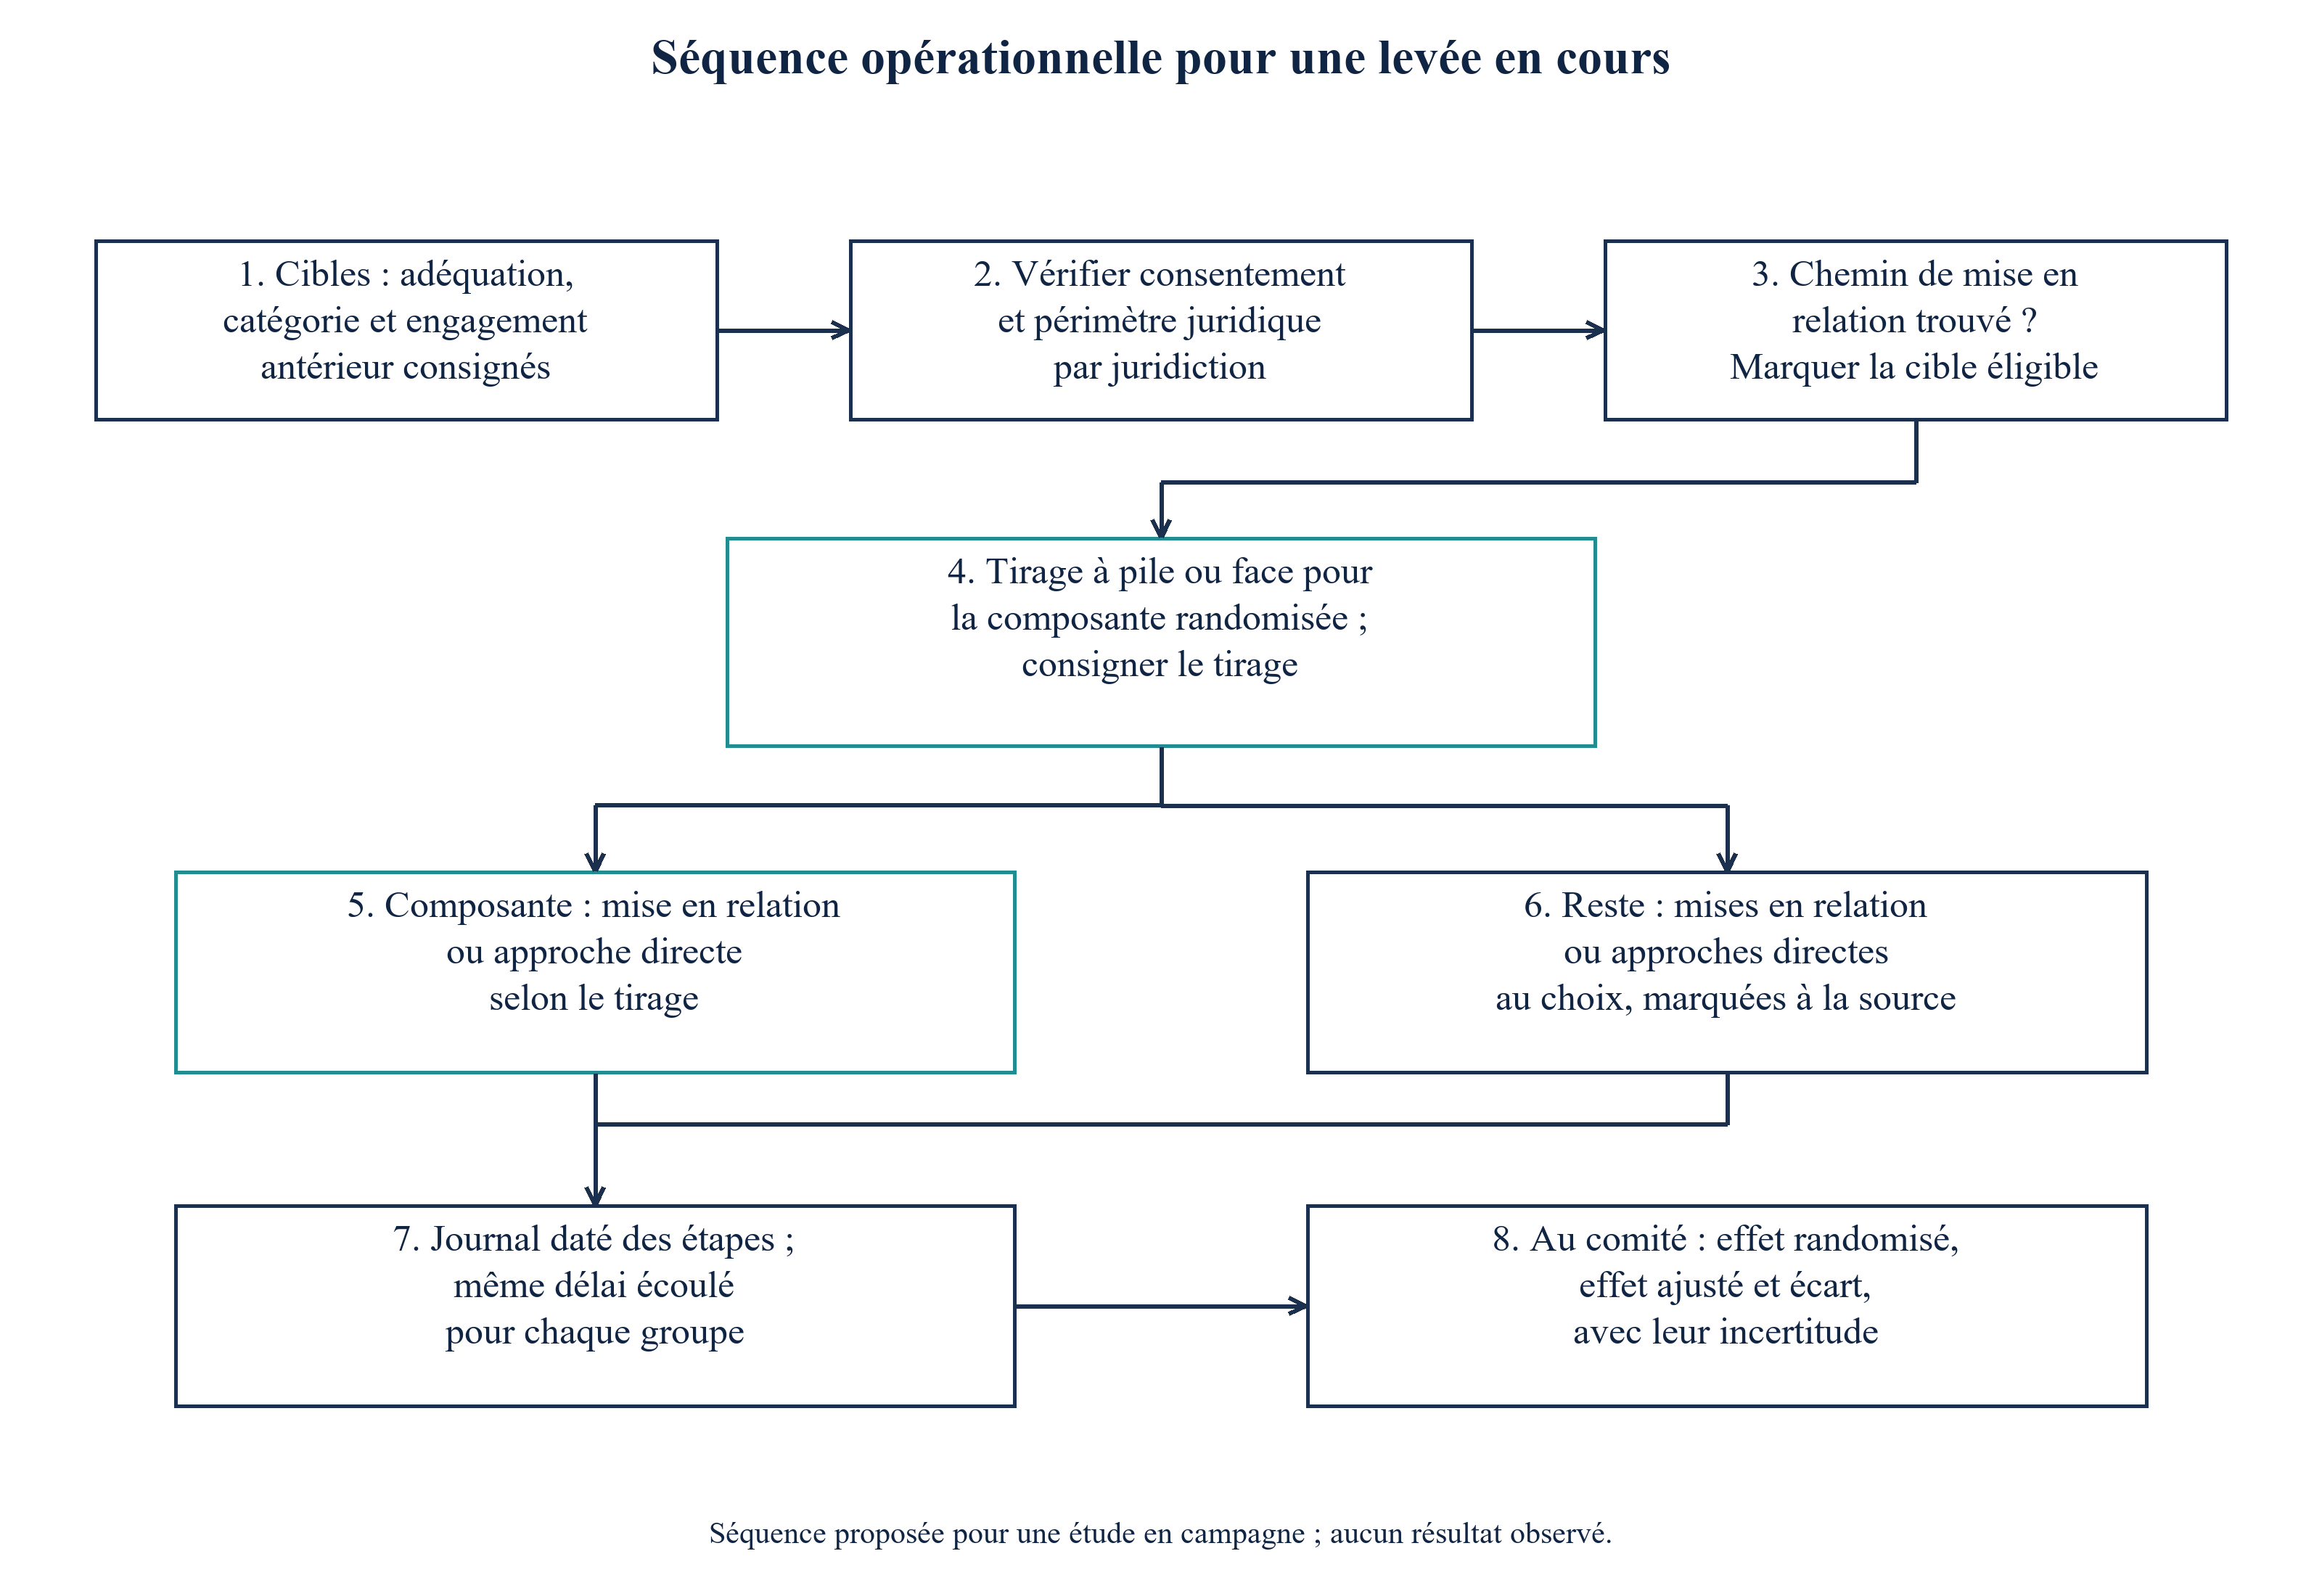
Faites défiler horizontalement pour lire la figure en taille réelle. Vous pouvez aussi ouvrir sa version en taille réelle.
Analyse MatchPoint. Séquence proposée pour une étude au sein d’une campagne en cours ; aucun résultat observé.
| Condition | Action | Élément déclencheur |
|---|---|---|
| Sous les taux choisis et avec environ 500 cibles éligibles indépendantes | Évaluer la puissance et l’incertitude propres à chaque résultat ; les estimations tardives peuvent rester imprécises | Taille d’échantillon de l’équation 6 |
| Estimations ajustée et randomisée concordantes dans l’intervalle | Évaluer l’incertitude et l’identification pour chaque résultat ; ne pas valider l’ajustement tardif sur la seule concordance initiale | Estimations et intervalles propres à chaque résultat, diagnostic d’équilibre et hypothèses d’identification justifiées |
| L’estimation ajustée dépasse largement l’estimation randomisée | Ne pas planifier à partir des estimations ajustées ; agrandir la composante randomisée | Écart et équilibre de l’engagement |
| Mises en relation peu nombreuses | Les affecter là où la composante indique l’effet le plus élevé par mise en relation | Estimations par cellule regroupées entre mandats |
| Intermédiaire rémunéré | Examiner les règles applicables aux activités, aux promotions et à la rémunération avant une approche ; vérifier intégralement toute exemption | Sources relatives à la rémunération des intermédiaires |
| Résultats d’étape regroupés entre mandats | Utiliser des résultats communs et évaluer l’hétérogénéité des mandats, les cibles récurrentes et les regroupements de cibles dans l’analyse commune | Étapes et délais communs |
Règle proposée. Le responsable fixe les seuils à l’avance ; aucun ne constitue un résultat.
Le tableau 14 expose la règle. Celle-ci a un coût. Une composante de 25 % signifie qu’un quart des cibles éligibles sont affectées à pile ou face plutôt que selon le jugement du responsable. L’expérience montre le biais que cette composante évite et que les estimateurs ajustés conservent dans la grille de tailles de campagne testée pour le scénario de base, sans chiffrer ce coût. L’opportunité de l’assumer pour un responsable donné dépend du nombre de mises en relation dont il dispose et du nombre de mandats qu’il peut regrouper ; ces faits sont connus du responsable, pas de cet article.
24 Limites et décision suivante : remplacer les effets choisis par une composante randomisée consignée
L’expérience est construite. Ses taux de progression, tailles d’effet, intensité de proximité relationnelle latente et coefficient de chargement de l’indicateur indirect sont choisis ; ses conclusions sur le sens du biais découlent de l’hypothèse selon laquelle les intermédiaires utilisent une proximité relationnelle absente des dossiers. La population comporte une variable latente et un indicateur indirect ; une campagne réelle en comporte plusieurs. Les effets sont égaux sur l’échelle des log-cotes, ce qui détermine le profil de la matrice de scores. Les cibles n’exercent pas d’influence les unes sur les autres, alors que des investisseurs appartenant à un même syndicat ou réseau peuvent s’influencer. Aucune source examinée ne mesure la fréquence ou l’effet des mises en relation parmi les investisseurs du Golfe.
Les sources ont leurs propres limites. L’enquête auprès des investisseurs en capital-risque est un document de travail et décrit l’origination des opérations, plutôt que les résultats après une même approche. Les expériences sur les recommandations concernent le travail ; les expériences de présentation aux investisseurs s’arrêtent à la première réponse et portent sur des courriels à froid. Les textes du Golfe sur la protection des données n’ont pas été lus, à l’exception des orientations de l’ADGM et d’un résumé sur un portail gouvernemental ; les recueils réglementaires des régulateurs sur la commercialisation n’ont pas été examinés au-delà d’une alerte publique de la DFSA. Chacun de ces éléments limite les usages possibles du cadre.
La décision qui en découle est précise. Un responsable disposant de mises en relation à mobiliser devrait commencer la campagne suivante par une composante consignée aux étapes précoces, avec marquage des mises en relation et enregistrement de l’engagement antérieur au contact tout au long de la campagne. Sous les hypothèses choisies de cibles indépendantes, les tailles approximatives du dispositif sont de 496 cibles au total pour les réponses et de 896 pour les entretiens qualifiés, avec des échantillons plus grands pour les résultats tardifs. Les études réelles exigent une évaluation de l’incertitude, du suivi et du regroupement propre à chaque résultat. Les écarts bruts et ajustés peuvent être supérieurs ou inférieurs à l’effet causal ; le scénario de classification erronée place lui-même l’estimation ajustée de réponse en dessous de cet effet. Ces écarts doivent être interprétés comme des associations sauf si les hypothèses d’identification sont justifiées. Les résumés descriptifs de sensibilité par regroupements de la section 14 ne fournissent pas de bornes supérieures certifiées.
Le lecteur devrait aussi noter les sujets laissés de côté. L’article ne classe pas les investisseurs, question distincte de celle de savoir si une mise en relation change leur progression, et ne chiffre pas le prix d’une mise en relation. Il la traite comme un ensemble unique, sans séparer les informations apportées par une recommandation de l’accès qu’elle procure. Il ne modélise pas les incitations de l’intermédiaire, dont les conditions de rémunération de la section 7 suggèrent qu’elles peuvent compter. Chacun de ces sujets pourrait faire l’objet de l’étude suivante, une fois qu’une composante consignée existe.
Références
- Gompers, P., Gornall, W., Kaplan, S. N. and Strebulaev, I. A. How Do Venture Capitalists Make Decisions? NBER Working Paper 22587, September 2016, section 3.1 and Tables 5 and 6. Working paper; later published in a journal, published version not reviewed. https://www.nber.org/system/files/working_papers/w22587/w22587.pdf
- Shane, S. and Cable, D. Network Ties, Reputation, and the Financing of New Ventures. Management Science 48(3), March 2002, pp. 364-381. Bibliographic record and abstract only. https://ideas.repec.org/a/inm/ormnsc/v48y2002i3p364-381.html
- Pallais, A. and Sands, E. G. Why the Referential Treatment? Evidence from Field Experiments on Referrals. NBER Working Paper 21357, July 2015; published in the Journal of Political Economy 124(6), 2016. Working paper text read; published version not reviewed. https://www.nber.org/system/files/working_papers/w21357/w21357.pdf
- Gornall, W. and Strebulaev, I. A. Gender, Race, and Entrepreneurship: A Randomized Field Experiment on Venture Capitalists and Angels. Management Science 71(6), June 2025, pp. 5308-5327. Published abstract read; full text read in the August 2019 working-paper version (AEA 2020 conference copy). https://ideas.repec.org/a/inm/ormnsc/v71y2025i6p5308-5327.html
- Zhang, Y. Discrimination in the Venture Capital Industry: Evidence from Two Randomized Controlled Trials. arXiv 2010.16084, version dated 14 March 2022. Working paper; read in part (introduction, design notes, footnotes). https://arxiv.org/pdf/2010.16084v1
- Austin, P. C. An Introduction to Propensity Score Methods for Reducing the Effects of Confounding in Observational Studies. Multivariate Behavioral Research 46(3), 2011, pp. 399-424. Open-access text on PubMed Central. https://pmc.ncbi.nlm.nih.gov/articles/PMC3144483/
- VanderWeele, T. J. and Ding, P. Sensitivity Analysis in Observational Research: Introducing the E-Value. Annals of Internal Medicine 167(4), 2017, pp. 268-274. Author manuscript, including appendix on non-null E-values. https://dash.harvard.edu/server/api/core/bitstreams/7312037e-0f45-6bd4-e053-0100007fdf3b/content
- U.S. Securities and Exchange Commission, Division of Corporation Finance. Securities Act Rules, Corporation Finance Interpretations, Questions 256.26 to 256.32; individual interpretation dates 6 August 2015 and 12 March 2025. Staff interpretations; accessed 16 November 2026. https://www.sec.gov/rules-regulations/staff-guidance/corporation-finance-interpretations/securities-act-rules
- United Kingdom. The Financial Services and Markets Act 2000 (Financial Promotion) Order 2005, SI 2005/1529, Article 15. Official revised XML, including paragraph 1A and paragraph 2; accessed 16 November 2026. https://www.legislation.gov.uk/uksi/2005/1529/article/15/data.xml
- European Union. Regulation (EU) 2016/679 (General Data Protection Regulation), Articles 4, 7 and 21. Official Journal L 119, 4 May 2016. https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32016R0679
- Abu Dhabi Global Market, Office of Data Protection. Lawful Bases for Processing Personal Data and Special Categories of Personal Data. Guidance brochure, May 2025. Regulator guidance, not the text of the Regulations. https://assets.adgm.com/download/assets/ADGM+Lawfulness+of+Processing+Brochure.pdf/643e101658a711ef9ce5e27828504259
- United Arab Emirates Government Portal. Data protection laws: summary of Federal Decree Law No. 45 of 2021. Official summary accessed 16 November 2026; the full statute was not reviewed. https://u.ae/en/about-the-uae/digital-uae/data/data-protection-laws
- Mubadala. Contact us, section on spam and potentially improper conduct. Company page accessed 16 November 2026; the cited passage is a fraud warning. https://www.mubadala.com/en/contact-us
- Dubai Financial Services Authority. Unauthorised Business in the DIFC. Alert, 1 June 2023, describing Articles 41 and 41A of the Regulatory Law 2004. Regulator alert, not the Rulebook text. https://www.dfsa.ae/alerts/unauthorised-business-difc
À propos de l'auteur
Chennakeshav (CK) est un dirigeant de la finance d'entreprise et de la banque d'affaires disposant de plus de 25 ans d'expérience internationale en origination, structuration et exécution d'opérations de M&A, de capital-développement et de stratégie d'entreprise. Il a piloté des missions de création de valeur pour des fondateurs, des entreprises et des fonds, reliant la vision du conseil d'administration à l'exécution opérationnelle et à la réalisation des transactions.
Son parcours comprend Morgan Stanley, HSBC, Lloyds Banking Group, EWEC, des sociétés du portefeuille d'ADQ et Emirates Growth Fund, dans les secteurs TMT, immobilier, fintech, deeptech, cleantech, infrastructures et énergie. Il a travaillé avec des dirigeants, des fonds de private equity et de venture capital, des fonds souverains et des family offices pour financer des levées de fonds complexes et des entreprises en phase de croissance. Il a également dirigé des diligences M&A, des intégrations post-acquisition et des initiatives de transformation d'entreprise créatrices de valeur.
Chez Matchpoint Partners, il est Associé gérant et dirige les activités de finance d'entreprise, de M&A et de levée de capitaux du cabinet. Il est titulaire d'un MBA de London Business School, d'un diplôme en ingénierie de VTU et prépare un Master of Laws, LLM, à UCL London.
Actif dans l'accompagnement des start-up, CK intervient comme mentor auprès de Techstars, DIFC FinTech Hive, Startup Grind, Founder Institute et IN5. Il est Entrepreneur Mentor in Residence, EMiR, à London Business School et membre du jury de l'Entrepreneurship World Cup.
https://www.linkedin.com/in/ckadya/
https://www.matchpoint-partners.com/team/ck-adya.html
Avertissement
Cet article fait partie d'une série consacrée à la structure des marchés privés et alternatifs. Les opinions exprimées sont celles de l'auteur. Le document est fourni uniquement à titre d'information, décrit la structure des marchés en termes généraux et ne constitue ni un conseil d'investissement, juridique, fiscal ou réglementaire, ni une recommandation concernant un titre, un véhicule ou une contrepartie.
